


ROMA:オープンソースのメタエージェントの中核骨格
著者:Sentient China 華語
ROMA(Recursive Open Meta-Agent)の紹介
ROMA(再帰的オープンソースメタエージェント)は、高性能なマルチエージェントシステムを構築するためのオープンソースのメタエージェントフレームワークです。複数のシンプルなエージェントとツールを協調させることで、複雑な問題を共同で解決します。
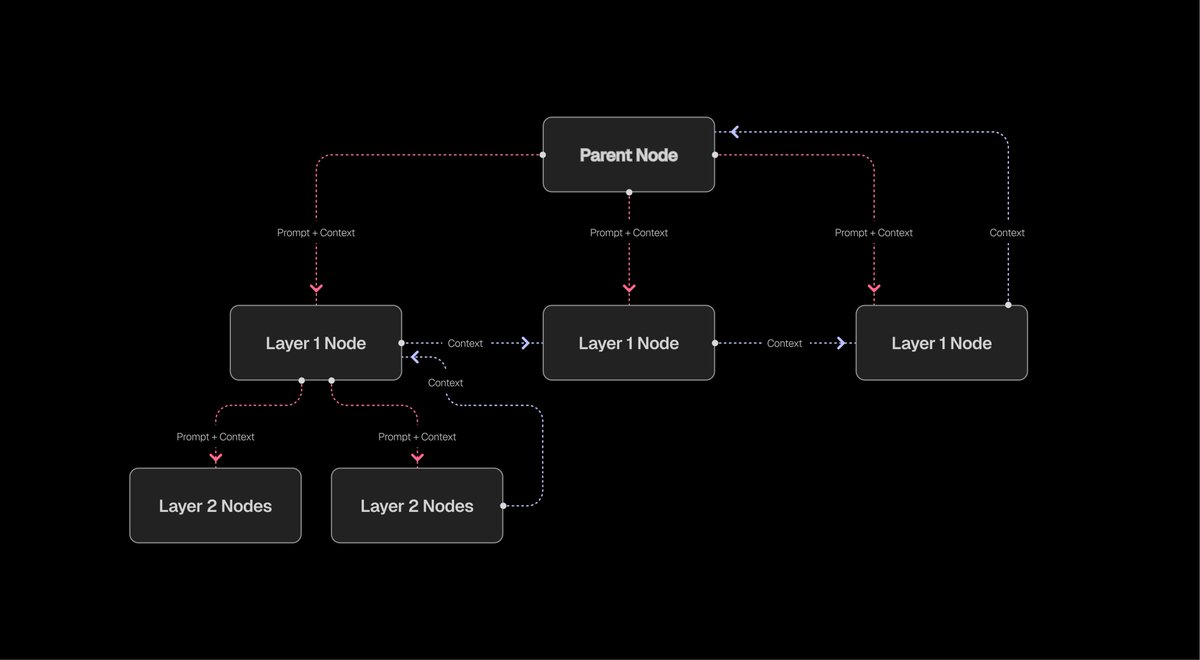
ROMAの核となるのは、マルチエージェントシステム向けに設計された階層的再帰的タスクツリー(hierarchical recursive task tree)という構造です。
この体系では、ルートノードが複雑な目標を複数のサブタスクに分解し、コンテキストを子ノードに渡して実行させます。サブタスクが完了すると、結果は上位のノードに集約されます。このコンテキストフロー機構により、ROMAは中長期的かつ多段階のタスクを処理できるエージェントの構築を簡単かつ信頼性高く実現しています。
具体例
たとえば、ロサンゼルスとニューヨークの気候差異についてのレポート作成をエージェントに依頼するとします。
ROMAでは:
-
最上位のルートノードがタスクを以下のサブタスクに分割します:
サブタスク1:ロサンゼルスの気候を調査する。
サブタスク2:ニューヨークの気候を調査する。
-
各サブタスクは、AI検索モデルや天気APIなど、専用のエージェントやツールを呼び出せます。
-
両方の調査が完了後、ルートノードは「比較分析」タスクを生成し、結果を集約して完成したレポートを作成します。
この構造により、システム内のタスク分解と結果統合が一目瞭然になります。
ROMAの利点
ROMAは、マルチエージェントシステムの構築をより直接的かつ透明なものにします。
-
Pydanticによる入出力の構造化により、コンテキストの流れが明確でトレーサブルになります;
-
開発者は推論プロセスを正確に観察でき、デバッグやプロンプトの最適化、エージェントの交換が容易になります;
-
システムの透明性により、「コンテキストエンジニアリング」をブラックボックスではなく、迅速に反復可能にできます;
-
モジュール設計により、任意のノードにエージェント、ツール、モデル(LLMベースの専用エージェントや「人間によるレビュー」も含む)を挿入できます;
-
ツリーアーキテクチャは並列処理を自然にサポートし、柔軟性と高性能を両立し、大規模で複雑なタスクに適しています。
パフォーマンス検証:ROMA Search
フレームワークの有効性を検証するため、SentientはROMA Search——ROMAアーキテクチャに基づくネット検索エージェント(特定ドメイン最適化なし)——を構築しました。
SEALQAベンチマークの中で最も難しいサブセットSeal-0(複雑な多情報源推論を評価)において、ROMA Searchは45.6%の正解率を達成し、新記録を樹立しました。
-
前トップのKimi Researcher(36%)を上回りました;
-
Gemini 2.5 Pro(19.8%)のおよそ2倍の性能です;
-
オープンソースモデルでは、Sentient自らが開発したOpen Deep Search(8.9%)を大きく凌駕しています。
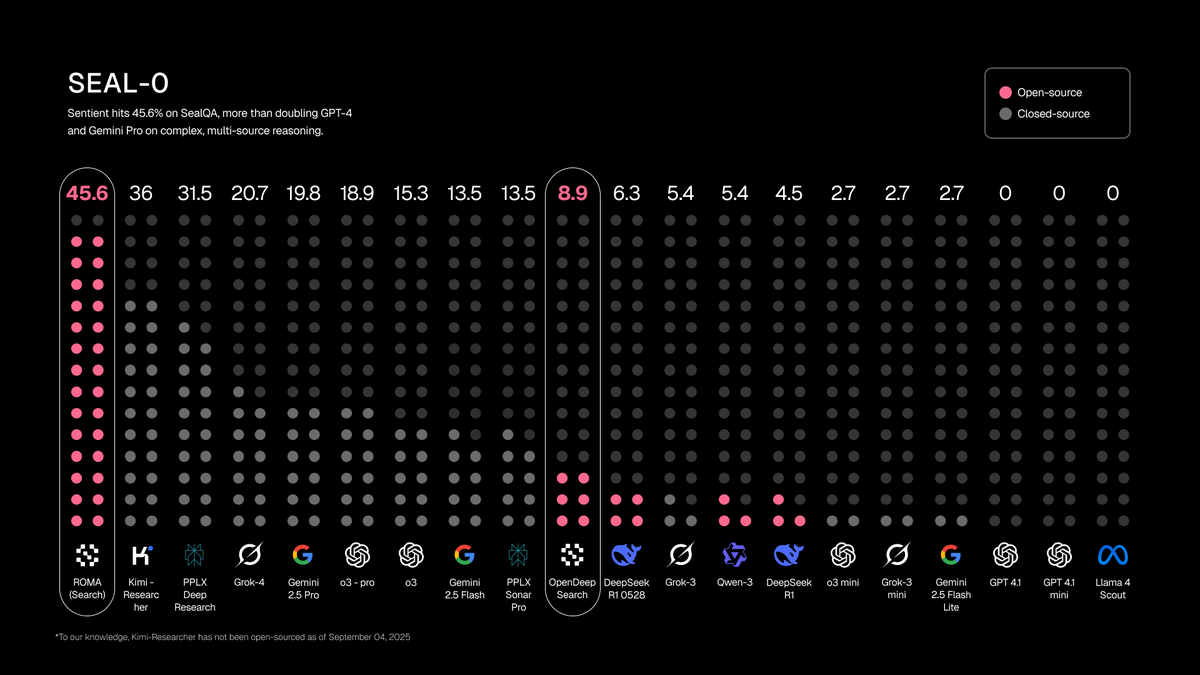
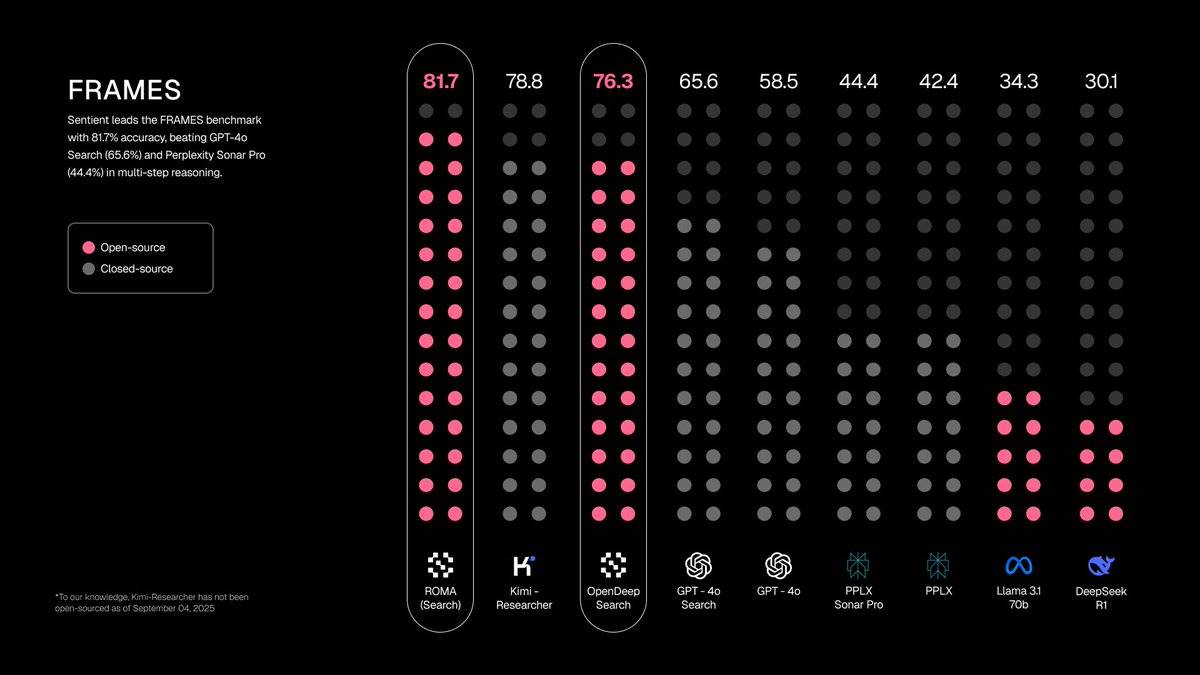
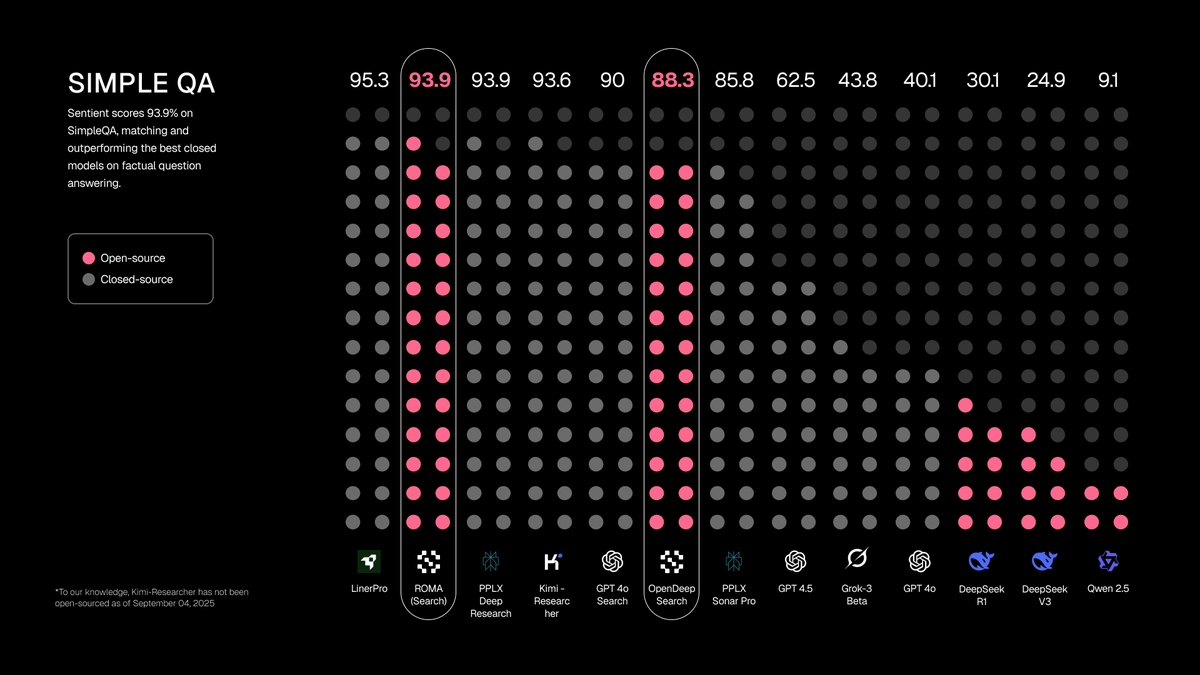
さらに、ROMA SearchはFRAMES(多段階推論)で業界最高レベル、SimpleQA(事実検索)でもトップクラスに近く、タスク横断的な汎用性の高さを示しています。
ROMAの開放性と拡張性
ROMAは完全にオープンソースであり、非常に高い拡張性を持っています。
検索はあくまで始まりにすぎず、誰でも:
-
新しいエージェントを追加できます;
-
カスタムツールでフレームワークを拡張できます;
-
金融分析、研究レポート、クリエイティブコンテンツ生成などの分野にROMAを応用できます。
ROMAは堅牢な中枢骨格を提供しており、真の飛躍はコミュニティがその上に築くエコシステムから生まれます。
なぜ「長距離タスク」がエージェントにとって難しいのか
AIは単一ステップのタスク(要約、メール作成、算数など)では顕著な進歩を遂げていますが、「長距離タスク」——つまり多段階の推論と連続的な行動を必要とするタスク——に対しては依然として脆弱です。
根本的な課題は「誤差の累積」にあります。
あるモデルの単一ステップの成功率が99%であっても、10段階連続で正確に実行する必要がある場合、全体の成功率は急激に低下します。1回のハルシネーション、誤読、あるいはコンテキストの喪失が、システム全体の崩壊につながる可能性があります。
そのため、複数のサブタスクを安定して処理し、複数情報源を横断して推論を行うシステムの構築は極めて困難です。
この問題を解決するには、次の2つの課題を克服しなければなりません:
-
アーキテクチャ層(Meta-Challenge):誤差が累積しても、長距離推論を確実に実行できるシステムをどう設計するか?
-
タスク層(Task-Specific Challenge):具体的な目的に対し、最適なタスク分解方法、ツール、モデル、プロンプト、検証ステップをどう決定するか?
検索タスクはまさに理想的なケースです:
これは本質的に多段階(検索 → 閲覧 → 抽出 → 交差検証 → 総合)であり、リアルタイムで複雑な外部知識に依存します。
たとえば、「制作費が3.5億ドル以上の映画のうち、当年の興行収入1位でないものは何本あるか?」という問い。
この質問に答えるには、エージェントは以下を行う必要があります:
-
問題を分解(高予算映画を特定 → 各年の興行収入1位を特定);
-
複数の情報源から最新データを取得;
-
結果に対して論理的推論を行う;
-
最終的な答えを総合する。
このプロセスでは、ハルシネーション、誤一致、無限ループなどが失敗を招く原因となり得ます。従来のエージェントアーキテクチャは内部の推論経路を隠蔽しがちで、チューニングや改善が非常に困難でした。
ROMAの解決策
ROMAは再帰的・階層的なシステム構造を提供することで、長距離タスクの課題に対処します。
各タスクは「ノード」となります:
-
直接実行可能;
-
サブタスクに分解可能;
-
サブ結果を統合可能。
ツリー構造により、コンテキストの流れが透明かつ追跡可能になり、階層ごとの最適化も容易になります。
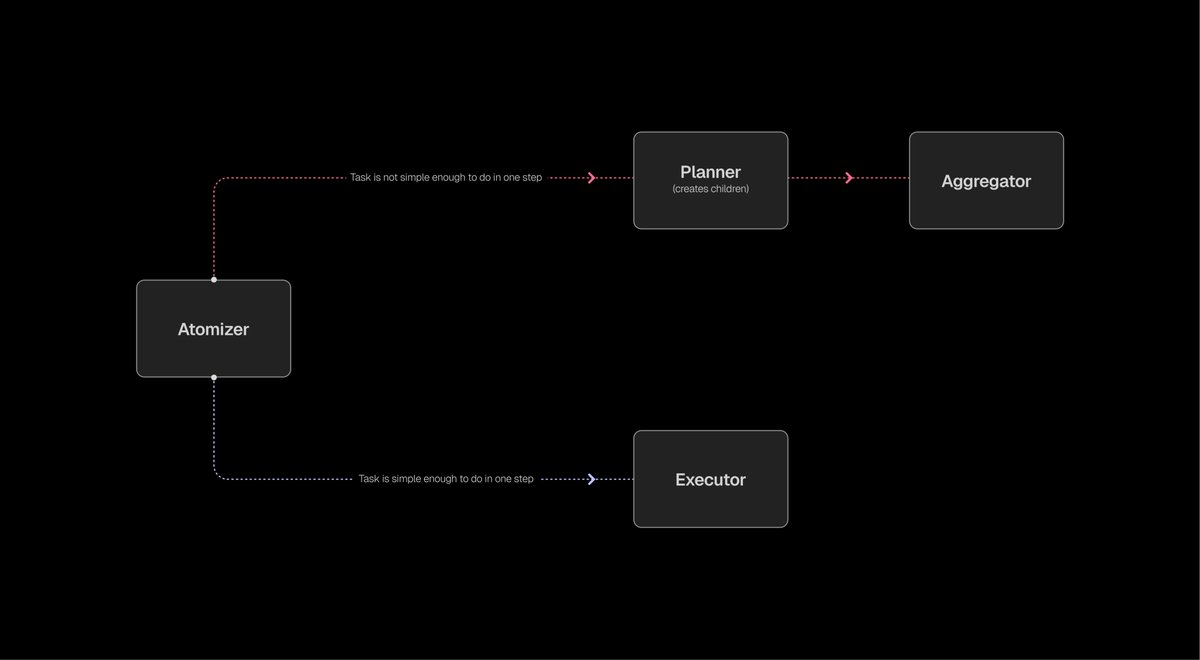
この骨格の上に、開発者は各ノードに対して適切なツール、プロンプト、検証機構を選択するだけで、堅牢なマルチエージェントシステムを構築できます。
ROMAの実行フロー(ROMA Searchを例に)
1️⃣ Atomizer(アナライザー)――タスクの複雑度を判断
システムは主タスクから開始し、そのタスクが単一エージェントで完結するか、またはさらに分解が必要かを判断します。
2️⃣ Planner(プランナー)――サブタスクに分解
タスクが複雑な場合、ノードはプランナーとなり、目標をより小さなタスクに分解します。たとえば:
-
制作費 ≥ 3.5億ドルの映画を検索;
-
対象年次における興行収入1位の映画を検索;
-
条件に合致する映画リストを分析・生成。
各サブタスクは子ノードを生成し、ノード間は依存関係を持つこともあれば、並列実行されることもあります。
3️⃣ Executor(エグゼキューター)――サブタスクを実行
あるサブタスクが十分に単純であれば、ノードはエグゼキューターとなり、対応するツールやモデル(検索API、情報抽出モデルなど)を呼び出し、出力を次のノードに渡します。
4️⃣ Aggregator(アグリゲーター)――結果を統合
すべてのエグゼキューターの実行が完了すると、ルートノードはアグリゲーターとなり、結果を集約し、一貫性を検証して最終的な答えを生成します。
ヒューマンインザループ(Human-in-the-Loop)とステージトラシング(Stage Tracing)
任意のノードで、人間が事実の検証やコンテキストの補足を行えます。
ROMAは計画段階でユーザーにサブタスクの確認を求めることもでき、初期の誤解を回避できます。
人間の介入がなくても、ステージトラシングシステムにより各ノードの入出力が完全に記録され、開発者がエラーを迅速に特定し、論理を最適化できるようになります。
ROMAの拡張性
上記の例は単層のタスク分解のみを示しています。
実際の応用では、ROMAは再帰的に複数層を形成し、深いタスクツリーを構築できます。
サブタスク間が独立している場合、システムは自動的に並列実行を行い、数百乃至数千ノードの効率的な計算を実現します。
AIエージェントの未来に参加する準備はできていますか?
ROMA Searchはあくまでスタート地点です。
私たちはすでにROMAを完全にオープンソース化し、世界中の開発者と共に探求することを呼びかけています。
-
開発者(Builders):ROMA上でエージェントを構築し、モデルを交換したり、マルチモーダル機能をテストしたり、漫画やポッドキャストといった生成系コンテンツ、あるいは研究レポートのような分析系タスクを作成してみてください。
-
研究者(Researchers):ROMAを基盤にメタエージェントアーキテクチャの研究を進めましょう。その透明なステージトラシング機構は、エージェント間の相互作用やコンテキストフローに関する独自の洞察を提供します。
専有システムの進歩は単一企業に依存しますが、ROMAの進化はオープンソースコミュニティ全体の集合的知性から生まれます。
今すぐROMAに参加しましょう:
GitHubリポジトリ:
https://github.com/sentient-agi/ROMA
ビデオ紹介:
https://youtu.be/ghoYOq1bSE4?feature=shared
参考文献:
¹https://arxiv.org/pdf/2506.01062
²https://moonshotai.github.io/Kimi-Researcher/
TechFlow公式コミュニティへようこそ
Telegram購読グループ:https://t.me/TechFlowDaily
Twitter公式アカウント:https://x.com/TechFlowPost
Twitter英語アカウント:https://x.com/BlockFlow_News
 @sentient_zh
















