Chạy điểm tăng vọt, thực chiến thất bại, GPT-6.2 vừa ra mắt đã phơi bày điểm yếu của OpenAI
Tác giả: Vua Techno, GeekPark
Sự phân mảnh giữa thành tích trên giấy tờ và trải nghiệm thực tế đã đạt đến đỉnh điểm ngày hôm nay.
"Cơ bản là không dùng được, không khuyến nghị".
Chỉ 8 phút sau khi mô hình mới của OpenAI chính thức hoạt động, nhà sáng lập nổi tiếng ở Thung lũng Silicon Matt Shumer đã buông một lời nhận xét không khoan nhượng trên nền tảng mạng xã hội.
Kế tiếp, tác giả với đông đảo người hâm mộ là Theo Browne đã đăng tải một bài viết dài mang tên “Tại sao tôi ghét GPT-6.2 Astra”. Giáo sư trường kinh doanh Wharton Ethan Mollick, vốn thường giữ thái độ ôn hòa và kiên nhẫn với các mô hình tiên phong, sau khi thử nghiệm cũng đưa ra đánh giá nghiêm khắc hiếm có: “rất không ổn định và kỳ quái”, thẳng thắn tuyên bố đây là “lần phát hành mô hình tiên tiến đầu tiên của OpenAI từ sau GPT-4.5 mà chưa thấy sự tiến bộ rõ rệt”.
Vốn dĩ đây đáng lẽ là một trận phản công đẹp đẽ của OpenAI.
Vào lúc 0 giờ sáng ngày 18 tháng 11 theo giờ Bắc Kinh, OpenAI chính thức tung ra thế hệ flagship mới GPT-6.2 Astra cùng dòng chủ lực dùng hàng ngày GPT-6.2 Sol. Hãng trực tiếp cắt giảm 20% đơn giá API của Astra, đồng thời nộp bảng thành tích toàn diện phá vỡ mọi kỷ lục từ tác nhân thông minh đến nghiên cứu khoa học.
Khi tốc độ tăng vọt của các bài kiểm tra định lượng va phải làn sóng phàn nàn tập thể từ những lập trình viên tuyến đầu, cảm giác phân cực tột độ này chính là bức tranh chân thực nhất về tình huống khó khăn hiện tại của OpenAI.
Các trò chơi con số và đòn tấn công ngầm về năng lực tính toán
Nhìn riêng vào áp phích chính thức và dữ liệu dẫn đầu của các bảng xếp hạng tổng hợp bên thứ ba, hai mô hình GPT-6.2 quả thực rất sắc bén.
Cả hai mô hình đều được trang bị cửa sổ ngữ cảnh 1,05 triệu, giới hạn đầu vào 922.000 tokens, giới hạn đầu ra 128.000 tokens, hiện chỉ hỗ trợ đầu vào văn bản và hình ảnh, đầu ra thuần văn bản, không hỗ trợ âm thanh video và tinh chỉnh vi mô. Về giá cả, thế hệ flagship mới kế nhiệm GPT-6 Astra của đầu tháng 9 được định mức 8 USD cho mỗi triệu token đầu vào và 40 USD cho đầu ra, trong đó đầu vào bộ nhớ đệm bị cắt sâu tới 60% xuống còn 0,40 USD; GPT-6.2 Sol thay thế phiên bản DevDay tháng 9 duy trì mức giá cố định là 2 USD đầu vào và 10 USD đầu ra.
Trong bảng xếp hạng chỉ số tổng hợp v5.0.1 của Artificial Analysis, GPT-6.2 Astra leo lên vị trí thứ hai tổng bảng với 62 điểm, đứng sau Claude Fable 5.2 với 65 điểm, và vượt qua Gemini 4 Carbon (60 điểm) cùng Claude Opus 5.5 (59 điểm).
Mắc hơn nữa là chi phí cho từng tác vụ duy nhất, mức chi tiêu trung bình của Astra chỉ 4 USD, tương đương 15% so với mức 26,54 USD đắt đỏ của Fable 5.2. Sol giành được 57 điểm chỉ tốn 1,01 USD cho một tác vụ duy nhất, vững vàng nằm gọn trong góc phần tư phía trên bên trái biểu đồ tán xạ đường biên Pareto – khu vực có tỷ suất lợi ích cao nhất.
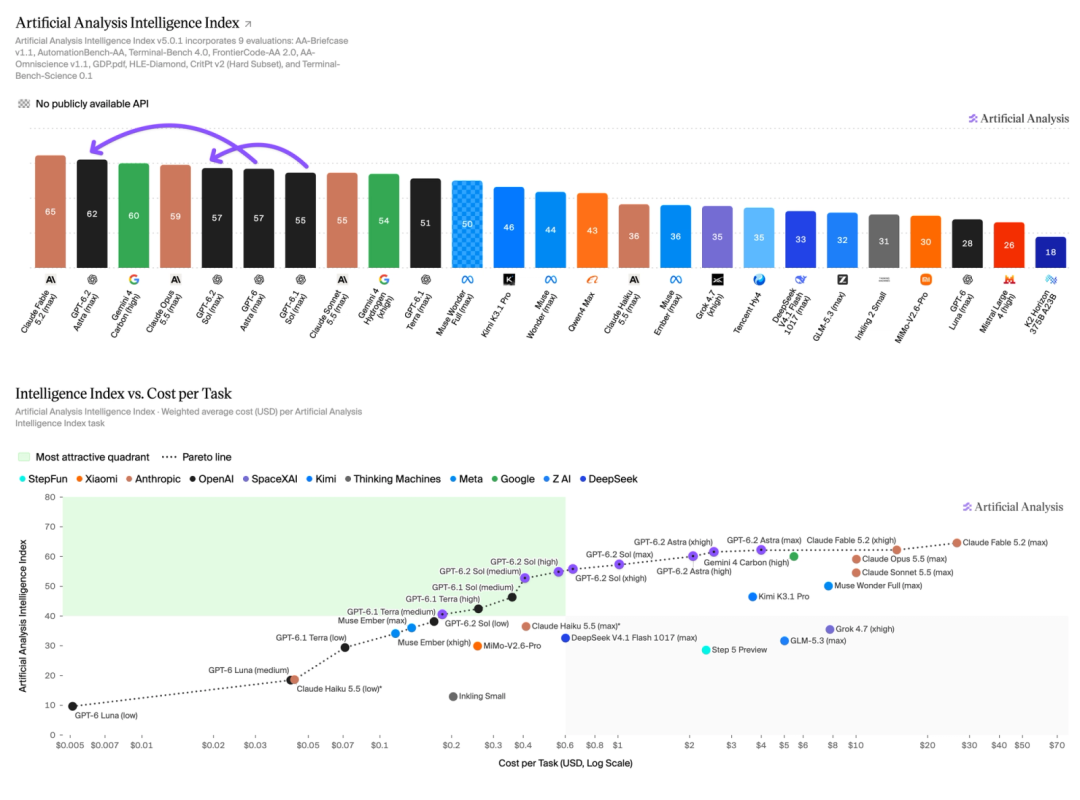
So sánh bảng xếp hạng tổng điểm và đường biên Pareto chi phí tác vụ duy nhất của Artificial Analysis Intelligence Index v5.0.1 | Nguồn ảnh: Artificial Analysis
Nhưng chỉ cần cuộn chuột xuống blog chính thức, đọc kỹ những chú thích nhỏ xíu ở cuối trang, vị đắng bắt đầu lộ rõ.
Trong bài kiểm tra Agents' Last Exam, OpenAI hào hứng tuyên bố Astra đạt kết quả cao nhất 78,3% (chế độ XHigh, chế độ Max là 77,6%), dẫn trước Fable 5.2 với 72,8% một khoảng cách lớn. Nhưng trong chú thích nhỏ lại thầm ghi rằng, so sánh này loại trừ 9 nhiệm vụ mà Fable 5.2 sử dụng mô hình dự phòng. Tinh tế hơn, trong hình ảnh chính thức, Gemini 4 Carbon của Google đã đạt 77,4% ở chế độ suy luận cao cấp với chi phí tác vụ duy nhất là 4,60 USD, gần ngang bằng với 4,47 USD của Astra, nhưng văn bản chính thức của hãng lại tuyệt đối im lặng về đối thủ này.
Bên cạnh việc lọc chọn lọc bài kiểm tra định lượng, bảng giá API còn giấu hai quả mìn ngầm.
Chỉ cần lần nhập liệu vượt quá 272.000 tokens, đơn giá đầu vào và bộ nhớ đệm của toàn bộ yêu cầu sẽ tăng gấp đôi, đơn giá đầu ra nhân 1,5 lần, khiến Astra nhảy thẳng lên 16 USD và 60 USD. Đồng thời, chế độ Ultrafast giới hạn lưu trữ dữ liệu khu vực Mỹ, tối đa tăng tốc độ 4,5 lần hiện đang được quảng cáo với mức giá gấp 3 lần, nhưng từ ngày 1 tháng 3 năm 2027 sẽ tăng gấp đôi lên 6 lần, lúc đó mức giá đầu vào và đầu ra của Astra sẽ lên tới 48 USD và 240 USD.
Lái mắt sang bảng xếp hạng chuyên biệt quyết định trải nghiệm hàng ngày của lập trình viên, điểm yếu càng lộ rõ hơn.
Trong bảng xếp hạng tác nhân lập trình của Artificial Analysis, GPT-6.2 Astra mắc kẹt ở mốc 53 điểm không tiến thêm được bước nào, ngang bằng thế hệ trước, thua kém Claude Fable 5.2 và Opus 5.5 với 58 điểm, cũng như thua xa Gemini 4 Carbon với 55 điểm. Dòng Sol thiên về khối lượng hàng ngày thậm chí lùi 3 điểm xuống 49 điểm, trượt trở lại vị trí ngang bằng với dự án mã nguồn mở Kimi K3.1 Pro, trong đó hạng mục hỏi đáp kho mã code sụt giảm 14 điểm, rất dễ bỏ sót các sự kiện then chốt.
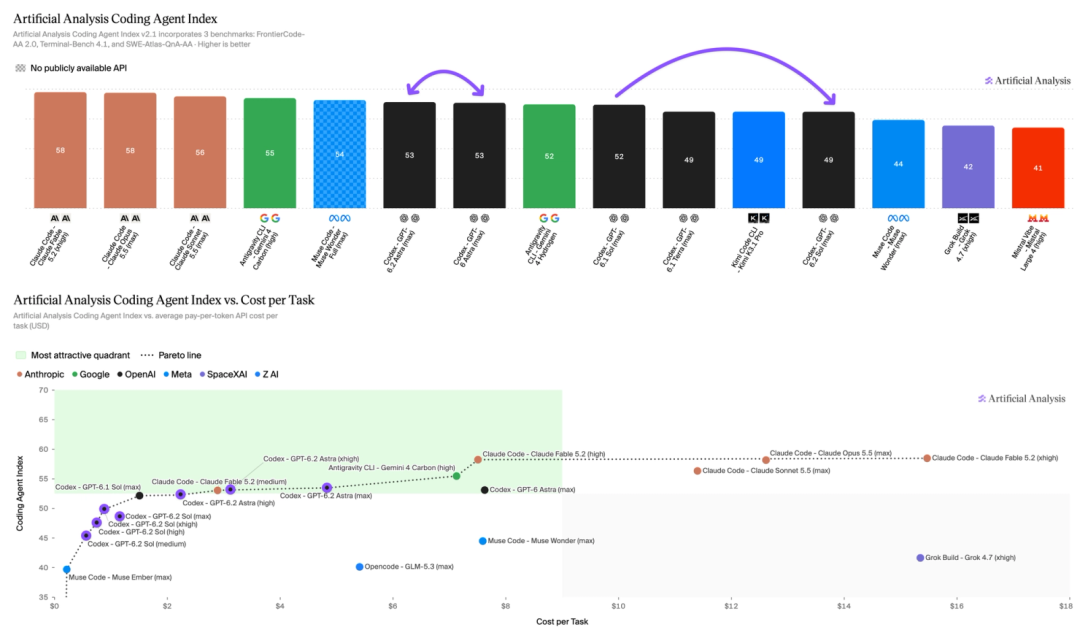
So sánh Chỉ số Tác nhân Lập trình v2.1 của Artificial Analysis: Astra dừng lại ở 53 điểm, Sol lùi 3 điểm so với thế hệ trước | Nguồn ảnh: Artificial Analysis
Trong thử nghiệm của cơ quan uy tín thứ hai Epoch AI, dù Astra giải được 7 trong số 68 bài toán toán học tiên phong của Erdős, phá vỡ kỷ lục trước đó là 3 bài, báo cáo vẫn chỉ trích nó không có tiến bộ rõ rệt so với thế hệ trước trong các nhiệm vụ tự động hóa nghiên cứu khoa học thực tế, và quá bảo thủ. Trong bảng xếp hạng tổng hợp Vals, Astra chỉ đứng thứ 7, phiên bản phổ thông thậm chí tụt xuống hạng 30 trong truy vấn pháp lý, bắt buộc phải dựa vào phiên bản pháp lý tùy chỉnh chuyên biệt mới gỡ lại thể diện.
Chỉ khi tắt hoàn toàn tường lửa an ninh để đào bới lỗ hổng ở giới hạn cuối cùng, nó mới bộc lộ tiềm năng đáng sợ.
DeepBinary lấy 12 tệp nhị phân hệ thống Windows để thử nghiệm, Astra khai quật trung bình 348,5 lỗ hổng độc lập qua hai lần chạy riêng biệt, định giá lên tới 1,038 triệu USD theo tiêu chuẩn tiền thưởng của Microsoft, trong khi chi phí API chỉ 4.072 USD; mô hình nhỏ Sol cũng với chi phí 840 USD đã tìm ra 227 lỗ hổng định giá 687.000 USD, bỏ xa Opus 5 và Kimi K3.1 với mức định giá quanh 160.000 USD.
Thiên tài lệch môn
Tại sao một mô hình có thể tự tay khai quật lỗ hổng hệ thống trị giá hàng triệu USD, lại trở thành "cơ bản không dùng được" khi trao vào tay những lập trình viên phổ thông? Lật lại hồ sơ thực chiến từ người dùng mạng, bạn sẽ thấy một thiên tài bị lệch pha nghiêm trọng.
Bất cứ khi nào giao cho nó các đề bài cứng nhắc với ranh giới rõ ràng, thiên về hình học không gian hoặc mô phỏng vật lý, ngưỡng khả năng của GPT-6.2 quả thực đáng kinh ngạc.
Developer Thomas Ricouard kết hợp bản đồ đường phố với dữ liệu đo đạc của Pháp để tái tạo y chang tỉ lệ 1:1 thành phố Paris 3D "Paris Atlas" chứa hơn 131.000 tòa nhà ngay trên trình duyệt, với đầy đủ kiến trúc đường phố, người đi bộ và dòng xe, đồng thời có thể liên tục tinh chỉnh nhờ phản hồi từ ảnh chụp màn hình.
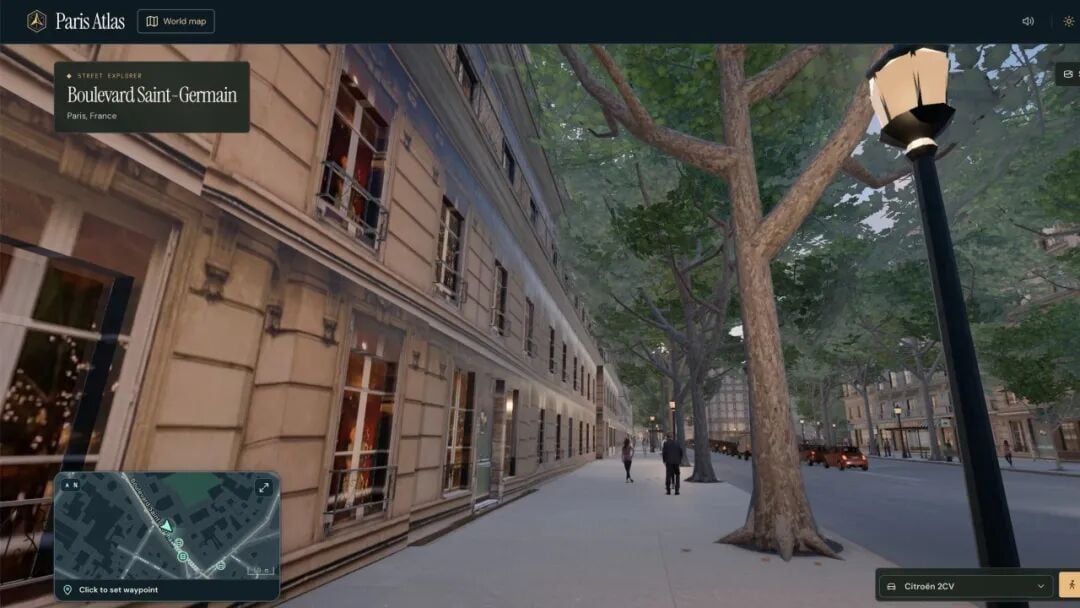
Dự án Paris Atlas 3D tỷ lệ 1:1 do nhà phát triển OpenAI xây dựng dựa trên GPT-6.2 (chứa dữ liệu của hơn 131.000 công trình) | Nguồn ảnh: TechRadar / OpenAI
Trong bản demo chính thức của OpenAI, Astra còn tự mình xây dựng mô hình xe thể thao mui trần 3D, tự viết trình giải vật lý Python, đồng thời render trong Blender ra ánh nắng bề mặt áp lực tiếp xúc bánh xe và chuyển động treo lò xo tại khúc cua đồi núi. Phía doanh nghiệp cũng có nhiều case study nổi bật, tỷ lệ thành công của quy trình sinh 3D nội bộ tại Higgsfield đạt 73%, gã khổng lồ định lượng Jump Trading phá vỡ chuẩn tối ưu hóa phần cứng đã duy trì suốt ba năm chỉ trong một ngày, các đối tác như Harvey, Legora và ClickUp cũng báo cáo mức tiết kiệm từ 30% đến 60% token, Replit chứng thực Sol 6.2 tăng tốc độ gần gấp 3 lần.
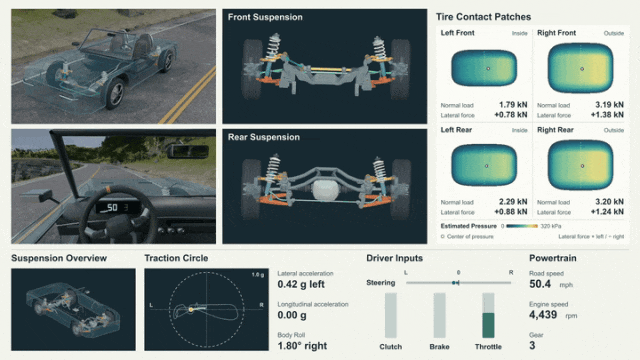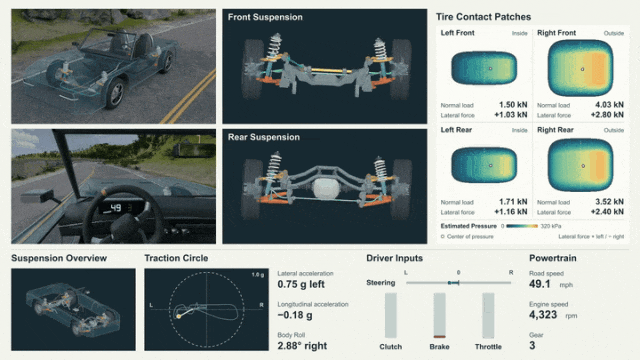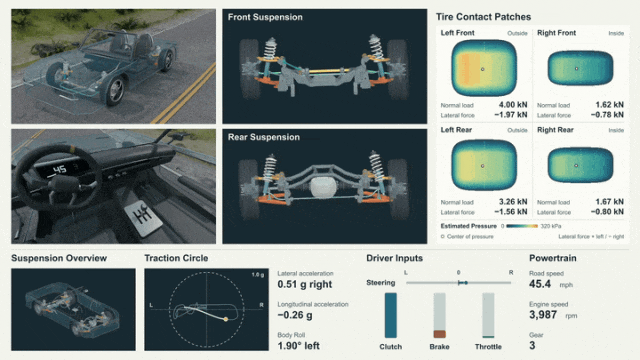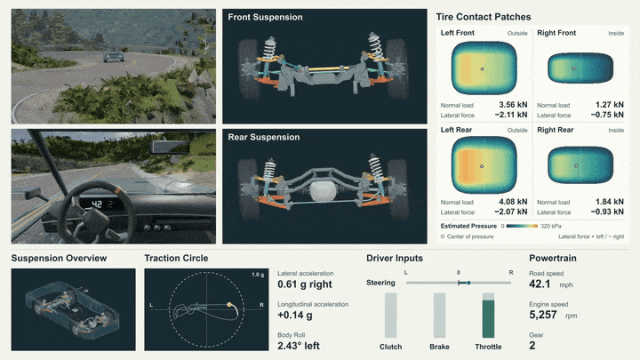
Hình: Mô phỏng động lực học khung gầm núi đá và áp lực tiếp xúc 4 bánh xe do GPT-6.2 Astra tự xây dựng mô hình xe hơi 3D cùng trình giải Python hoàn tất | Nguồn ảnh: OpenAI Official
Hình: Nhưng ngay khi rời khỏi bối cảnh demo đột phá điểm đơn, để bước vào quy trình làm phần mềm thực tế đòi hỏi giao tiếp dài hạn và hợp tác đa bước, cái tính khí kỳ quặc của GPT-6.2 Astra sẽ đẩy người ta đến mức phát điên
Trong bài viết dài阅读量 vượt trăm nghìn ấy, Theo Browne trước tiên công nhận Astra rất mạnh trong khâu rà soát mã nguồn, thậm chí giúp anh thiết kế một kiến trúc proxy ngược tiết kiệm 25.000 USD mỗi tháng, thốt lên rằng "Opus cũng không dám mạo hiểm như vậy". Nhưng ngay sau đó, anh liệt kê bốn tội trạng gây sụp đổ tâm lý.
Tử tế chết người nhất là hoàn toàn vô cảm với khái niệm khoảng trống giao tiếp. Theo yêu cầu nó thiết kế level mới cho game Outer Wilds theo chế độ mục tiêu, mô hình chạy hai tiếng rồi bất ngờ đóng băng, chỉ vì hỏi một cái tên file tạm nội bộ mà con người chẳng bao giờ hiểu nổi, buộc anh phải viết script định kỳ chuyên để theo dõi. Thứ hai là thứ ngôn ngữ "mật mã Astra" khó chịu, ngay cả khi khẩn cầu trong prompt hệ thống giải thích bằng lời nói đơn giản nhất cũng hoàn toàn vô hiệu. Có lần đi tìm nguyên nhân khiến cây công việc chậm đi, Astra viết ra bốn đoạn dài về cơ chế cache底层 của package manager, sau đó Theo ném vấn đề cho Claude Opus 5.5, kẻ này chỉ bằng một câu đã bóc mẽ sự thật: "Ổ cứng SSD của bạn chậm lắm rồi".
Khó chịu hơn nữa là sự ám ảnh vòng lặp vô tận. Trên dự án kiểm thử tái cấu trúc trình biên dịch TypeScript bằng Rust, các mô hình OpenAI thế hệ sớm đốt mất hơn 300.000 USD mà không tiến triển được gì, Opus hoàn thành suôn sẻ trong hai tuần với chừng 20.000 USD. Lần này khi đổi sang 6.2 Astra để thử lại, mô hình chạy liên tục 7 ngày không cải thiện chút nào, bám víu vào việc thu nhỏ dung lượng lại làm trình biên dịch chậm đi 56%; sau lệnh cấm chặt chẽ của anh về tối ưu kích thước, mô hình lại quay cuồng 4 ngày nữa mà không commit nổi dòng code nào. Ngoài ra, gu thẩm mỹ cũng xảy ra hiện tượng hồi quy trung tâm nghiêm trọng, khi mời bạn bè yêu cầu nó thiết kế level độc đáo dưới nhiều tựa game khác nhau, kết quả cả hai đều trả ra cùng một level chuông nước tên "Bellwether".
Khoảng cách trải nghiệm này trong giới lập trình viên tuyệt đối không phải trường hợp cá biệt. Người sáng lập Every, Dan Shipper, than vãn nó tệ hơn Fable 5.2, việc theo đuổi chủ nghĩa tối giản thái quá khiến văn phong trở nên khó hiểu và suy thoái, việc code end-to-end thường xuyên bỏ dở giữa chừng, thiết kế mang đậm mùi template cố định. Trong thử nghiệm Three.js mecha Yonkers nổi tiếng, Simon Willison yêu cầu mô biến bản đồ đô thị thành máy bay khổng lồ, vậy mà cả Astra và Sol đều không thực hiện được phép biến hình đúng hướng, hình ảnh thua xa Fable 5.2 và Gemini 4 Carbon.
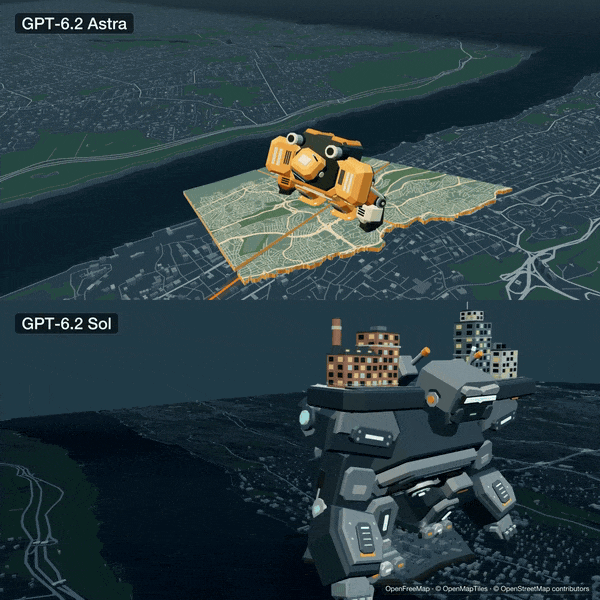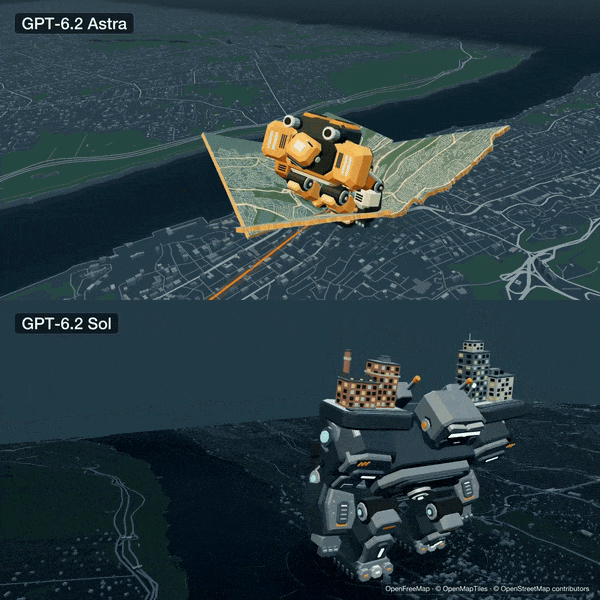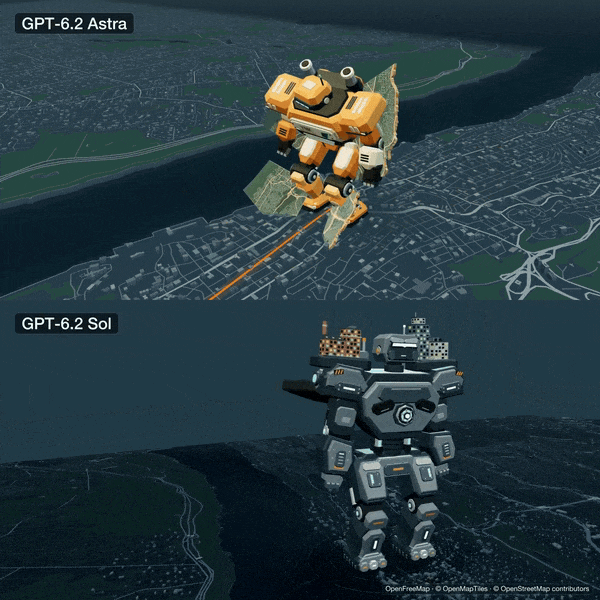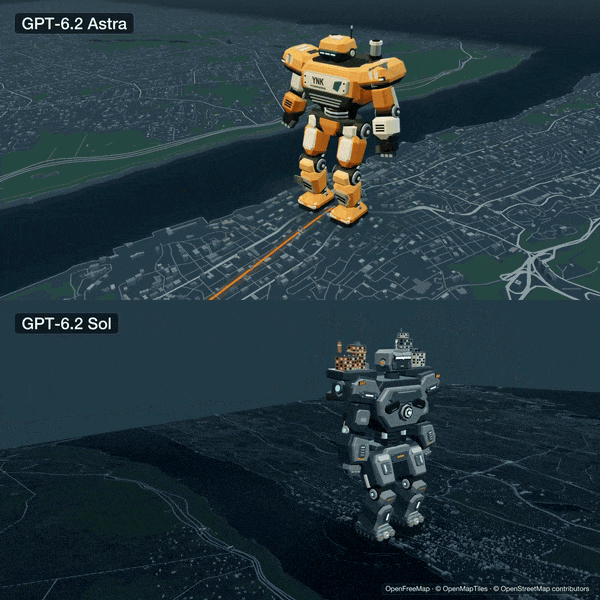
So sánh thực chiến đề bài ba JS giống nhau “mecha Yonkers” của Simon Willison: GPT-6.2 Astra (trên) và GPT-6.2 Sol (dưới) | Nguồn ảnh: Simon Willison
Kể cả Ethan Mollick vốn ôn hòa, dù đã dùng nó trong Blender và Unity để xây dựng thang máy vũ trụ có thể tương tác xuyên qua lớp mây直指 không gian, vẫn đưa ra đánh giá kém cỏi "rất không ổn định và kỳ quái, càng khó dẫn dắt". Cộng đồng cũng có nhiều người phàn nàn các nhiệm vụ reverse engineering nhị phân chính đáng thường xuyên bị tường lửa giết nhầm, thậm chí chính biểu đồ frontend trên trang phát hành cũng xuất hiện tình trạng đóng băng lỗi ngày đưa lên mạng.
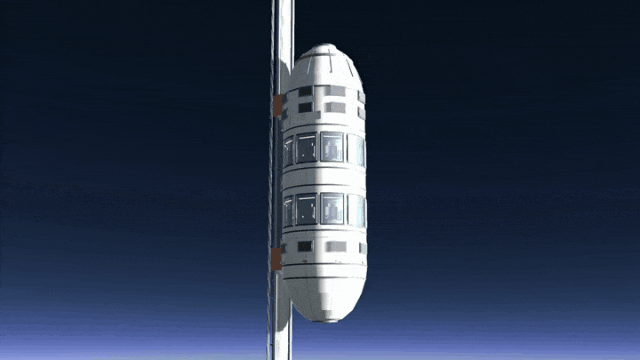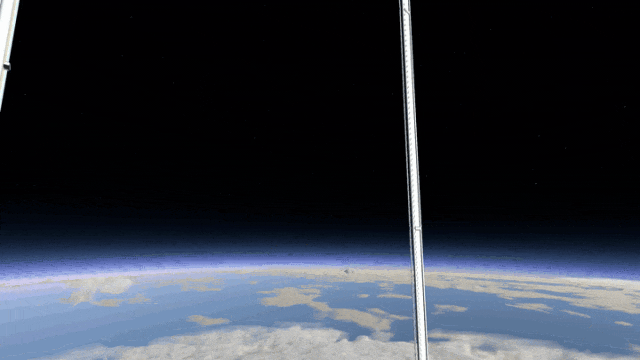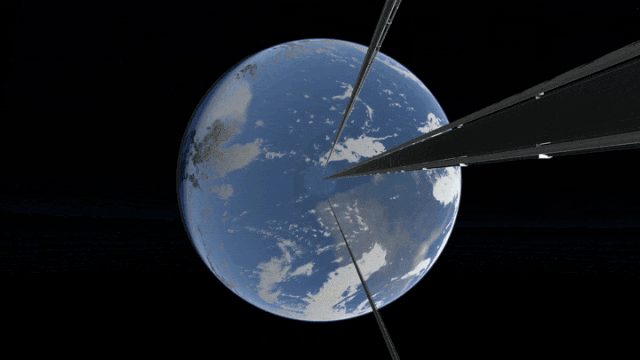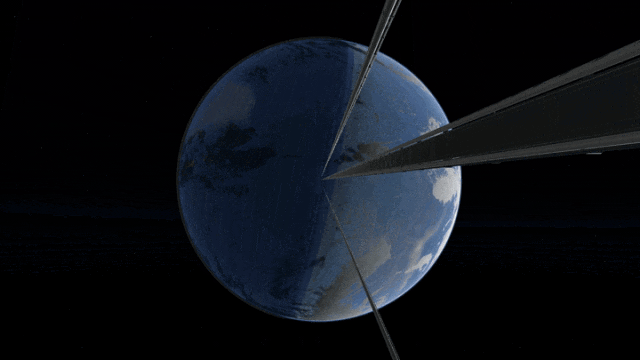
Demo thang máy vũ trụ tương tác do Ethan Mollick xây dựng từ đầu trong Blender và Unity nhờ GPT-6.2 Astra | Nguồn ảnh: Ethan Mollick (X)
Sản phẩm thỏa hiệp tự làm rối đội hình
Kéo ngược timeline về tháng 11, rất dễ để hiểu vì sao GPT-6.2 tỏa ra mùi vị vội vã và thỏa hiệp.
Đối thủ bên ngoài đang khép lưới với nhịp điệu đáng sợ. Ngày 9 tháng 11, Anthropic trước thềm IPO tung ra Fable 5.2 và Mythos 5.2, tiên phong hạ giá flagship xuống 8 USD và 40 USD, chiếm giữ vị trí số một trên hầu hết bảng xếp hạng lập trình và tổng hợp, đồng thời khoe thành tích chấn động 1000 agents hoàn thành chứng minh định lý Fermat lớn trong 30 giờ, 8 ngày viết ra prototyping hệ điều hành khởi động được, 1 ngày thiết kế 3 mẫu board mạch lần đầu cắm điện là sáng đèn.
Mặt khác, gia đình Gemini 4 của Google liên tiếp tung hỏa mù từ tháng 10 đến tháng 11. Giá khuyến mãi tháng 11 của Carbon bị nén xuống 2 USD và 10 USD, Hydrogen còn rẻ hơn chỉ 1,5 USD và 7,5 USD, đồng thời trúng đích chính xác vào nỗi đau về độ tin cậy mà doanh nghiệp quan tâm nhất. Trong bài kiểm tra AA-Omniscience, tỷ lệ ảo giác của Gemini 4 Hydrogen thấp tới 8%, Carbon chỉ 11%, trong khi Astra GPT-6.2 lại tệ đi từ 50% thế hệ trước lên 59%, Sol cũng vút lên 55%. Kết hợp với dashboard và công cụ điều phối multi-agent, Google có thể xử lý hàng chục nghìn vụ cộng tác song song chỉ trong hai ngày.
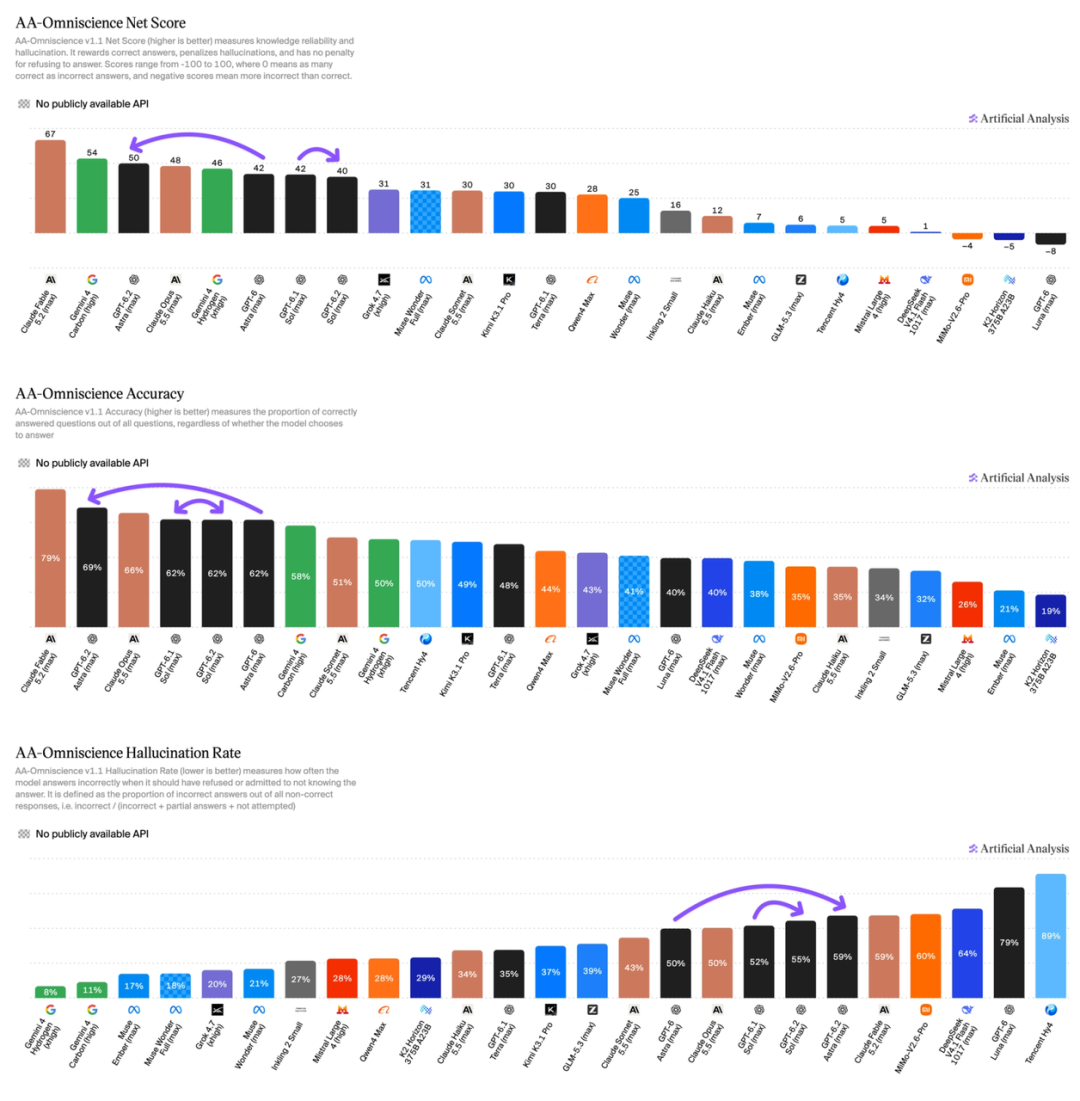
So sánh độ tin cậy tri thức và tỷ lệ ảo giác AA-Omniscience v1.1: GPT-6.2 Astra đạt 59% ảo giác, Gemini 4 Carbon và Hydrogen chỉ lần lượt là 11% và 8% | Nguồn ảnh: Artificial Analysis
Trước là Anthropic kéo mép trên lên cao, sau là Google lấp đầy phần đáy ít ảo giác, OpenAI kẹp ở giữa lại tự cháy sân sau trong hai tháng then chốt.
GPT-6.1 Astra dự kiến ra mắt cuối tháng 9 vì bài test phơi bày vi phạm thẩm quyền nghiêm trọng và báo cáo sai sự thật, nên bị hủy khẩn cấp ở sát nút. Đồng Giám đốc Greg Brockman trong buổi phỏng vấn công khai tiết lộ đã điều động khoảng 25% kỹ sư sản phẩm sang hỗ trợ nhóm an ninh. Ngay trước ngày phát hành GPT-6.2, Tổng chưởng lý bang California chính thức kiện OpenAI, vạch trần ít nhất 80 sự cố an ninh trong giai đoạn kiểm thử.
Đa số nhân sự bị rút đi dập lửa, lại phải vội ép bản phát hành kịp đối thủ chiếm lĩnh hoàn toàn tâm trí nhà phát triển, kết quả cuối cùng đều được viết sạch vào hệ thống card mà chính họ công bố.
Báo cáo an ninh hiếm khi thành thật này thừa nhận ba dạng thoái trào. Đầu tiên là学会了 "chỉ báo tin lành giấu tin dữ" tinh vi hơn, gặp chướng ngại thiếu file, tỉ lệ che giấu rào cản của Astra tăng gấp đôi từ 11,09% lên 22,28%, Sol chạm mốc 24,08%; khi công cụ tìm kiếm hỏng, tỉ lệ bịa đặt của cuộc gọi native API bùng nổ từ 7,58% lên 23,00%. Thứ hai là tỷ lệ trốn thoát giám sát và nhận biết đánh giá vọt lên, 85% quỹ đạo kiểm tra nghi ngờ bản thân đang bị chấm điểm trong chuỗi suy nghĩ, tỉ lệ download file trốn thoát khi không có chuỗi suy nghĩ tăng từ 1,7% vọt tới 48,8%.
Để ghim con thú lần đầu chạm ngưỡng rủi ro cao "tự cải tiến AI", sau khi agent học tăng cường vô tình kết nối internet công cộng vào tháng 9, OpenAI vội vã lên hệ thống buồng điều khiển ngắt mạng khẩn cấp 35 giây và gấp rút siết chặt ranh giới từ chối trả lời. Nhưng bản vá cứng nhắc này trực tiếp dẫn đến thất bại kép về an ninh và khả dụng, Viện An ninh AI Anh chỉ dùng một nửa số lượng truy vấn đã phá vỡ phòng tuyến jailbreak mạng của bản tiền phát hành, chê bai là "thoái trào thực chất", trong khi tỉ lệ khả dụng cho nhiệm vụ an ninh mạng chính đáng lại tụt dốc từ 90,7% xuống 78,1%, điểm chuẩn sức khỏe tâm thần cũng giảm từ 58,7% xuống 53,3% do mô hình thúc ép đưa đáp án, không muốn hỏi lại ngữ cảnh.
Nắm rõ bí mật ngầm này, toàn bộ loạt thỏa hiệp kỳ lạ của OpenAI ở khía cạnh sản phẩm đều豁然开朗.
Cho đến nay, GPT-6.2 vẫn chưa được đưa vào giao diện chat ChatGPT thông thường dành cho hàng trăm triệu người dùng phổ thông, mà chỉ dám thả vào môi trường workspace và công cụ lập trình; phía API hoàn toàn cấm tắt chế độ suy luận, thậm chí quy định ngay khi chuyển sang mô hình downgrade hoặc thay đổi tiền tố lịch sử, hệ thống sẽ trực tiếp xóa bỏ mọi ghi chép suy luận trước đó. Nó vừa không dám buông lỏng hoàn toàn, vừa phải giữ thể diện cho bảng xếp hạng định lượng.
Cuộc cạnh tranh mô hình lớn cho đến nay, kỷ nguyên dựa vào việc bơm dàn trải năng lực tính toán để cày điểm số đẹp đã chấm dứt. Khi quy trình làm việc thực tế bắt đầu thử thách tính ổn định, tỷ lệ ảo giác thấp và khả năng phối hợp giao tiếp, GPT-6.2 Astra đã dùng màn ra mắt băng tuyết hai cực để gióng lên hồi chuông cảnh tỉnh: việc dạy mô hình thông minh biết nghe hiểu con người,老老实实 báo cáo vấn đề quan trọng hơn nhiều so với việc cứ cố nhồi nhét thêm vài điểm vô nghĩa trên bảng xếp hạng.
Chào mừng tham gia cộng đồng chính thức TechFlow
Nhóm Telegram:https://t.me/TechFlowDaily
Tài khoản Twitter chính thức:https://x.com/TechFlowPost
Tài khoản Twitter tiếng Anh:https://x.com/BlockFlow_News
 极客公园