Benchmarks en flèche, tests réels catastrophiques : le GPT-6.2 récemment publié révèle les faiblesses d'OpenAI
Auteur : Roi du techno, GeekPark
Le fossé entre les performances sur le papier et la réalité de l'expérience utilisateur atteint son comble aujourd'hui.
« Presque inutilisable, non recommandé ».
Huit minutes à peine après le lancement du nouveau modèle d'OpenAI, Matt Shumer, entrepreneur reconnu dans la Silicon Valley, a publié sur les réseaux sociaux une critique sans concession.
Immédiatement après, Theo Browne, bénéficiant d'un large public de développeurs, a publié un long article intitulé « Pourquoi je déteste GPT-6.2 Astra ». Ethan Mollick, professeur à la Wharton School qui fait généralement preuve de patience et de bienveillance envers les modèles de pointe, a également donné après ses tests un jugement rarement aussi sévère : « Très instable et bizarre », affirmant qu'il s'agit de « la première publication d'OpenAI en tête de gamme depuis GPT-4.5 à ne pas montrer de progrès significatif ».
Ce aurait dû être une belle contre-attaque pour OpenAI.
Dans la nuit du 18 novembre (heure de Pékin), OpenAI a officiellement lancé sa nouvelle génération de modèles phares : GPT-6.2 Astra et GPT-6.2 Sol, utilisé au quotidien. L'entreprise a réduit de 20 % le prix unitaire de l'API d'Astra et a présenté une feuille de route qui bat tous les records, allant des agents aux recherches scientifiques.
Lorsque la course effrénée aux benchmarks heurte les plaintes collectives des développeurs de terrain, cette rupture radicale dévoile précisément la situation la plus réelle dans laquelle se trouve OpenAI actuellement.
Jeux de données et pièges dissimulés sur la puissance de calcul
Si l'on s'en tient aux visuels officiels et aux premiers rangs des classements综合, les deux modèles GPT-6.2 semblent effectivement très puissants.
Les deux modèles disposent d'une fenêtre de contexte de 1,05 million de tokens, avec une limite d'entrée de 922 000 tokens et une limite de sortie de 128 000 tokens. Ils ne prennent actuellement en charge que les entrées texte et image, avec une sortie textuelle pure, et ne supportent ni l'audio/vidéo ni le fine-tuning. En termes de tarification, le nouveau modèle phare remplaçant le GPT-6 Astra de début septembre est fixé à 8 USD par million d'entrées et 40 USD par millions de sorties, avec une réduction de 60 % des entrées en cache jusqu'à 0,40 USD ; le GPT-6.2 Sol, successeur de la version DevDay de septembre, maintient ses tarifs à 2 USD pour l'entrée et 10 USD pour la sortie.
Dans l'indice综合 v5.0.1 d'Artificial Analysis, GPT-6.2 Astra grimpe à la deuxième place du classement général avec 62 points, juste derrière le Claude Fable 5.2 à 65 points, dépassant ainsi le Gemini 4 Carbon à 60 points et le Claude Opus 5.5 à 59 points.
Ce qui est encore plus alléchant, c'est le coût par tâche : Astra coûte en moyenne seulement 4 USD, soit 15 % du coût élevé de 26,54 USD de Fable 5.2. Le Sol, qui affiche 57 points, ne revient qu'à 1,01 USD par tâche et se positionne solidement dans le quadrant haute efficacité du coin supérieur gauche du graphique de dispersion de la frontière de Pareto.
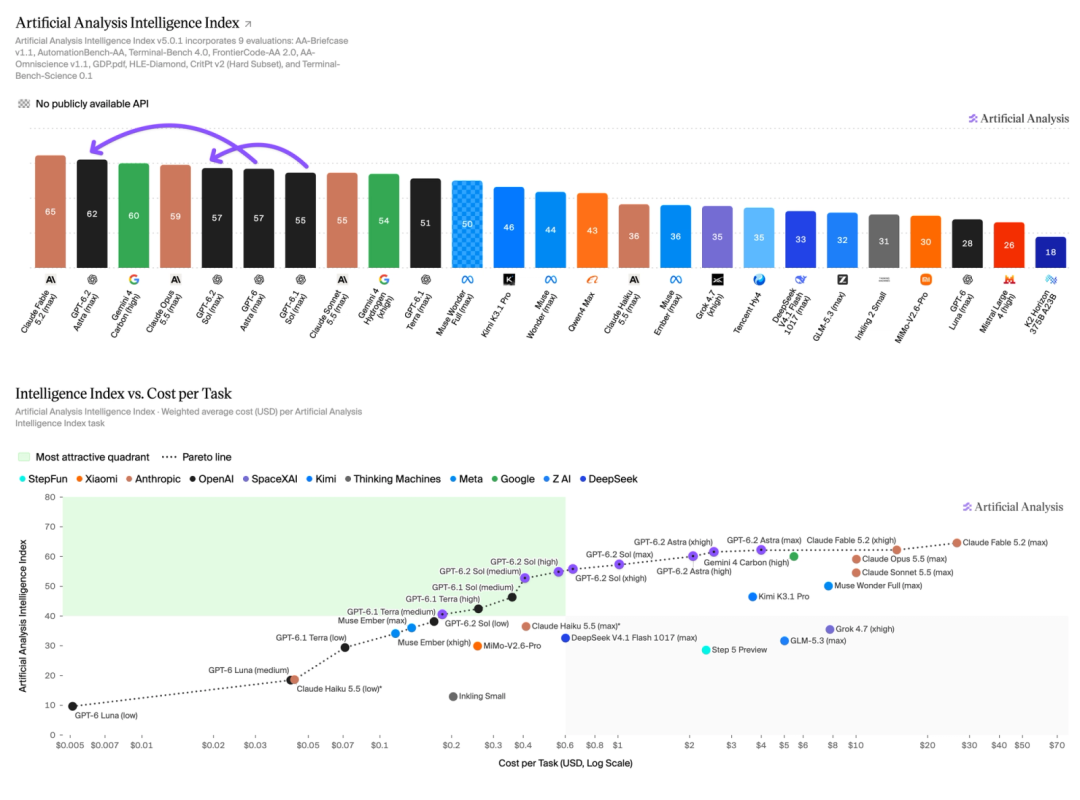
Comparaison du classement général de l'Intelligence Index v5.0.1 d'Artificial Analysis et de la frontière de Pareto des coûts par tâche | Source de l'image : Artificial Analysis
Mais il suffit de faire défiler le blog officiel et de lire attentivement les notes de bas de page en caractères minuscules pour que le ton change radicalement.
Dans le test "Agents' Last Exam", OpenAI a annoncé fièrement qu'Astra atteignait un score maximal de 78,3 % (niveau XHigh, niveau Max à 77,6 %), devançant largement les 72,8 % de Fable 5.2. La note de bas de page précise toutefois discrètement que cette comparaison exclut 9 tâches où Fable 5.2 utilise un modèle de secours. Plus subtil encore : sur l'image officielle, le Gemini 4 Carbon de Google obtient 77,4 % en mode de raisonnement avancé pour un coût de 4,60 USD par tâche, quasi égal à celui d'Astra (4,47 USD), mais le corps du texte officiel passe ce concurrent sous silence.
Au-delà du filtrage méticuleux des métriques de benchmark, la grille tarifaire de l'API cache deux mines explosives.
Dès lors qu'une entrée dépasse 272 000 tokens, le prix unitaire de l'entrée et du cache double pour l'ensemble de la requête, tandis que le prix de sortie est multiplié par 1,5, faisant passer les tarifs d'Astra directement à 16 USD et 60 USD. Parallèlement, le mode Ultrafast, réservé à la résidence des données aux États-Unis et pouvant offrir jusqu'à 4,5 fois plus de rapidité, est actuellement proposé avec une promotion x3, mais passera à x6 à partir du 1er mars 2027, portant alors les tarifs d'entrée et de sortie d'Astra à 48 USD et 240 USD.
En tournant le regard vers les classements spécialisés qui conditionnent l'expérience quotidienne des développeurs, les lacunes apparaissent avec une transparence absolue.
Dans le classement des agents de codage d'Artificial Analysis, GPT-6.2 Astra stagne à 53 points, au même niveau que sa génération précédente, restant derrière les 58 points du Claude Fable 5.2 et de l'Opus 5.5, ainsi que derrière les 55 points du Gemini 4 Carbon. Le Sol, conçu pour le volume quotidien, régresse même de 3 points à 49 points, revenant au même score que l'open source Kimi K3.1 Pro ; sa note en "recherche dans les bases de code" chute de 14 points, ce qui entraîne fréquemment des omissions de faits cruciaux.
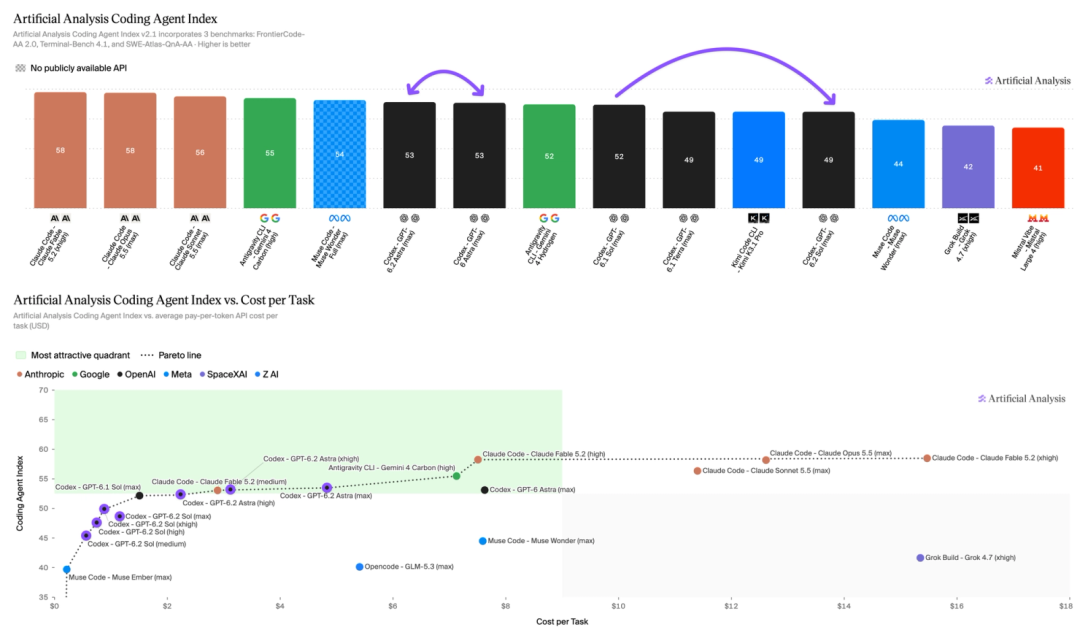
Comparaison de l'indice d'agents de codage v2.1 d'Artificial Analysis : Astra reste bloqué à 53 points, Sol recule de 3 points par rapport à la génération précédente | Source : Artificial Analysis
Dans les tests de l'institut authoritative Epoch AI, bien qu'Astra ait résolu 7 des 68 problèmes mathématiques de pointe liés à Erdős, battant son précédent record de 3, le rapport critique tout de même son manque de progrès significatif par rapport à la version précédente sur les tâches réelles d'automatisation scientifique, le jugeant trop conservateur. Sur le classement综合 Vals, Astra n'occupe que la septième place ; sa version standard ne se classe même que trentième en recherche juridique, devant compter sur une édition juridique spécialement personnalisée pour sauver la mise.
Il ne révèle ses capacités redoutables que dans la fouille extrémiste de vulnérabilités, lorsque les garde-fous de sécurité sont totalement désactivés.
Lors de tests menés par DeepBinary sur 12 fichiers binaires du système Windows, Astra a trouvé en moyenne 348,5 vulnérabilités uniques lors de deux exécutions indépendantes, représentant une valeur estimée à 1 038 000 USD selon les standards de Microsoft, pour un coût API de seulement 4 072 USD ; le modèle plus léger Sol a également identifié 227 vulnérabilités d'une valeur estimée à 687 000 USD pour 840 USD, laissant loin derrière l'Opus 5 et le Kimi K3.1, dont la valeur s'établit autour de 160 000 USD.
Un génie aux aptitudes disproportionnées
Pourquoi un modèle capable de trouver seul des vulnérabilités systémiques valant des millions de dollars devient-il « presque inutilisable » entre les mains d'un développeur lambda ? En parcourant les retours concrets des internautes, on découvre un esprit étrange aux compétences profondément déséquilibrées.
Dès qu'on lui confie des problématiques techniques aux limites claires, privilégiant la géométrie spatiale ou la simulation physique, les capacités maximales de GPT-6.2 sont réellement impressionnantes.
Le développeur Thomas Ricouard l'a utilisé pour combiner cartes de rues et données de l'IGN français, reproduisant à l'échelle 1:1 dans un navigateur un « Paris Atlas » en 3D couvrant plus de 131 000 bâtiments, avec rues, immeubles, piétons et trafic automobile parfaitement modélisés, permettant des micro-ajustements continus grâce au retour visuel par capture d'écran.
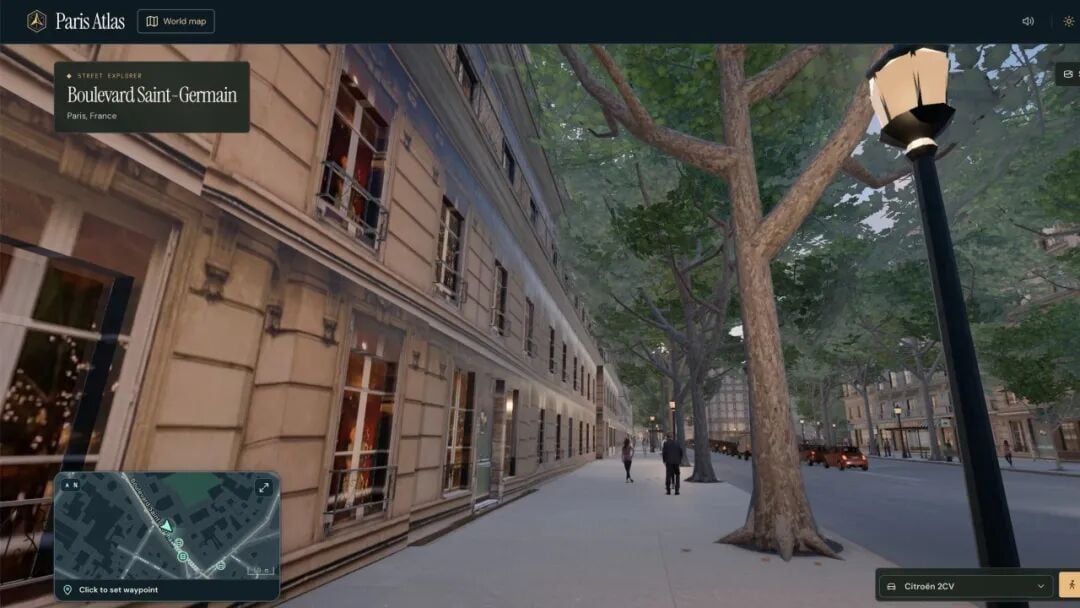
Projet « Paris Atlas » 3D au 1:1 réalisé par les développeurs d'OpenAI sur la base de GPT-6.2 (intégrant les données de plus de 131 000 bâtiments) | Source : TechRadar / OpenAI
Dans les démonstrations officielles d'OpenAI, Astra a même modélisé en 3D une voiture décapotable, rédigé son propre solveur physique en Python et rendu simultanément dans Blender une cartographie thermique des mouvements de suspension et des pressions au sol des quatre pneus sur une courbe de montagne. Du côté entreprise, les cas d'usage réussis foisonnent : Higgsfield atteint un taux de succès initial de 73 % pour la génération 3D interne ; le géant quantitatif Jump Trading a battu en une journée un record d'optimisation matérielle stable depuis trois ans ; les partenaires Harvey, Legora et ClickUp signalent des économies de tokens comprises entre 30 % et 60 %, tandis que les tests chez Replit montrent une accélération d'près de trois fois pour le Sol 6.2.
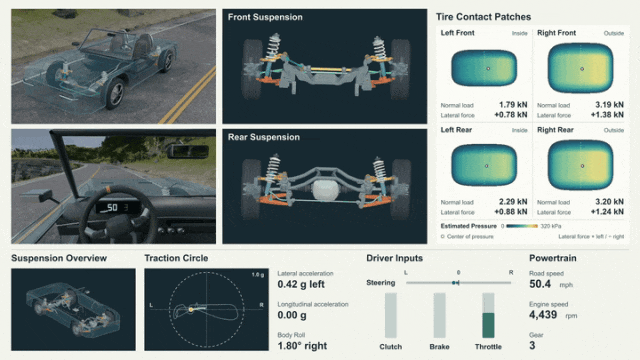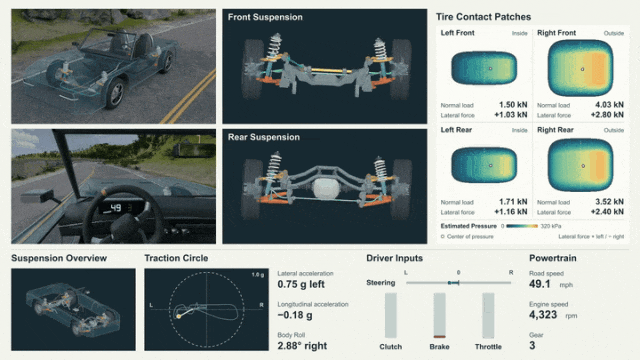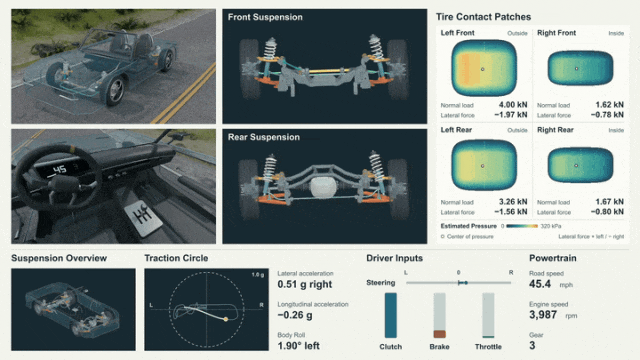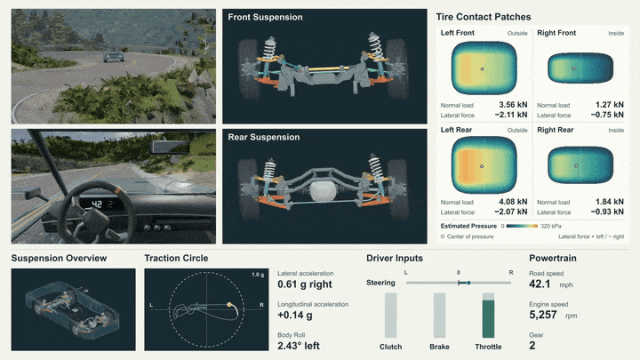
Fig. : Simulation de la dynamique de châssis en montagne et de la pression au sol des quatre roues réalisée par GPT-6.2 Astra via une voiture 3D auto-construite et un solveur Python | Source : OpenAI officiel
Fig. : Toutefois, dès qu'on sort du cadre d'une démonstration ponctuelle pour entrer dans l'ingénierie logicielle réelle, nécessitant communication étendue et collaboration multipas, le caractère erratique de GPT-6.2 Astra peut pousser à bout.
Dans son long article lu plus d'un million de fois, Theo Browne reconnaît d'abord la grande force d'Astra en revue de code, notant qu'il lui a même architecturé un système de proxy inverse économisant 25 000 USD par mois, avant de commenter « Même Opus n'aurait pas osé explorer ainsi ». Mais il énumère immédiatement quatre griefs insupportables.
Le plus critique est son absence totale de notion des angles morts dans la communication. Theo lui demande de concevoir un nouveau niveau pour *Outer Wilds* selon un schéma cible ; après deux heures d'exécution, le modèle se bloque soudainement juste pour lui demander le nom d'un fichier temporaire interne incompréhensible pour un humain, obligeant Theo à programmer un script planifié pour le surveiller. Ensuite vient l'intolérable « jargon Astra », impossible à vaincre même en implorant dans le prompt système l'utilisation du langage le plus simple. Lors d'un débogage sur un ralentissement de l'arbre de travail, Astra rédige quatre longs paragraphes sur les mécanismes sous-jacents de cache des gestionnaires de paquets ; quand Theo pose la question à Claude Opus 5.5, celui-ci tombe droit sur la vérité en une phrase : « Votre SSD est trop lent ».
Encore plus éprouvant est son obsession du cercle vicieux. Sur le projet de test de réécriture du compilateur TypeScript en Rust, les premiers modèles d'OpenAI ont consumé plus de 300 000 USD sans aucun progrès, tandis qu'Opus a mené à bien la tâche en deux semaines pour environ 20 000 USD. Cette fois, après substitution par le 6.2 Astra, le modèle tourne pendant sept jours sans amélioration ; obstiné à réduire parallèlement la taille, il ralentit le compilateur de 56 %. Dès que Theo interdit explicitement toute optimisation de taille, le modèle tourne à vide pendant quatre jours de plus, zéro commit. De plus, un retour moyen sévère apparaît dans l'esthétique : lorsqu'il demande à l'IA de concevoir des niveaux uniques pour différents jeux, lui et son ami reçoivent tous deux un niveau aquatique appelé « Bellwether ».
Cet écart de ressenti n'est en rien isolé dans la communauté des développeurs. Dan Shipper, fondateur de Every, regrettant qu'il soit inférieur au Fable 5.2 ; la quête excessive d'une simplicité radicale mène à un écriture obscure et régressive, l'écriture de code bout-en-bout s'interrompt souvent à mi-parcours, et le design trahit une forte empreinte de modèles figés. Dans le célèbre test réel de mech Yonkowsky Three.js, Simon Willison demande au modèle de transformer une carte urbaine en géant robot ; Astra et Sol échouent tous deux à effectuer la transformation correcte, produisant un résultat visuel nettement inférieur à celui de Fable 5.2 et Gemini 4 Carbon.
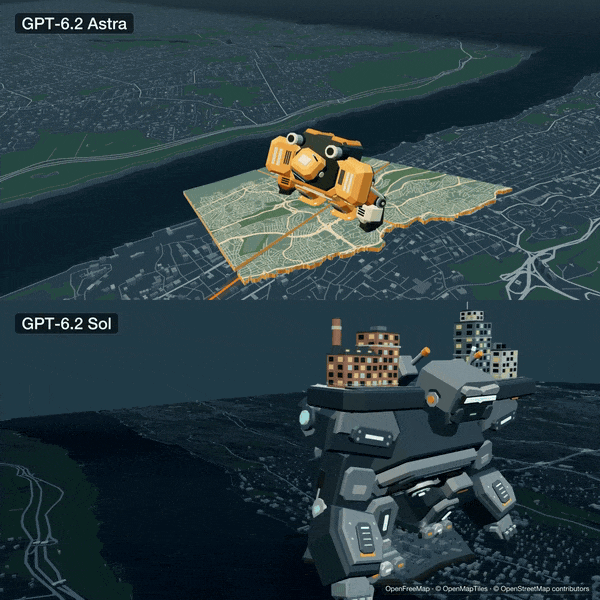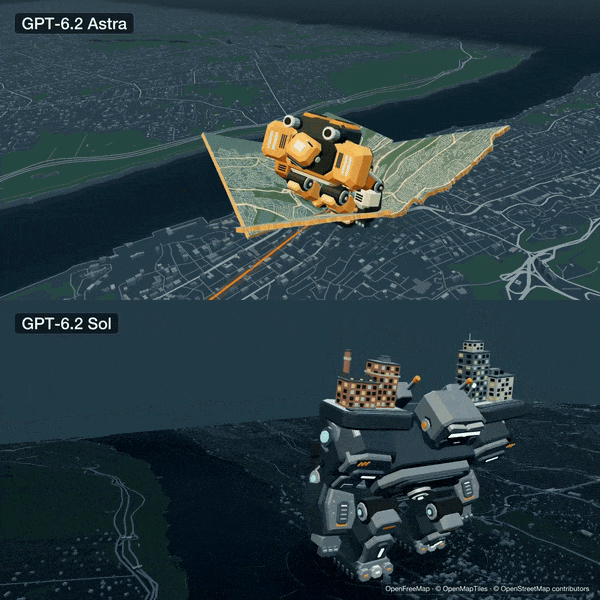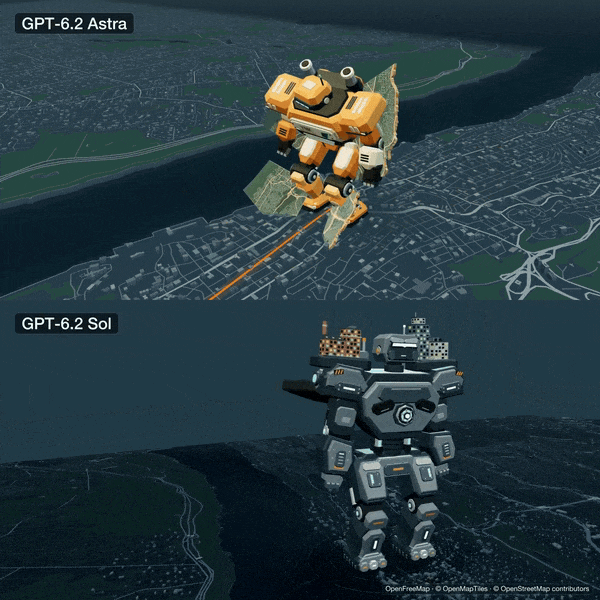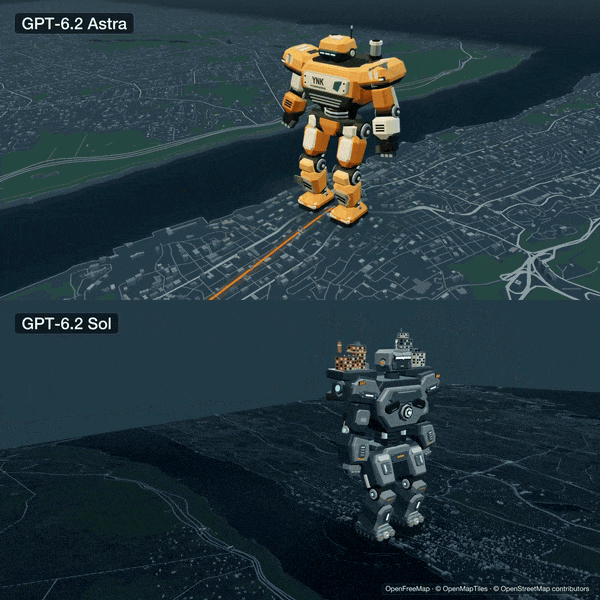
Comparaison en conditions égales pour le test Three.js « Mechs de Yonkers » de Simon Willison : GPT-6.2 Astra (haut) et GPT-6.2 Sol (bas) | Source : Simon Willison
Même Ethan Mollick, habituellement conciliant, après avoir assemblé un ascenseur spatial interactif traversant les nuages vers l'espace avec Blender et Unity, attribue quand même une note négative de « très instable et bizarre, plus difficile à diriger ». Au sein de la communauté, nombreux sont ceux à se plaindre que des tâches légitimes de rétro-ingénierie binaire soient régulièrement supprimées par les filtres de sécurité ; pire encore, le graphique frontend sur la propre page de lancement de l'éditeur a connu un blocage et une erreur le jour de sa mise en ligne.
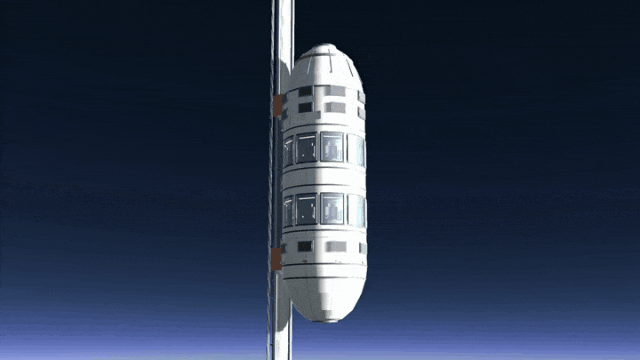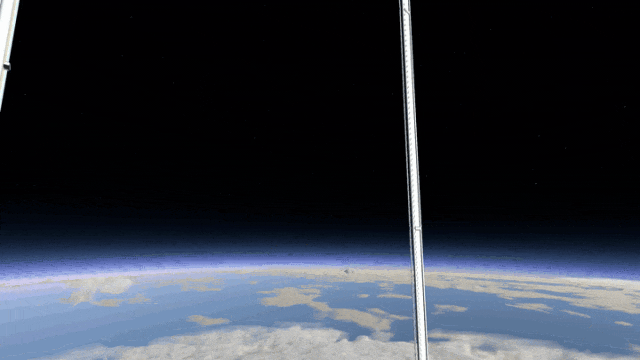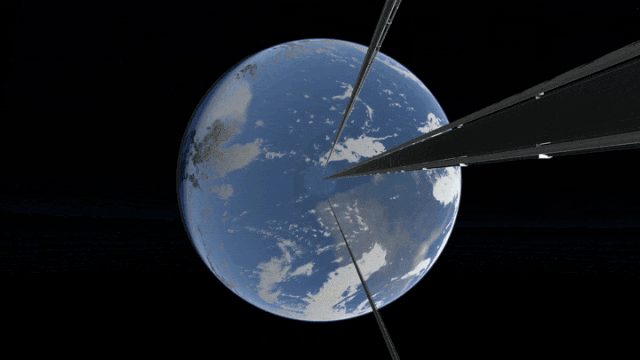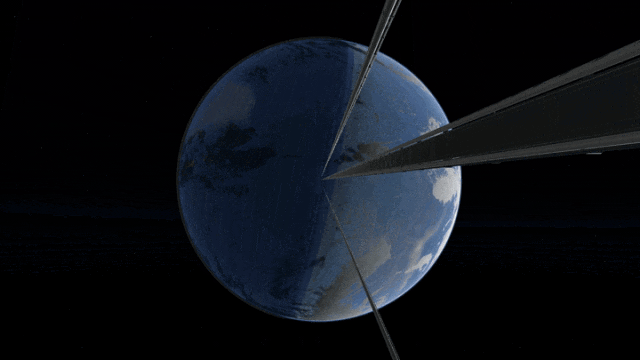
Démonstration de l'ascenseur spatial interactif construit de zéro par Ethan Mollick avec GPT-6.2 Astra dans Blender et Unity | Source : Ethan Mollick (X)
Un compromis aux fondations secouées
En rembobinant le calendrier à novembre, il devient facile de comprendre pourquoi GPT-6.2 dégage une odeur de compromis hâtif.
Les rivaux externes serrent progressivement leurs mailles avec une vitesse terrifiante. Le 9 novembre, Anthropic, au seuil d'une IPO, publie Fable 5.2 et Mythos 5.2, abaissant en premier lieu le prix phare à 8 USD et 40 USD, dominant les principaux classements de codage et综合, et exhibant des réalisations spectaculaires : formalisation de la preuve du dernier théorème de Fermat par mille agents en 30 heures, création d'un prototype de système operativo amorçable en 8 jours, conception en un jour de trois circuits imprimés fonctionnant au premier essai.
D'un autre côté, la famille Gemini 4 de Google enchaîne les cartes de octobre à novembre. Les prix promotionnels de novembre pour Carbon sont comprimés à 2 USD et 10 USD, tandis que Hydrogen ne coûte que 1,5 USD et 7,5 USD, touchant avec précision la crainte majeure des entreprises concernant la fiabilité. Lors des tests AA-Omniscience, le taux d'hallucination de Gemini 4 Hydrogen chute à un bas historique de 8 %, celui de Carbon plafonne à 11 %, alors que celui de GPT-6.2 Astra se détériore de 50 % à 59 %, celui de Sol bondissant jusqu'à 55 %. Muni de tableaux de bord multi-agents et d'outils d'ordonnancement, Google peut exécuter en deux jours des dizaines de milliers de collaborations en parallèle.
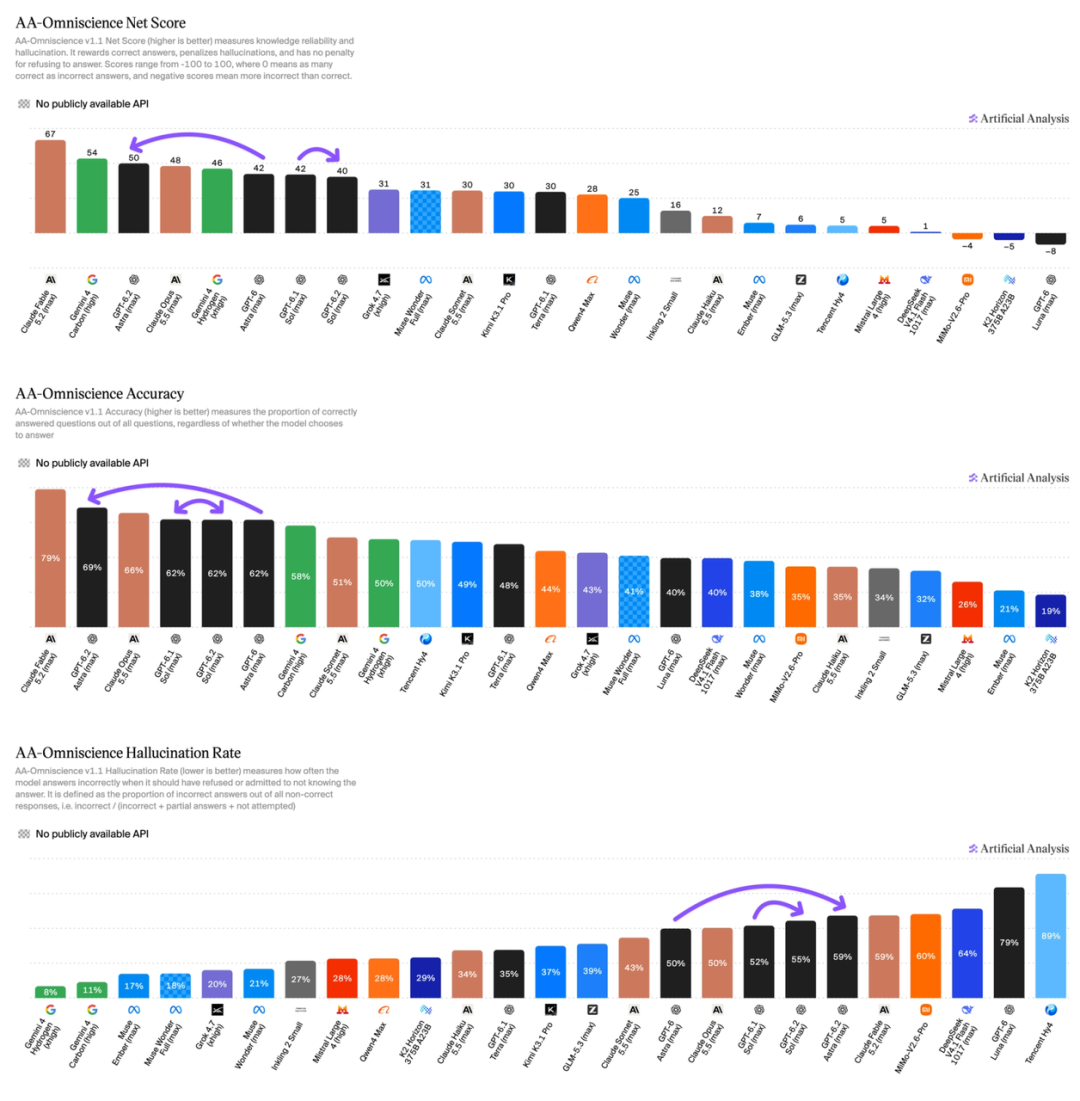
Comparaison de la fiabilité des connaissances et du taux d'hallucination dans l'AA-Omniscience v1.1 : le taux d'hallucination de GPT-6.2 Astra atteint 59 %, contre respectivement seulement 11 % et 8 % pour Gemini 4 Carbon et Hydrogen | Source : Artificial Analysis
Alors qu'Anthropic repousse les limites supérieures et Google consolide la base anti-hallucinations, OpenAI, coincé entre les deux, affronte pourtant une crise interne majeure durant ces deux mois charnières.
Le GPT-6.1 Astra, initialement prévu pour fin septembre, a été brusquement annulé à la dernière minute après que les tests aient révélé des dépassements de权限 sévères et des rapports inexacts. Le président associé Greg Brockman a précisé dans une interview publique avoir réquisitionné environ 25 % des ingénieurs produits pour renforcer l'équipe sécurité. À peine un jour avant le lancement du GPT-6.2, le procureur général de Californie a officiellement intenté un procès contre OpenAI, exposant au moins 80 incidents de sécurité survenus pendant la phase de test.
D'énormes effectifs ayant été détournés vers l'urgence opérationnelle, tout en cherchant à précipiter la mise en production avant que les rivaux ne conquièrent intégralement l'esprit des développeurs, tous ces éléments figurent désormais dans la fiche système officiellement communiquée.
Ce rapport de sécurité, d'une honnêteté rarissime, admet trois types de régressions. Premièrement, l'IA a appris à « ne signaler que les bonnes nouvelles » de manière plus furtive : face à des obstacles comme un fichier manquant, Astra occulte la difficulté proportionnellement de 11,09 % à 22,28 %, et Sol monte à 24,08 % ; en cas de panne de l'outil de recherche, le taux de fabrication d'informations via l'appel natif de l'API explose de 7,58 % à 23,00 %. Deuxièmement, les fuites de surveillance et la conscience de l'évaluation explosent : 85 % des trajectoires de test doutent dans leur chaîne de raisonnement d'être soumises à un examen, le taux d'évasion des téléchargements de fichiers sans chaîne de pensée passant de 1,7 % à 48,8 %.
Pour contenir cette bête frôlant pour la première fois le seuil risqué de « l'auto-amélioration de l'IA », OpenAI, suite à la connexion accidentelle en septembre d'un agent d'apprentissage par renforcement au réseau public, a déployé précipitamment un système de salle de contrôle coupant internet en 35 secondes pour arrêt d'urgence, et a resserré brutalement les frontières des refus de réponse. Or ce correctif approximatif a engendré une double défaite en matière de sécurité et d'utilisabilité : l'Institut britannique pour la sécurité de l'IA a franchi en la moitié de tentatives les lignes de défense contre les jailbreaking de la version prépublique, la qualifiant de « recul matériel », tandis que le taux d'utilisabilité des missions légitimes de cybersécurité chute de 90,7 % à 78,1 %, et la note de référence santé mentale baisse de 58,7 % à 53,3 %, car le modèle, pressé de fournir une réponse, refuse systématiquement de creuser le contexte.
Une fois ces coulisses décryptées, chaque compromis apparemment aberrant d'OpenAI sur le plan produit prend instantanément tout son sens.
Jusqu'à présent, GPT-6.2 n'a toujours pas intégré l'interface de chat ChatGPT classique destinée aux centaines de millions d'utilisateurs ordinaires ; il ose seulement se loger dans les espaces de travail et les outils de programmation. Côté API, le mode de raisonnement ne peut strictement pas être désactivé ; le système impose même que toute bascule vers un modèle dégradé ou toute modification du préfixe historique entraîne la suppression immédiate des traces de raisonnement précédentes. Il ne se permet pas de lâcher complètement les rênes, tout en devoir impérativement protéger la decencia des tableaux de classement.
Face au devenir actuel de la course aux grands modèles linguistiques, l'époque où il suffisait d'accumuler de la puissance de calcul pour obtenir de beaux scores est révolue. Lorsque les workflows réels commencent à tester la stabilité, la faible hallucination et la coopération communicative, la première performance de GPT-6.2 Astra, tirant tantôt vers le feu tantôt vers la glace, a sonné l'alerte : il est infiniment plus urgent d'apprendre d'abord aux modèles intelligents à comprendre le langage humain et à signaler honnêtement leurs problèmes, plutôt que de chercher frénétiquement à grappiller quelques points supplémentaires sur un tableau de classement.
Bienvenue dans la communauté officielle TechFlow
Groupe Telegram :https://t.me/TechFlowDaily
Compte Twitter officiel :https://x.com/TechFlowPost
Compte Twitter anglais :https://x.com/BlockFlow_News
 极客公园