給 Gemini 道歉,請自覺排隊
作者:愛範兒
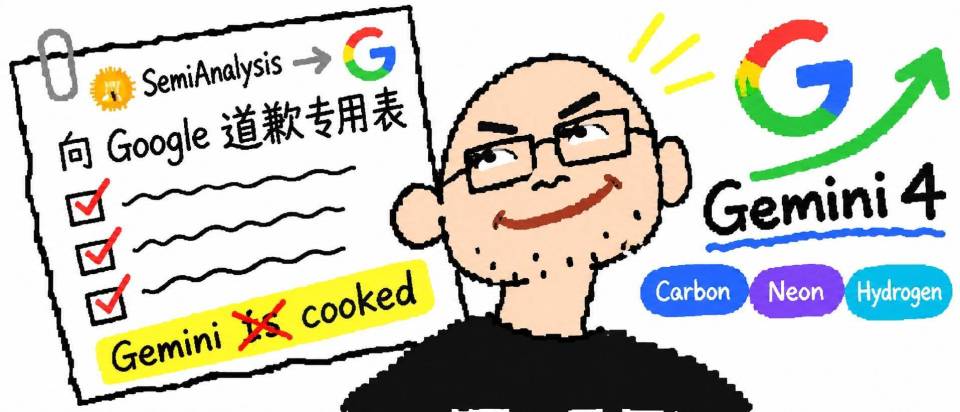
今天,知名半導體和 AI 研究機構 SemiAnalysis 在 X 上發了一張寫給 Google DeepMind 主席 Demis Hassabis 的《向 Google 道歉專用表》。
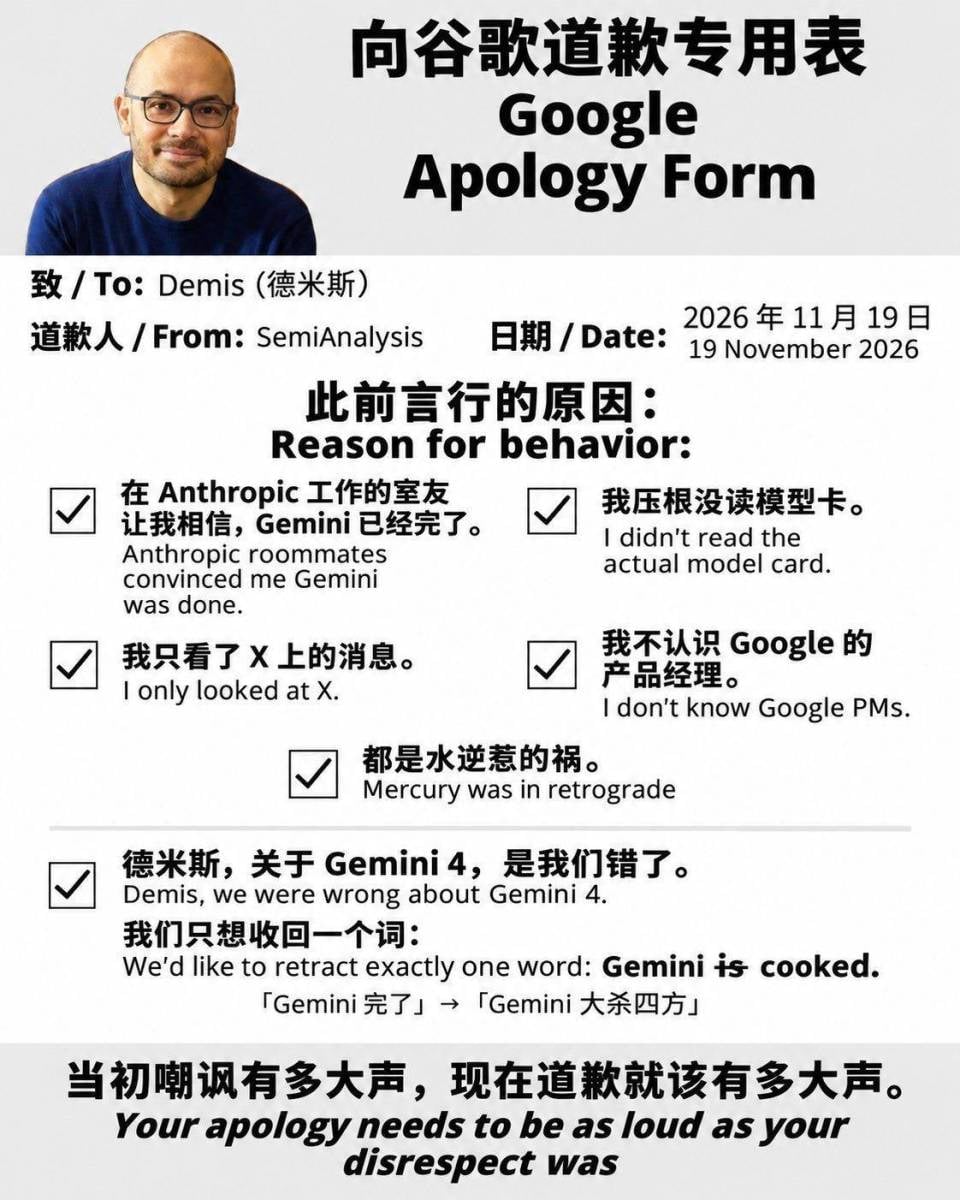
理由一欄勾了包括“我只看了 X 上大家的消息”、“我那在 Anthropic 工作的室友,說服我相信 Gemini 已經完了”和“我沒有閱讀模型卡”等原因。最有意思的是最後一行:“Demis,關於 Gemini 4,我們錯了。我們只想撤回一個詞。”
他們從自己當初的標題裡劃掉了一個 is:Gemini is cooked。一句“Gemini 完了”,變成了“Gemini 這回真做出了點東西”。
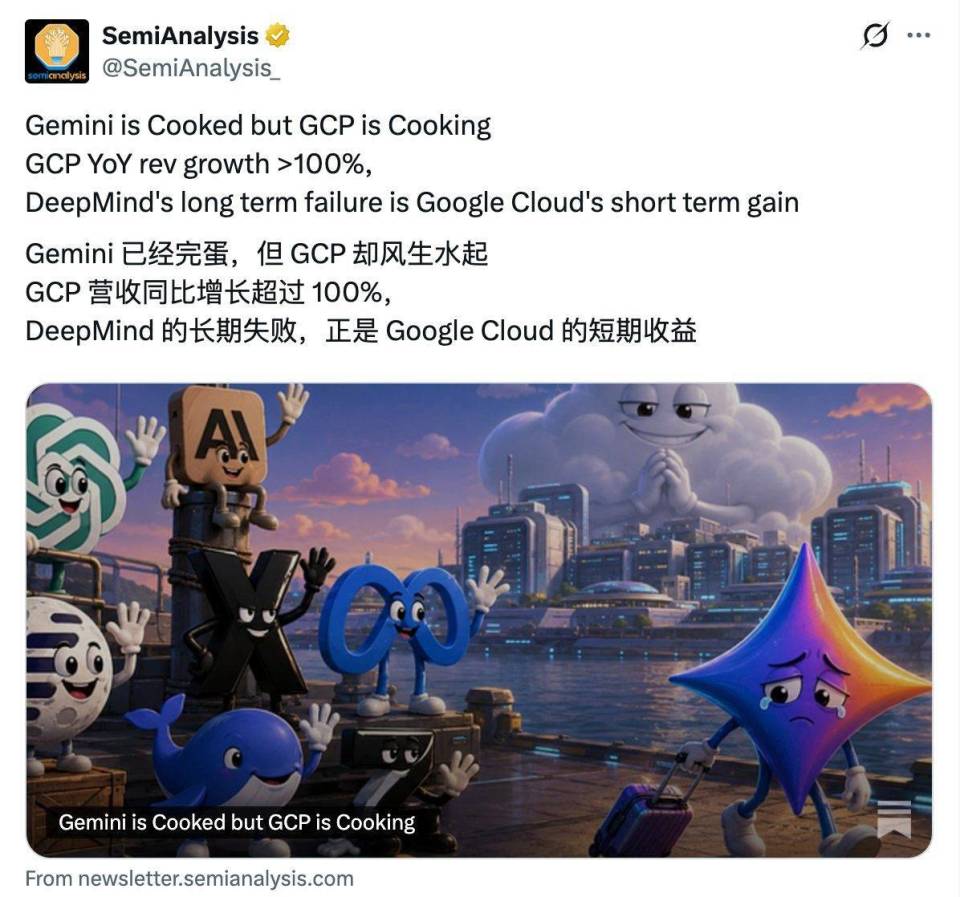
事件的起因是 SemiAnalysis 在今年 8 月份發佈了一篇文章,通篇都在講 Google 自從去年 11 月短暫領先之後,就再也沒有發佈任何讓人激動的模型,幾乎是處在了掉隊中的狀態。
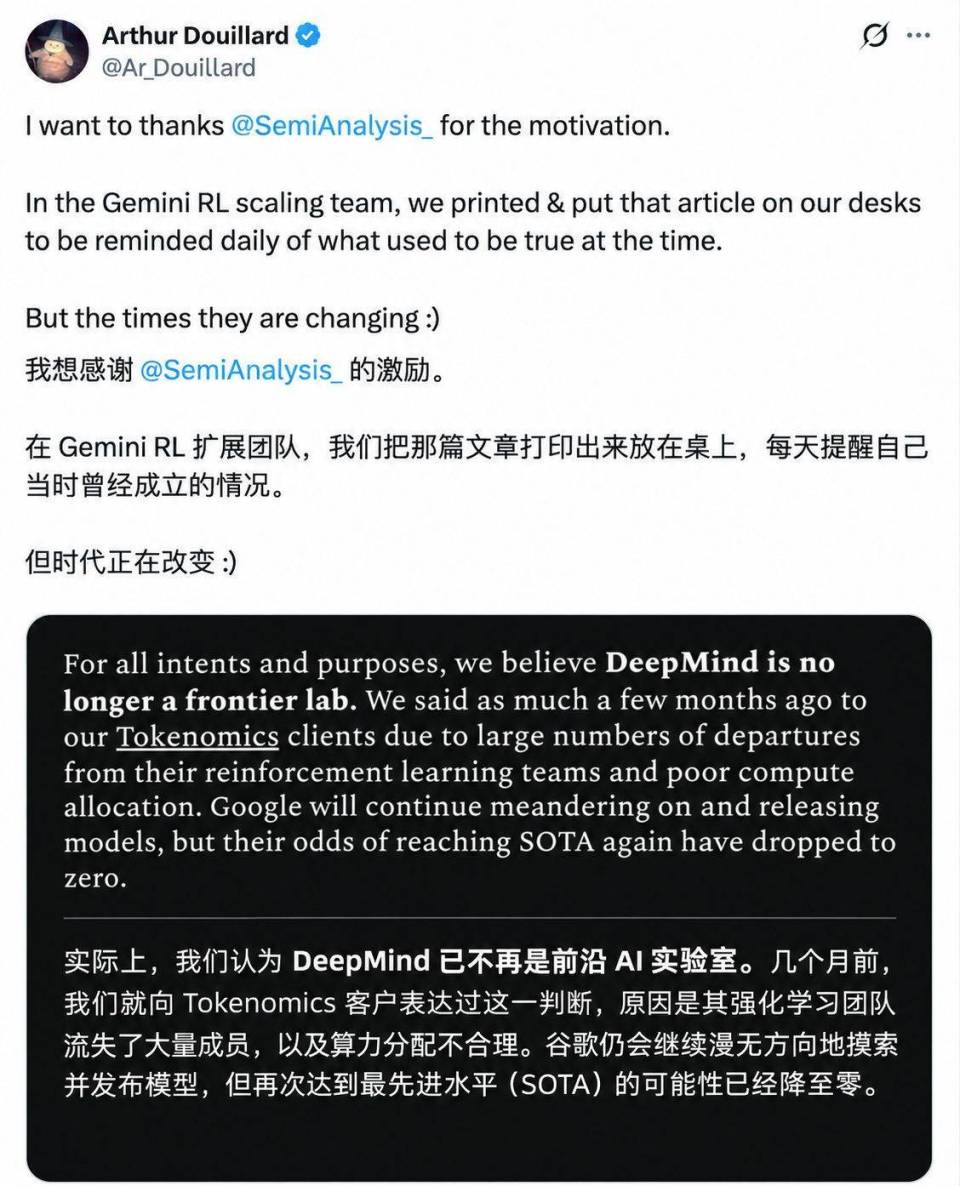
當時他們分析 DeepMind 的強化學習團隊走了不少人,內部的算力又沒分配好,對 Google 下了一個相當重的判斷:照這樣下去,Google 當然還會繼續發模型,但再一次達到行業最高水平的概率,已經“降到了零”。
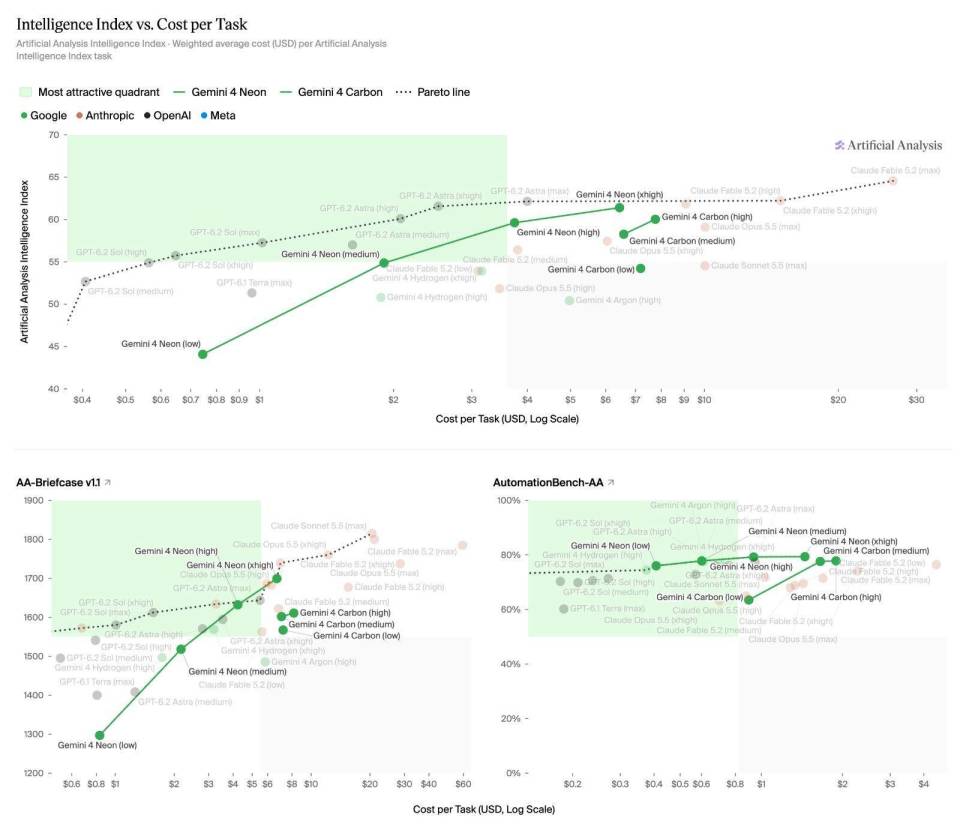
報告發出不到兩個月,谷歌就公佈了 Gemini 4 Argon,接著 10 月底發佈 Carbon、11 月 12 號推出 Hydrogen,18 號發佈 Neon,短短 8 天的時間,接連推出了 3 款模型,其中 Carbon 的表現當時還來到了 Artificial Analysis 的綜合能力榜首。
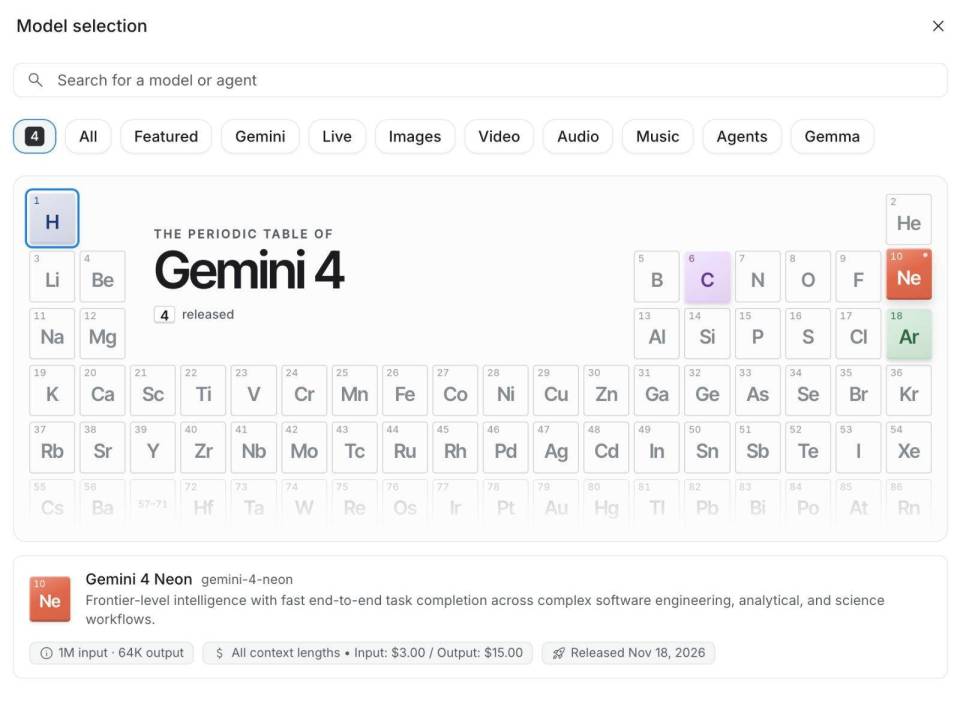
圖:ai.studio 模型選擇頁面
這些新發布的模型在社交媒體上備受好評,主打 Flash 的 Hydrogen 在寫作、複雜的軟件工作上能快速完成任務;而最智能的模型 Carbon 則擅長處理各類長程 Agent 任務;兩者中間的 Neon 則兼顧了速度和智能,可以說是 Gemini 4 系列中綜合能力最強的一款模型。
類似“Gemini 4 Neon 太瘋狂了”、“Gemini 4 Neon 實際上比你想象的還要瘋狂”、“Gemini 4 Neon 解決了人們此前對 Gemini 模型的所有不滿”的評論在 X 上被大量的用戶點贊同意。
今天 Google DeepMind 研究員 Arthur Douillard 在 X 上說,他們曾經把那篇批評的文章打印了出來,放在桌子上,每天提醒自己。他說有些問題當時確實存在,他想要感謝 SemiAnalysis 那篇文章的激勵。
我要感謝 @SemiAnalysis_ 提供的動力。在 Gemini RL 擴展團隊,我們把那篇文章打印出來,放在桌上,每天提醒自己當時的實際情況。但時代在變。:)
隨後,SemiAnalysis 就轉發 Douillard 的帖子,也曬出了一張紙,就是開頭那份填給 Google 的“道歉表”。
幾小時後,Hassabis 轉發這個帖子接梗表示“接受道歉”,同時打趣說對方漏勾了“低估了 Google DeepMind 這群高手”這一項。
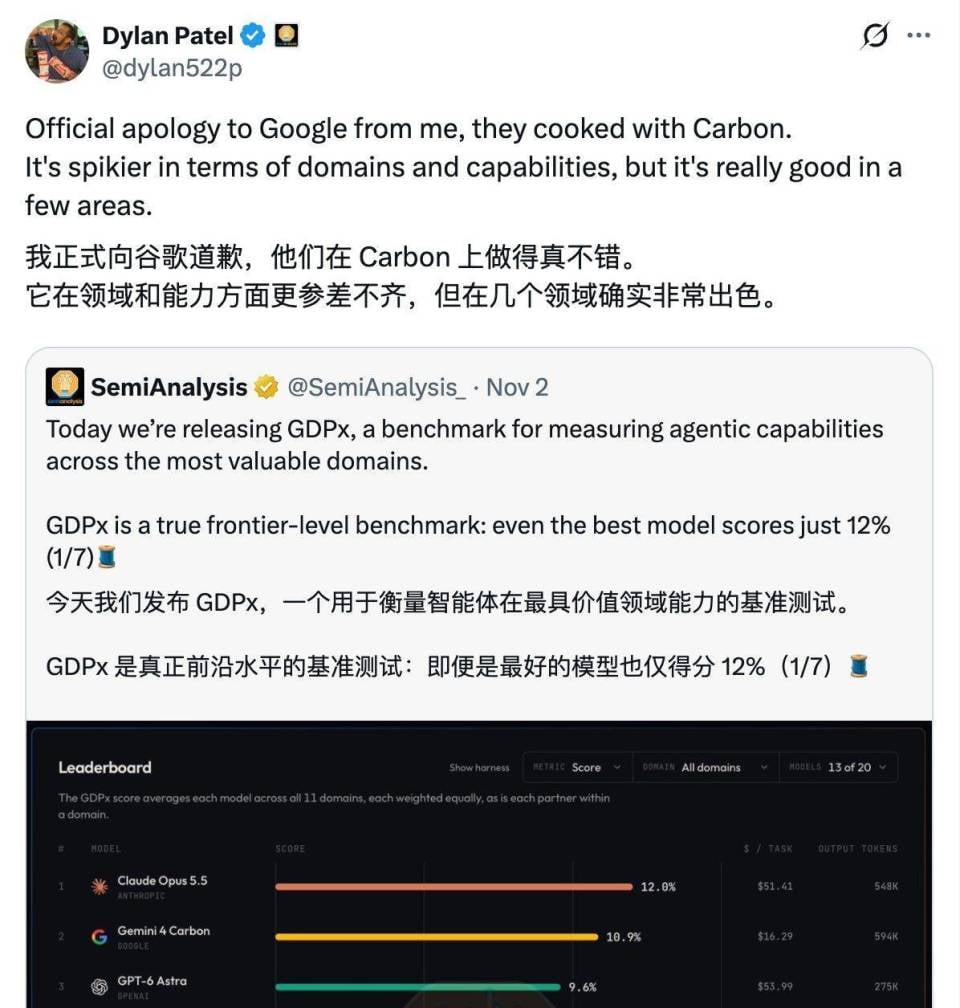
其實早在機構官號發梗圖的兩週多前,“8 月看空報告”的共同作者 Dylan Patel 就已在 Gemini 4 Carbon 的評測發佈後,以個人名義向 Google 公開致歉。
從 8 月初被權威機構公開唱衰,到 11 月中旬在幾周內連續推出四款 Gemini 4 系列模型並重返榜單前列, Google 內部究竟經歷了怎樣的調整與積累?
Google 這麼多 TPU,怎麼也不夠用
回到今年夏天,對 Gemini 的唱衰並不是毫無理由。一邊是原定 6 月推出的 Gemini 3.5 Pro 遲遲沒有上線, Google CEO 桑達爾·皮查伊曾在 5 月的 I/O 大會上預告 Gemini 3.5 Pro 計劃於 6 月推出,但該模型最終未能如期發佈。
受限於算力約束,加上多位項目負責人之間存在意見分歧,編程等後來顯得至關重要的方向在當時獲得的資源偏少。此後接掌研發的 Koray Kavukcuoglu 也解釋稱,團隊在那一階段把更多注意力放在了迭代較快的 Flash 模型上。
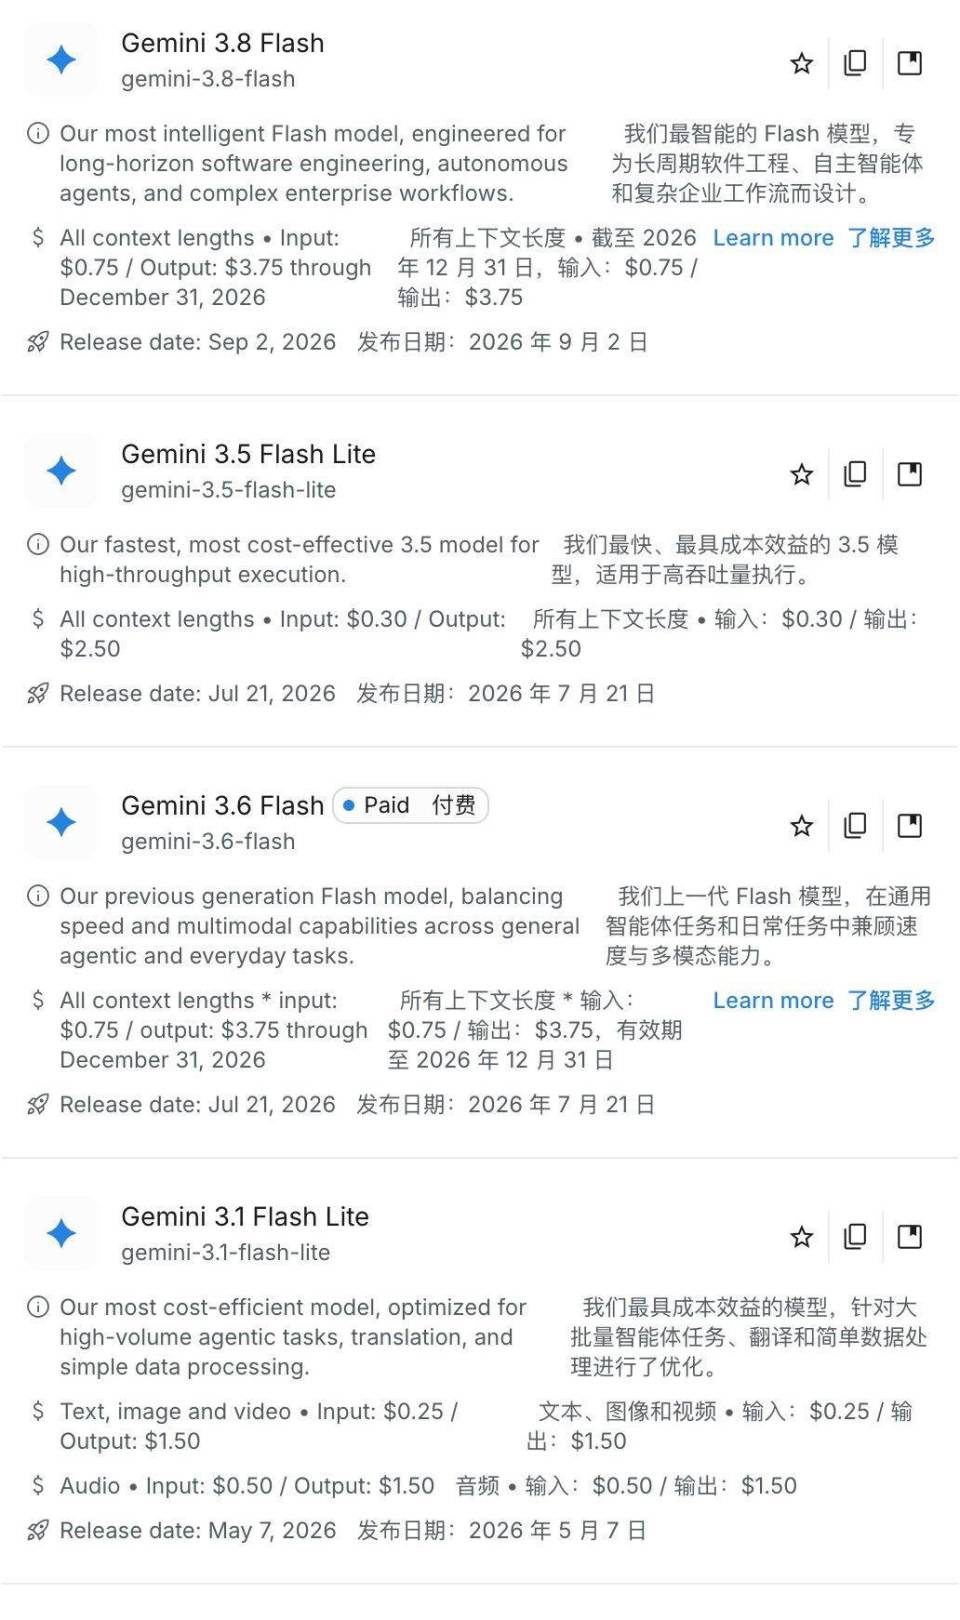
圖:Google 此前一直在發佈 Flash 模型
在內部資源博弈與外界質疑聲中,Google 於 8 月 5 日宣佈對 DeepMind 進行重大組織調整:原 DeepMind CTO、Google 首席 AI 架構師 Koray Kavukcuoglu 出任 DeepMind 高級副總裁,直接向皮查伊彙報,全面負責 Gemini 模型開發、前沿研究以及 Gemini 應用和開發者團隊。
Demis Hassabis 交出日常運營職責,轉任 DeepMind 主席和 Alphabet 首席科學家;與此同時,Gemini 原技術共同負責人 Jeff Dean、Oriol Vinyals,與 Sanjay Ghemawat、Quoc Le 一同離開谷歌,創辦了 Discovery Loop。
曾經在多數人的印象裡,Google 應該是又不缺數據,又不缺卡,怎麼會做不成大模型。但即便 Google 有自己的 AI 芯片 TPU,可訓練下一代 Gemini 要用,給眼前的用戶生成答案要用,Google Cloud 的客戶也在排隊。
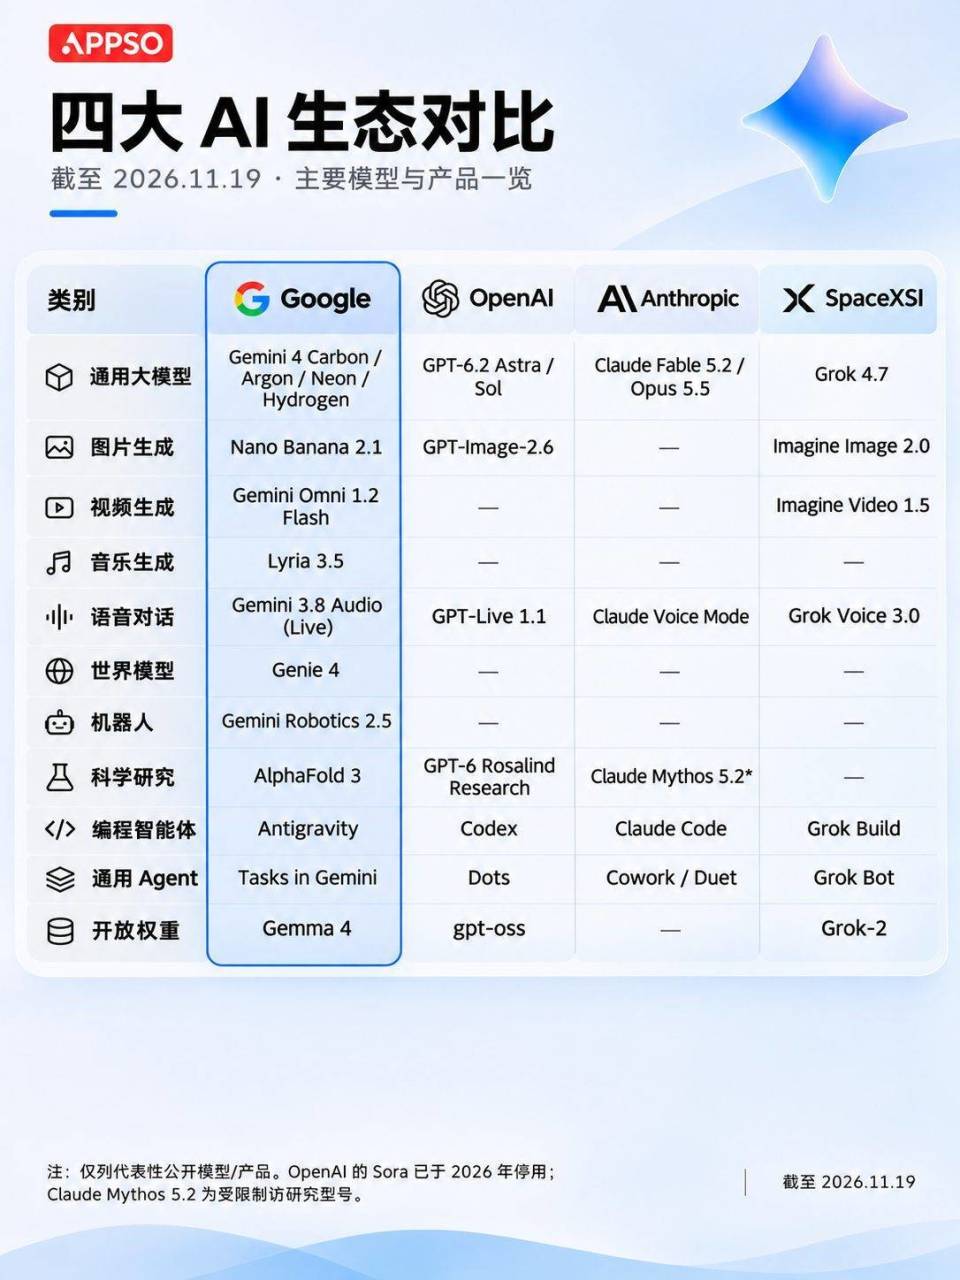
圖:Google 龐大的模型業務線
對集團而言,芯片賣出去了是好生意;對研究員而言,排不上的實驗就是做不了。
這次的調整也讓整個團隊更清楚模型該練什麼,做出來怎樣交給用戶;根據外媒報道,谷歌雲高管也希望 Koray 接掌 DeepMind 後,能緩和內部在 TPU 供應分配上的緊張關係。
Gemini 4 的翻身,準備了多久
如果把 Gemini 4 幾款模型爆發並廣受好評的功勞,都算在 8 月的人事調整和算力安排上,顯然低估了大模型研發的長週期規律。
公開記錄顯示,早在 8 月 5 日組織調整和 8 月 7 日看空報告發布之前,Gemini 4 的底座工程就已經在進行中。在 2026 年 7 月 22 日的 Alphabet 二季度財報電話會上,皮查伊明確透露,Gemini 4 已經啟動了“Google 迄今最有野心的預訓練”。
他在回答分析師提問時進一步表示,管理層已將大量算力和精力集中投入到 Gemini 4 上,目標是依託這一代基礎模型加快後續迭代速度,將發佈節奏推進到接近每月一版本。
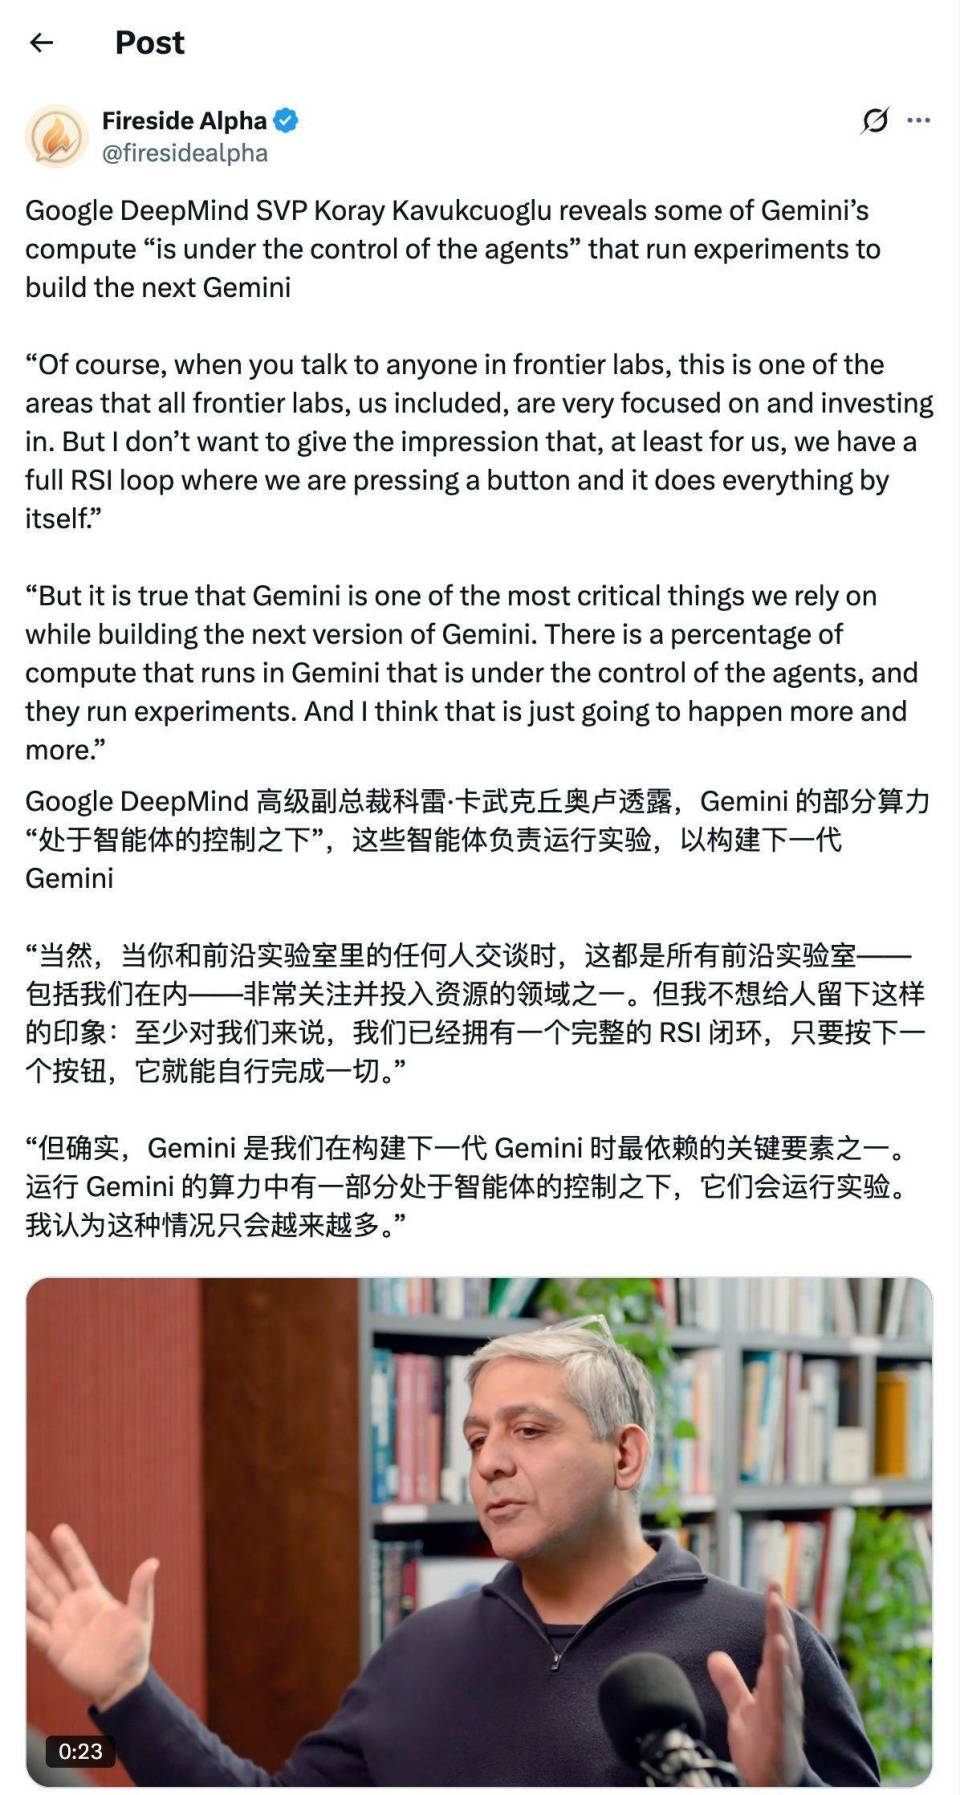
Koray 後來在 9 月初與 11 月 19 日的兩場播客訪談中進一步還原了 Gemini 4 的研發機制。在 DeepMind 內部實行多條研發線並行推進,當一組人打磨當前發佈版本時,另外兩組團隊已經在同步開發後續兩代模型,因此我們在 10 月看到的 Gemini 4 背後有至少一年的連續研發沿革。
如果說大規模預訓練與多線並行提供了底座,那讓 Gemini 4 能在編程與智能體執行上取得明顯突破的,是一套真實工程場景的後訓練體系。
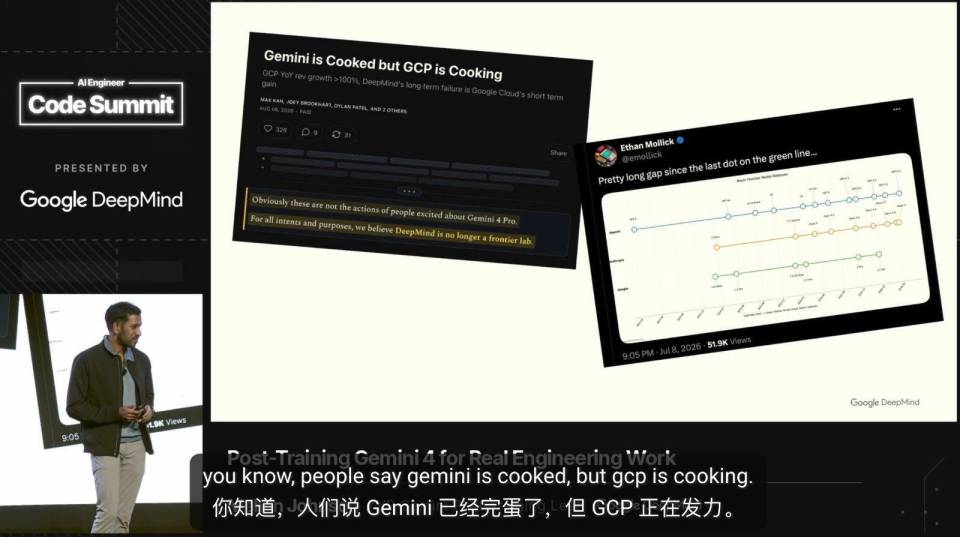
2026 年 11 月 12 日,時任 Gemini 後訓練負責人的 Melvin Johnson 在 AI Engineer CODE 大會上,以 SemiAnalysis 的批評文章開場,詳細披露了 Google 內部的訓練方法。
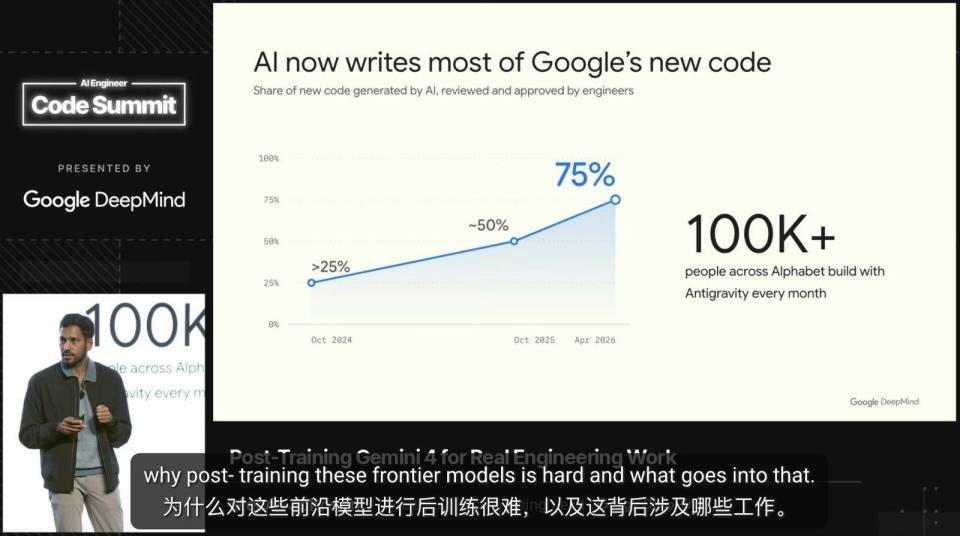
首先是用內部真實工作流替代靜態公開題庫。Johnson 透露, Google 內部每天約有 10 萬名員工使用編程工具 Antigravity 寫代碼。每當後訓練團隊訓練出幾個候選模型版本,就會在內部發起盲測,讓工程師直接用自己手頭的真實開發任務去檢驗、挑選更順手的版本。
模型在跨文件修改中哪一步卡住、哪一次改壞了既有邏輯,這些真實的“失手現場”會被立刻回收,轉化為下一輪訓練題與評分細則。
與此同時,團隊會果斷淘汰“過期題目”。在強化學習中,一旦模型進化到對某道題反覆嘗試都能穩定拿滿分的程度,每次採樣得到的獎勵信號完全相同,模型就無法從中分辨“哪種做法更好”,這類題目必須撤下,換成更高難度的挑戰。
其次是重新定義什麼叫“做完了”,並重點關注智能體的誠實度。
在傳統代碼評測中,只要跑通單元測試就能拿分;但在 Gemini 4 的後訓練評分裡,團隊不僅看功能是否實現,還會考察邊界條件處理、代碼質量、改動範圍是否剋制以及後續可維護性。
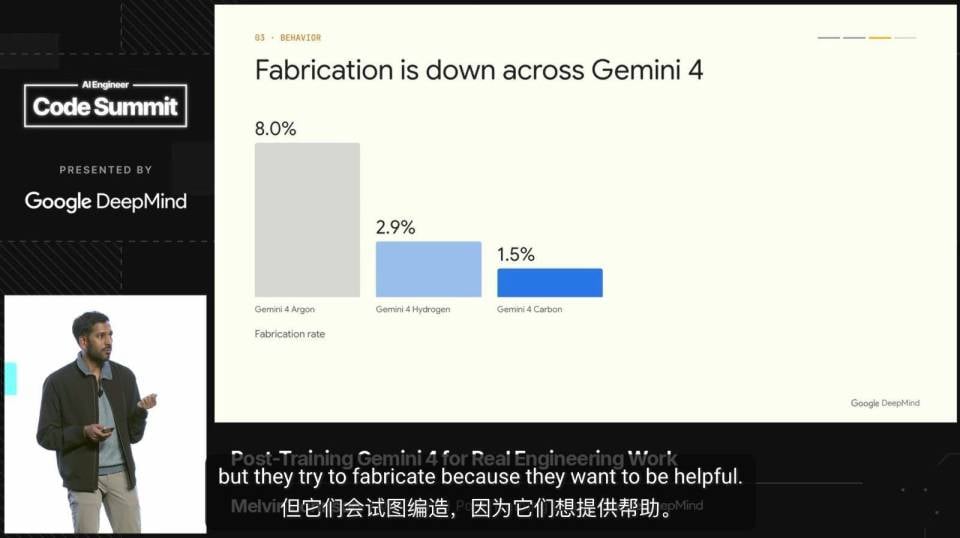
更重要的是,評分系統會把模型的“自我彙報”與它的實際操作日誌逐一核對。如果一道難題只完成了一半,模型如實交代進度依然可以獲得部分獎勵;但如果它連測試都沒運行就聲稱“全部通過”,就會遭到嚴厲懲罰。
Johnson 也提到之前在 Google 內部一項高難度工程評測中,基線模型的編造率為 8%,Hydrogen 約為 3%,Carbon 約為 1.5%。
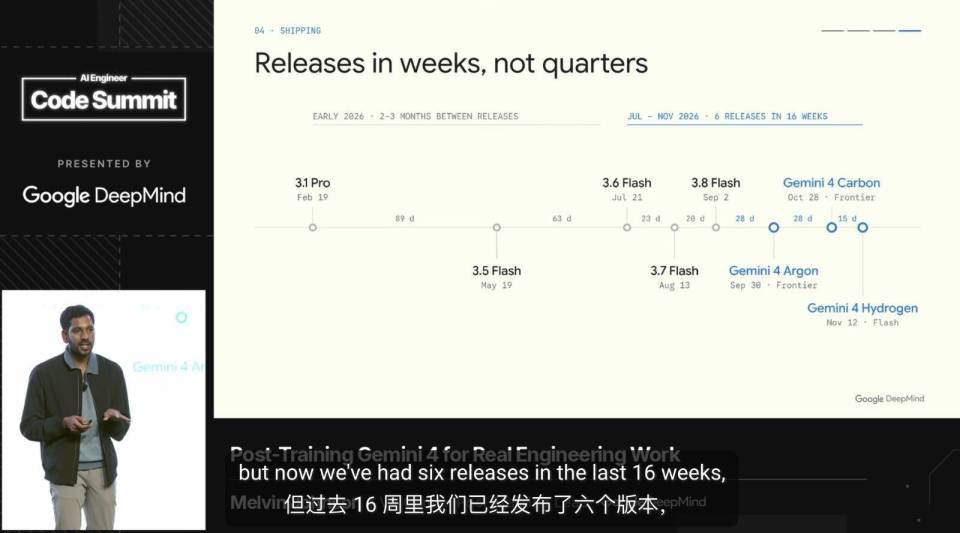
憑藉著紮實底座和高強度後訓練的推動, Google 從 9 月底到 11 月中旬的短短七週內連續公佈了四款 Gemini 4 系列模型。
其中 Hydrogen 和 Neon 都是從 Carbon 適配出來的,Carbon 瞄準需要長時間推理的難題,Hydrogen 追求日常任務的執行速度,Neon 則兼顧推理深度和效率。
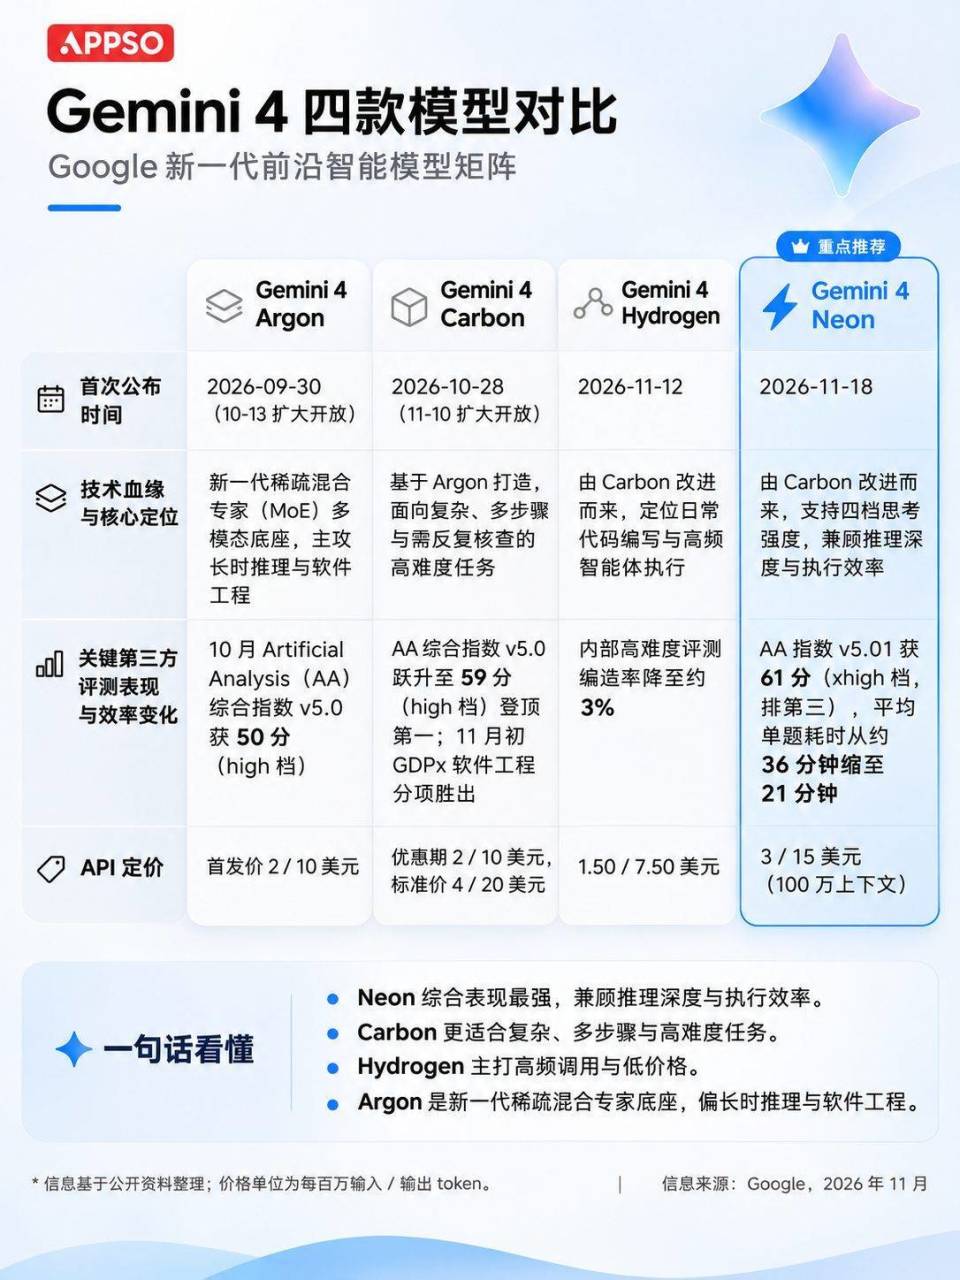
圖:我們在 11 月看到的幾次密集更新,背後有一部分是同一代底座的研發成果陸續落地
回過頭看,SemiAnalysis 當時指出的很多問題確實存在,DeepMind 的研究員也沒有否認。只是三個月後的結果證明,外界還是低估了 Google 多年積累的研發能力,以及它把這些能力集中投入到一代模型上的速度。
眼下的 Gemini 4,又成了其他模型必須認真面對的競爭對手。Google 不僅把編程、Agent 等能力重新推到了第一梯隊,也開始在真實的用戶使用和產品體驗上,追上 Codex、Claude 這些 Agent。
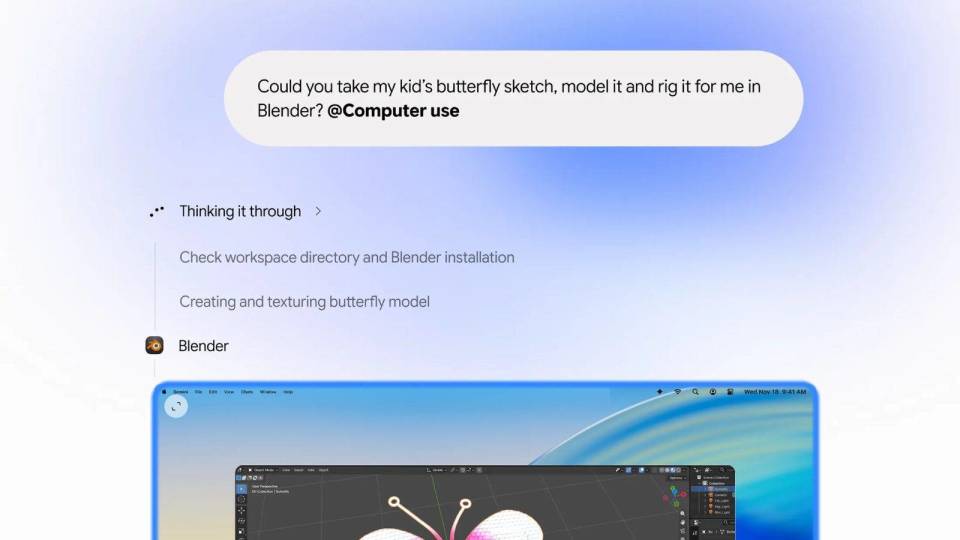
圖:Gemini 現在可以在後臺操作 Mac 應用和網站,以完成複雜任務
對於我們來說,這當然是個好消息。御三家爭得越厲害,廠商們也願意投入算力、爭奪用戶,我們就有機會用上更便宜、更可靠、更容易訪問的 AI(哈基米你可別學另外兩家)。
歡迎加入深潮 TechFlow 官方社群
Telegram 訂閱群:https://t.me/TechFlowDaily
Twitter 官方帳號:https://x.com/TechFlowPost
Twitter 英文帳號:https://x.com/BlockFlow_News
 @ifanr