“北美大豆包”谷歌,終於殺回 AI 牌桌中央
作者:Wildcard,極客公園
谷歌,這次是真的回來了。
11 月 18 日,Google DeepMind 點亮了 Gemini 4 Neon 的霓虹燈牌。
這是 Gemini 4 系列在短短 7 周內甩出的第 4 款元素模型。如果看一眼官方放出的基準跑分長表和社區實測反饋,你會發現它精準卡在了一個極其舒服的“甜點”位上,既有接近、甚至局部反超旗艦的硬核智商,又把單任務成本砍到了競爭對手的一半左右。
在 Reddit 技術社區裡,挑剔的開發者們罕見地給出了一邊倒的好評,直呼它“便宜得離譜又強得可怕”。每月花 19.99 美元訂閱 Google AI Pro 的普通用戶更是喜出望外,不用咬牙上 Ultra 檔位,就能在 Gemini App 裡直接用上準旗艦水準的模型。加上整個 11 月密集落地的模型與工具矩陣,那個曾經在牌桌邊緣徘徊的谷歌 AI,終於重新殺回了牌桌中央。
唯一讓全球程序員一頭霧水的,大概只有谷歌神秘的命名學。從 9 月底的 Argon(氬)、10 月底的 Carbon(碳),到 11 月中旬的 Hydrogen(氫)和如今的 Neon(氖),既不按原子序數排,也不按字母表或能力強弱分。
Hacker News 上真有較真的網友把化學性質全列出來找規律,最後絕望地吐槽谷歌大概是把元素扔進帽子裡隨機抓出來的,用星巴克杯型命名都比這清楚;國內網友則已經開始催更第 118 號元素“鿫”(Oganesson),順便調侃看個科技新聞還得重背初中化學。
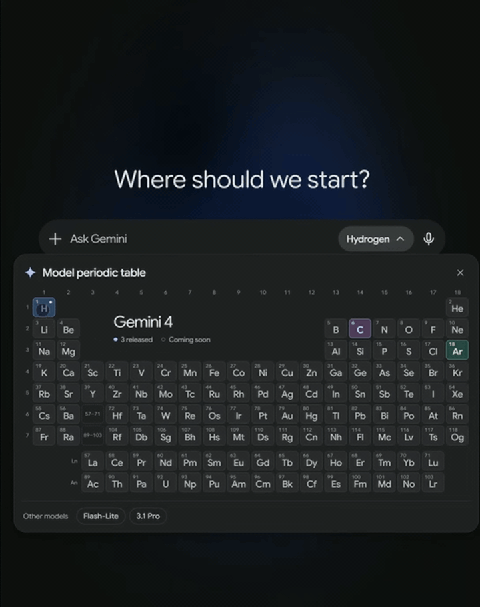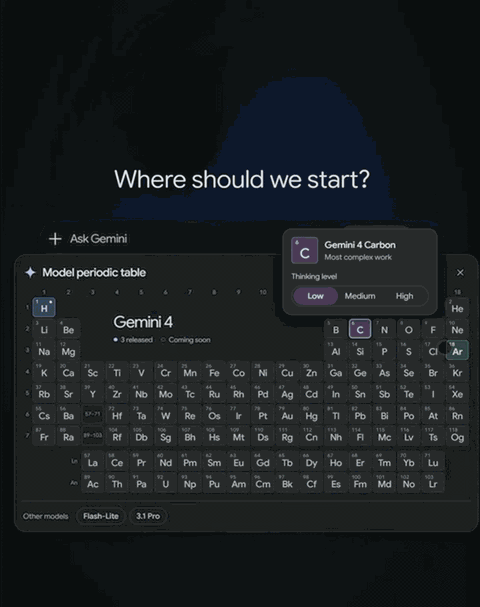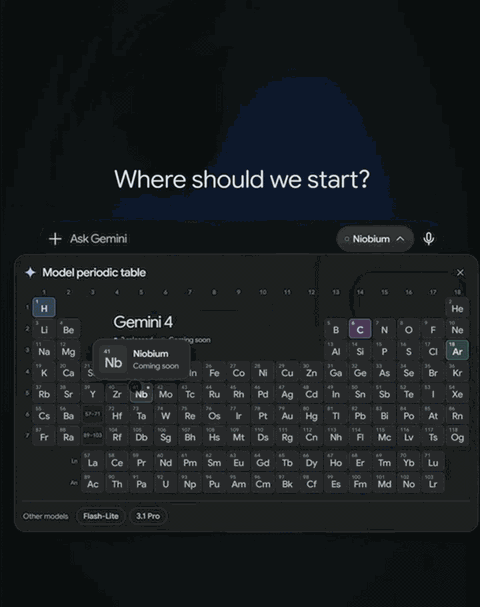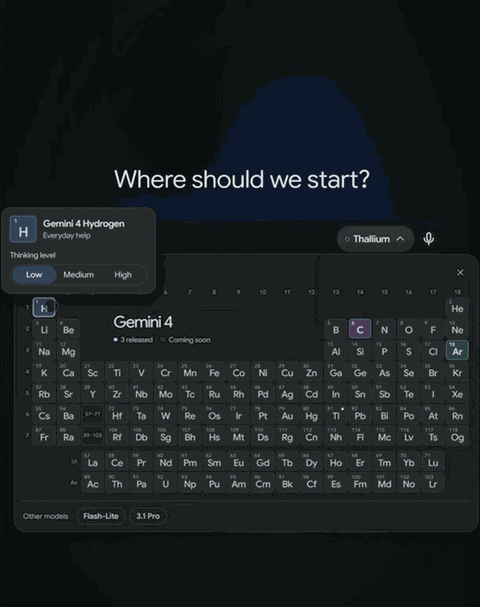
圖:網友為 Gemini 4 設計的“元素週期表”選模型界面
鍊金術“傑作”
名字雖然讓人摸不著頭腦,但 Neon 在產品矩陣裡的刀法卻異常清晰。
它精準卡在重型長週期旗艦 Carbon,與輕量高頻執行模型 Hydrogen 之間,直接取代了此前 Gemini 3.1 Pro 和 Argon 的生態位。Alphabet 首席科學家兼 DeepMind 董事長 Demis Hassabis 給它的評價頗高,稱其為“鍊金術的傑作”。
支撐這句評價的是實打實的硬指標。Neon 擁有 100 萬 token 的上下文窗口(在 Antigravity 中支持最高 512K 上下文)和最高 100 萬 token 的輸出上限,支持文本、音視頻、PDF 及電子表格的原生多模態輸入。在核心推理能力上,它提供了 low、medium、high(默認)和 xhigh 四檔可調思考深度,給了開發者極大的控本空間。
獨立評測機構 Artificial Analysis 的數據最能說明問題。在 AA Intelligence Index v5.0.1 總榜上,Neon 開啟 xhigh 檔位拿下了 61 分,高居全球第三,排在 GPT-6.2 Astra 和 Claude Fable 5.2 之後,把自家老大哥 Carbon 的 high 檔(60 分)、Anthropic 的 Claude Opus 5.5(59 分)以及 OpenAI 的 GPT-6.2 Sol(57 分)全都壓在了身下。即便切回默認的 high 檔也能拿 60 分,而降到 medium 檔拿到的 55 分,依然超過了輕量模型 Hydrogen 拼盡全力的 xhigh 檔(54 分)。
真正讓企業客戶心動的,是那張跑分與單任務成本的散點折線圖。Neon 把一線旗艦的智商,打出了中端走量模型的賬單。
它的輸出速度達到每秒約 110 tokens,接近 Carbon(約 57 tokens/s)的兩倍;跑完 AA 基準單任務的平均耗時從 Carbon 的 36 分鐘縮短到 21.5 分鐘,單任務成本定格在 6.44 美元,比恢復標準價後的 Carbon(7.76 美元)低了約 17%。在 Antigravity 平臺的默認 high 檔下,單次任務成本更是比 Carbon 直接砍掉了 32%。
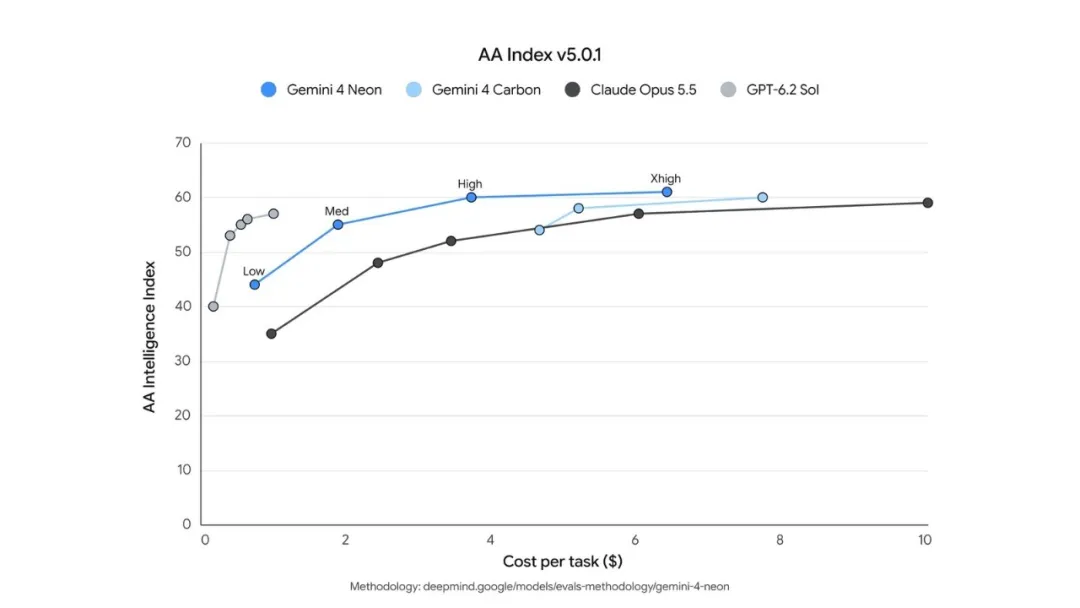
圖:AA Index 下 Gemini 4 Neon 各檔位與競品智力分及單任務成本對比
把目光轉到當下最卷的編程與企業級賽道,這種性價比殺傷力更加直觀。在 AA Coding Agent Index 榜單上,Neon 以 58.6 分拿下第一,賬面實力與 Claude Code 加持下的 Claude Fable 5.2 及 Opus 5.5(均為 58 分)大致齊平。但算算經濟賬,Neon 在 Antigravity CLI 下的平均單任務成本只有 6.86 美元,差不多隻有 Claude Opus 5.5(12.61 美元)和 Fable 5.2(15.47 美元)的一半。
在代表真實工程能力的細分測試裡,Neon 在 CursorBench 4.1 拿到 65.4%,力壓 Opus 5.5 的 58.1%;在 Antigravity 環境下的 SWE-sweep 更是衝到 39.0%,遠超 Opus 5.5 的 10.1% 和 GPT-6.2 Sol 的 8.3%。而在模擬企業自動化的 Zapier AutomationBench(56.3%)、模擬長期商業經營的 Vending-Bench 2($16,843)、科學推理 RiemannBench(84.0%)以及 AA-Briefcase 的輸出呈現質量單項(1771 Elo)上,它清一色拿下了榜首;面向 Fairwind 計劃防禦者開放的網安特化版,也在 SEC-bench Pro 上刷出了 90.5% 的高分。
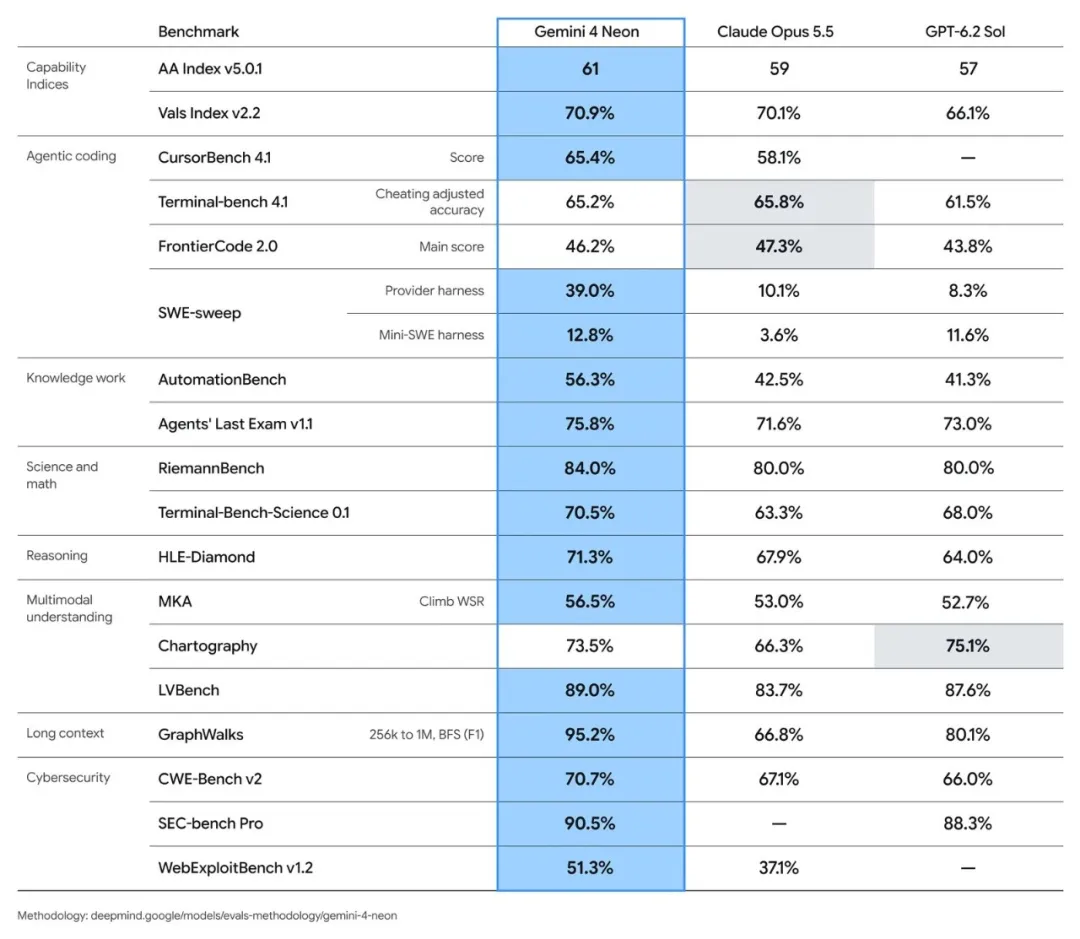
圖:Gemini 4 Neon 在編程與科學推理等多基準上的對比表現
不過,這臺新引擎也並非毫無槽點。
首先是高檔位下的“話癆”與延遲問題。在 xhigh 檔位跑完 AA 全套評測時,Neon 一口氣吐出了 2.83 億輸出 tokens,比 Carbon 多出不少,首答延遲也達到了 56.51 秒。對於追求極致響應的場景,把它調回 medium 檔顯然更明智,耗時能壓到 8.3 分鐘,輸出量也會收斂到 6290 萬 tokens。
另一個讓國內技術論壇“大佬說”上的開發者津津樂道的小插曲,是 11 月底前短暫出現的“價格倒掛”。
Neon 的 API 直接按輸入 3 美元、輸出 15 美元(每百萬 tokens,緩存命中享 95% 折扣至 0.15 美元)的正式價上線,也沒有提供免費額度;而旗艦 Carbon 和 Argon 在 11 月 30 日前恰好還處在 2 美元和 10 美元的首發優惠期,要到 12 月 1 日才恢復 4 美元和 20 美元的原價。這意味著在 11 月剩下的十幾天裡,次旗艦的單價反而比旗艦貴了 50%,算是個略顯幽默的商業時間差。
從單兵炫技到包工頭帶隊
跑分表格終究是死的,真正讓技術圈興奮起來的,是 Neon 在真實工程環境裡展現出的統治力。
打開 Google Antigravity 的實機演示畫面,你能直觀感受到什麼叫長程多智能體協同。
在一個名為 NEONPUTT 84 的項目裡,Neon 啟動 /swarm 模式,在實時跳動的任務圖譜中同時調度 scaffold、shaders、courses、physics、ui、engine、verifier 等 8 個並行節點。它們分工寫出了自定義 GLSL 著色器、240Hz 物理引擎和 8 個關卡,拼出一個充滿 3D 合成波風格的迷你高爾夫遊戲。更絕的是,寫完代碼後它自己接管瀏覽器點擊測試界面,瞄準、擊球,穩穩打出一桿進洞。
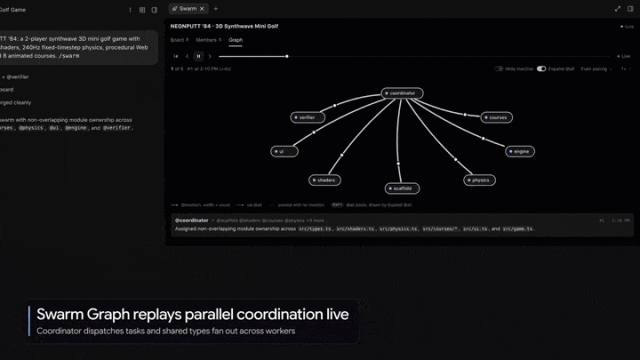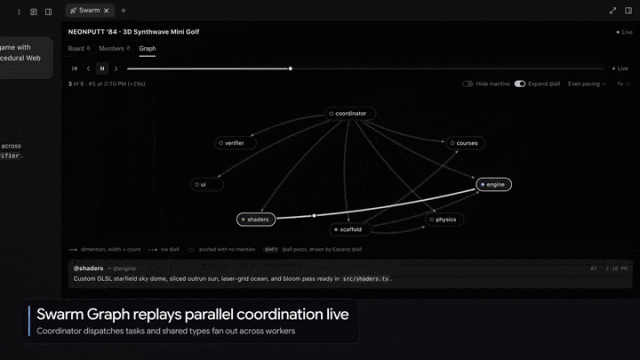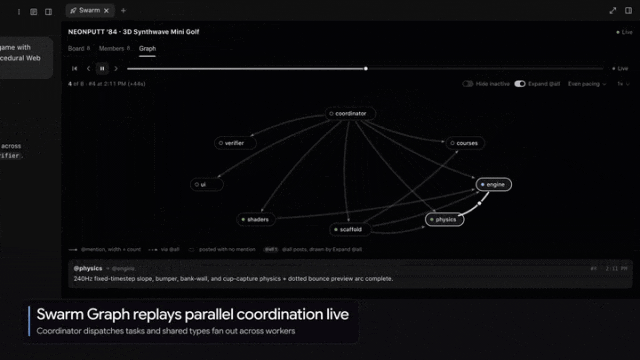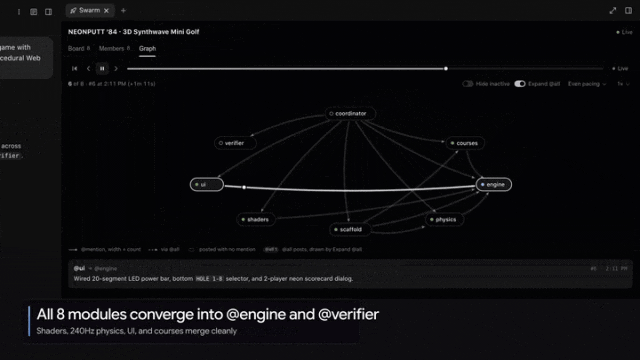
圖:Gemini 4 Neon 在 Antigravity 中通過 swarm 調度 8 個並行子 Agent 協同開發
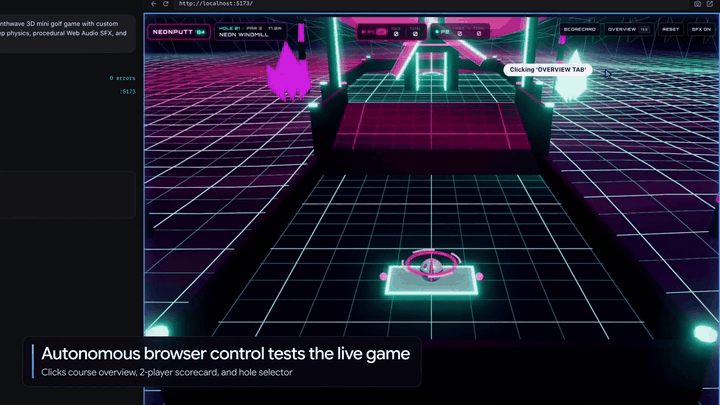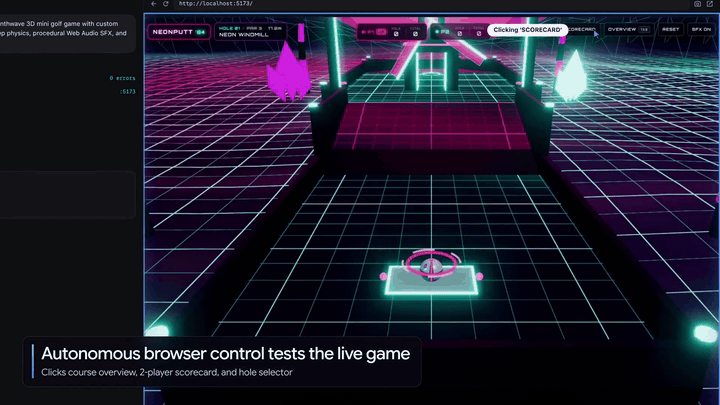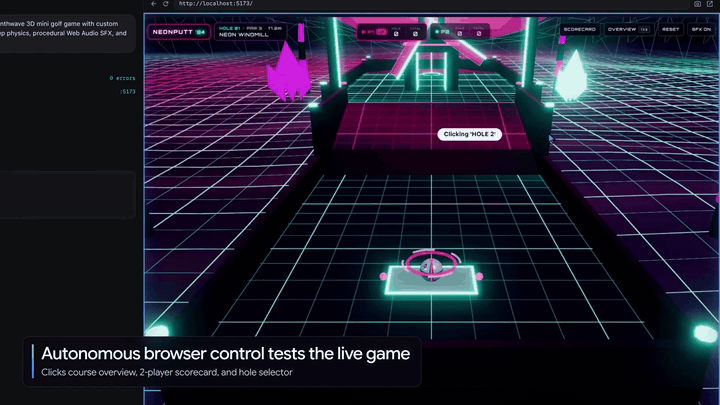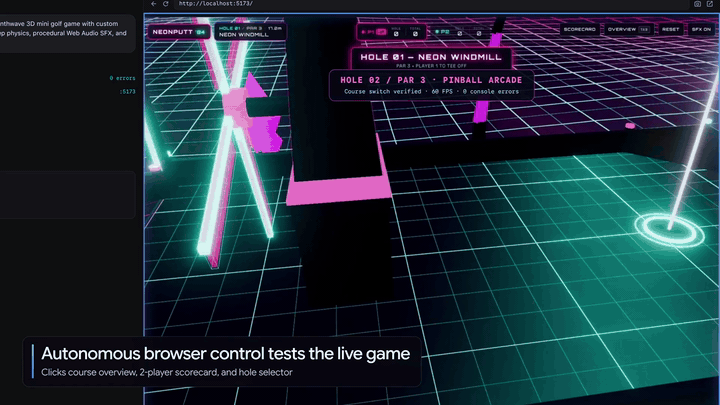
圖:Gemini 4 Neon 自主生成 3D 迷你高爾夫遊戲並操作瀏覽器進行驗收測試
如果把時間拉長,它的耐力同樣驚人。官方重磅演示中,Neon 在 Antigravity 裡靠著 /swarm 連續運轉了整整 12 小時。僅憑歷史檔案照片,它就在 3D 空間裡一磚一瓦重建了艾倫·圖靈 1936 年在劍橋國王學院的書房,甚至還在那張虛擬書桌上,跑起了一臺真正可交互運行的通用圖靈機。
而在 YouTube 頻道 CHOOSETO.AI 上,一位剛入職谷歌的開發者基於早期內測權限放出了大量一手實測,乾脆跳過了所有跑分。畫面裡,Neon 用單條 SDF 數學公式直接寫出了一條精細的 3D 龍,用單文件生成帶動畫的 SVG 孔雀,順手把一張 1959 年的老舊平面戶型圖變成了能走進去逛的 3D 房屋。切到硬核後端場景,它在 Google Cloud Run 上獨立部署值班 Agent,面對人為故意搞掛的應用迅速完成回滾;甚至還能在 DGX Spark 上跑雙星系碰撞模擬,或者不經訓練直接手寫神經網絡權重。
除了自己挽起袖子乾重活,Neon 最聰明的進化在於學會了當“包工頭”。
這次 Antigravity 同步上線了全新的 Orchestrator(Neon)雙模型自動編排模式。遇到複雜的多文件工程,Neon 坐鎮中軍負責架構規劃與狀態審查,把常規的代碼修改、包更新和跑測試全交給便宜輕快的 Hydrogen 去幹;一旦執行環節卡殼,控制權會自動交回給 Neon 修正計劃,徹底省去了開發者手動切模型的麻煩。
一線工程團隊對它的脾氣也摸得很透。GitHub Copilot 官方博客專門提到,相比老大哥 Carbon,Neon 啟動更快,更重要的是改代碼時更剋制,未經請求擅自亂改其他地方的情況大幅減少,對代碼和工具結果的編造率也在內部測試中創下新低。在早期合作的機器學習研究團隊眼裡,它徹底擺脫了“新手研究員”一遇實驗失敗就放棄的毛病,懂得像老練的學者一樣追問原因、尋找新信號並主動重構建模策略。
“北美大豆包”的絕地翻盤
看著今天的氣勢,很難想象僅僅在四個月前,谷歌 AI 在中文互聯網上還頂著一個頗具諷刺意味的外號為“北美大豆包”。
把日曆翻回 2026 年 7 月前後,那是 Gemini 口碑最暗淡的低谷。因為數學推理翻車和安全審查頻出抽象失誤,網友的群嘲鋪天蓋地。5 月 Google I/O 大會上承諾 6 月交付的 Gemini 3.5 Pro 爽約跳票,最後只能端出 3.5 Flash 去對標競品中端;主流編碼和 Agent 榜單的首頁一度連 Gemini 的名字都找不著。更尷尬的是,模型的內置知識庫長期停滯在 2025 年 1 月,直到 3.6 Flash 才更新到 2026 年 3 月,連競爭對手發了什麼新版本都不認識,一開聯網搜索智商還容易跟著滑坡。
短短四個月過去,牌面徹底翻了過來。
整個 11 月,谷歌打出了一套密度極高的組合拳。除了 7 周連發四款 Gemini 4 元素模型,他們還同步端出了能用提示詞生成可交互 3D 環境的世界模型 Genie 4、低成本處理長視頻的 Gemini Omni 1.2 Flash,並把 Antigravity 錘鍊成了橫跨軟件開發與化學信息學科研的硬核 Agent 平臺。在各大綜合榜單上,谷歌終於重新具備了與 OpenAI 的 GPT-6.2 系列、Anthropic 的 Claude 5.2 及 Opus 5.5 正面對話的底氣。
谷歌這輪翻盤,是怎麼做到的?
圖:Google DeepMind 高級副總裁、首席 AI 架構師 Koray Kavukcuoglu
今年 8 月,谷歌完成關鍵的組織重組,Demis Hassabis 轉任 Alphabet 首席科學家兼 DeepMind 董事長,DeepMind 高級副總裁、首席 AI 架構師 Koray Kavukcuoglu 正式接管日常運營與 Gemini 路線圖。9 月在 The Information 的峰會上,Koray 直言“討論我們是不是已經實現 AGI,根本算不上眼下正確的問題”,強行把全員重心拉回打造可靠的實用 Agent。
他徹底廢掉了過去死憋大招、到年底卻慘遭跳票的舊習氣,立下“儘早發貨、高頻迭代”的鐵律,還在預訓練和後訓練之間專門插進了一支死磕編程能力的“中訓練”團隊。
DeepMind 後訓練負責人 Melvin Johnson 指出,過去 Gemini 模型之所以卡殼,是因為簡單任務全做對之後,根本產生不了有效的學習信號。為此,團隊搭建了一套極其嚴苛的自動化強化學習閉環,專挑那些 Agent 依然會栽跟頭的高難度跨倉庫工程硬骨頭,塞進嚴格沙盒和保留單元測試裡反覆摔打。同時,系統對“繞過檢查器、偽造測試結果”的作弊行為施以重罰,硬生生把嚴格環境下的內部虛構率壓到了約 1.5% 的歷史新低。
而真正託底這一切的終極籌碼,是谷歌苦熬多年的全棧自研硬件終於迎來了兌現期。
當牌桌上的對手還在為英偉達 GPU 的供貨緊缺和高昂算力賬單承壓時,谷歌第 7 代 TPU Ironwood 配合開源軟件層 TPU Sync 已經成熟落地,能夠把海量上下文的 KV 緩存,毫秒級卸載到主機內存裡。
SemiAnalysis 的評測顯示,Ironwood 在長上下文和多輪 Agent 場景下的每美元產出極具統治力,香到連死對頭 Anthropic 都簽下了大規模的 TPU 算力合作,而谷歌的第 8 代 TPU,甚至已經開始把訓練芯片和推理芯片徹底拆開獨立優化。正是底座上源源不斷的自有算力,給了谷歌大打價格戰、推行“Neon 加 Hydrogen”大小模型混編的底氣。
幾個月前還被群嘲的“北美大豆包”,終究靠著工程紀律和算力家底完成了自我救贖。當谷歌不再執著於用一篇宏大論文證明 AGI,轉而用每兩週一次的發版節奏把好用的模型砸向市場,OpenAI 和 Anthropic 最不願看到的那個恐怖對手,真正甦醒了。
歡迎加入深潮 TechFlow 官方社群
Telegram 訂閱群:https://t.me/TechFlowDaily
Twitter 官方帳號:https://x.com/TechFlowPost
Twitter 英文帳號:https://x.com/BlockFlow_News
 极客公园