

從 AGI 到 ASI:通往超級智能的四條路
作者:Tim Genewein,Google DeepMind
編譯:深潮 TechFlow
深潮導讀:數十年來,人工智能研究始終聚焦於一個劃時代的里程碑:構建具備人類智力水準的通用人工智能(AGI)。然而,隨著前沿模型的推理能力與認知邊界以指數級速度跨越式演進,人類必須直面一個更具深遠影響的時代課題:AGI 之後究竟會發生什麼?
Google DeepMind 研究科學家 Tim Genewein 發表長文,將通用智能置於連續演進的宏大座標系中,全面解構了驅動認知工業化的底層飛輪,並詳盡剖析了從專家級 AGI 邁向全面超越人類群體智慧的超級智能(ASI)所依賴的四條技術路徑。
數十年來,整個人工智能學術界與工業界的研究焦點,始終牢牢鎖定在一個極具象徵意義的宏偉里程碑之上:打造出達到人類智慧水平的通用人工智能(AGI)。
隨著底層算力基礎設施與大語言模型架構的迅猛突破,AGI 正在從遙不可及的理論假說,逐步演變為觸手可及的現實可能。此時此刻,我們再也無法迴避一個更為關鍵的嚴肅叩問:在 AGI 達成之後,技術與文明究竟將駛向何方?
從 AGI 向超級智能(ASI)的躍遷絕非一蹴而就的單一事件,而是一場由多條互補交織的技術路線共同驅動的長週期演進。為了理清這幅複雜的未來圖景,我們需要建立起嚴密的認知座標系。
通用智能的連續譜系
若要推演高級人工智能的未來展開方式,最清晰的方法是將不論是生物學還是機器承載的通用智能,視作存在於一條連續平滑的光譜之上。
處於中段的人類水平 AGI,僅僅是這條漫長光譜上的一個特定節點。在此之前,人類已經研發出了狹義非通用 AI,以及處於萌芽期和發展期的各類基礎大模型系統。
而超級智能(ASI)則坐落在這條光譜更靠右側的高階位置,它被定義為一種在絕大多數經濟、科研與決策領域,能夠全面且穩定地超越由人類頂尖專家群體構成的集體智慧的高級實體。
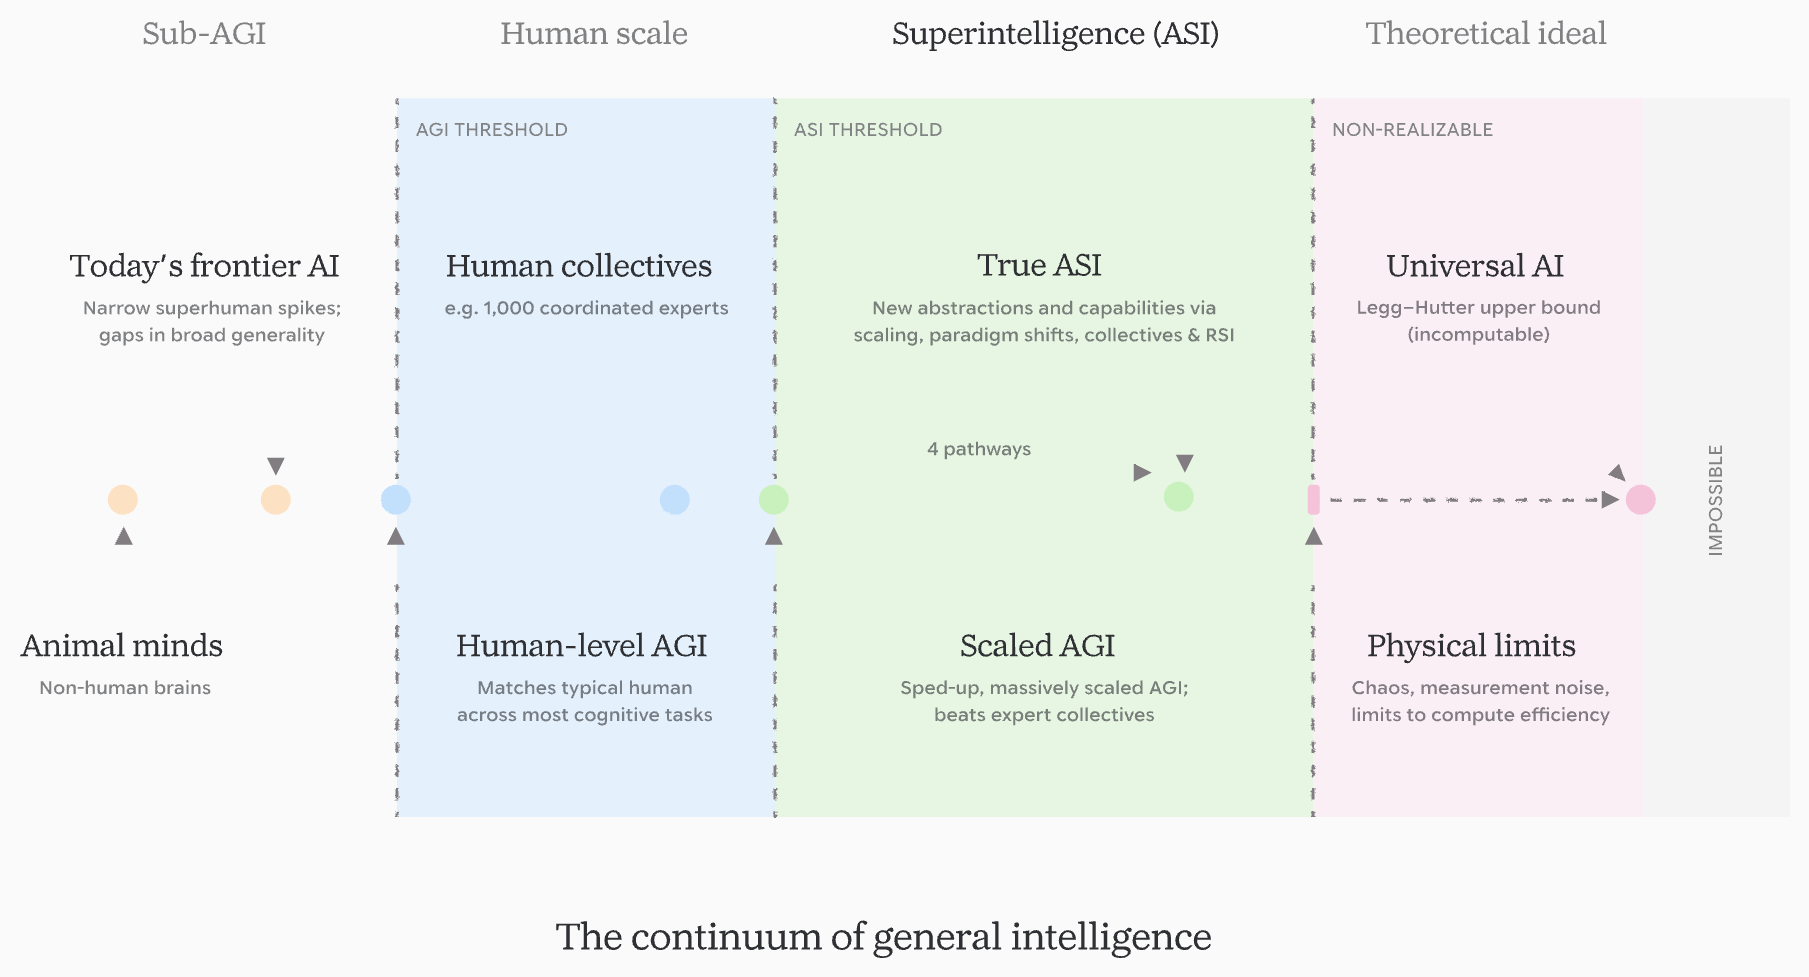
圖:通用智能的連續譜系從人類水平延伸至理論上限(Google DeepMind)
從純數學角度來看,我們對於智能光譜最頂端的理論物理與數學極限已經有了相對嚴謹的理解,例如理論計算機科學中的最優化計算與信息熵界限。
然而,僅僅知曉終極上限,並不能清晰描繪出通往峰頂的具體山徑。即便是理論上被證明為最優的算法,其完全落地往往也需要超出地球上所有算力總和的天文數字資源。
現實中更具實用價值的飛躍,往往發生在次優啟發式算法與高效工程架構的交匯處。在專家級 AGI 與全面超越人類的 ASI 之間,存在著一片亟待技術先驅深入探索的無人區。
認知工業化:有效算力的三重複合飛輪
即使部分觀察者對前沿模型單點能力突破的持續性持有悲觀態度,整個產業界正在發生的一場更深層次的變革同樣不可阻擋:認知工業化(Cognitive Industrialization)。
在過去十年中,推動人工智能突飛猛進的根本燃料,是有效算力(Effective Compute)的複合指數級增長。這一持續膨脹的飛輪由三大互為乘數效應的核心支柱共同鑄就:
其一,硬件製造工藝迭代:在摩爾定律及其衍生物理架構的演進下,單位美元所能購買的硬件計算浮點性能在過去幾十年中保持著年均約 1.5 倍的複合增長。
其二,算法效率質的躍升:在過去十年中,訓練出同等智力基準表現模型所需的絕對算力消耗,以每年 3 至 6 倍的速度斷崖式下降;而在模型推理端,算法與量化部署的效率提升每年也達到了約 3 倍。
其三,算力基礎設施投資規模暴增:全球針對人工智能專用算力硬件的資金投入以每年約 2.5 倍的速度急劇放大,大模型訓練集群正在向數十萬卡規模全速邁進。
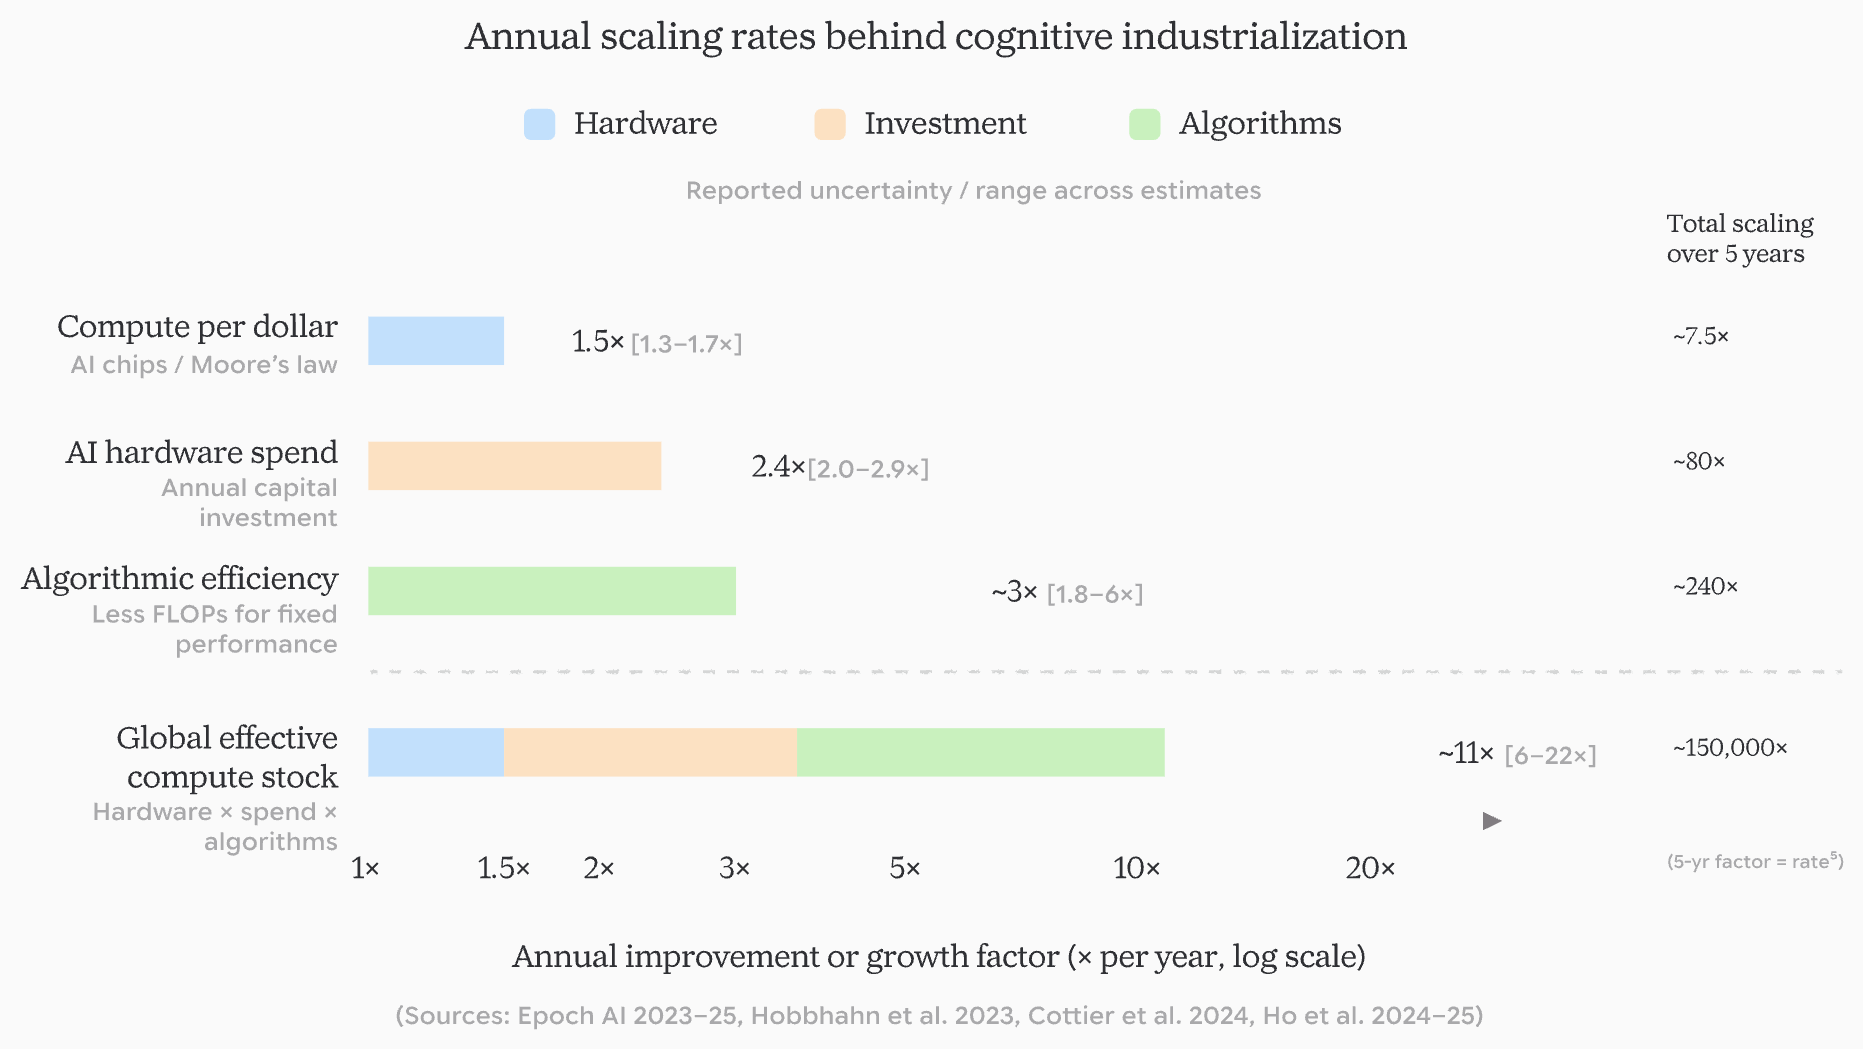
圖:複合驅動力推動有效算力指數級擴張(Google DeepMind)
當這三股力量相互疊加時,全球有效算力的供給呈現出每年一個數量級以上的驚人膨脹。這就意味著,即便前沿底層架構在短期內停滯不前,已有 AGI 級別能力的邊際邊際成本也將被急速壓縮至近乎零。
這種認知生產力的工業化普惠,使得社會有能力同時調用數以百萬計的數字專家,將此前需要耗費人類數代人的科學難題與工程任務在極短週期內並行碾壓解決。
從 AGI 走向 ASI 的四條核心路徑
然而,技術演進的腳步絕不會止步於對存量能力的規模化複製。在邁向真正超級智能的過程中,Google DeepMind 梳理出了四條截然不同卻高度互補的關鍵演進路徑:
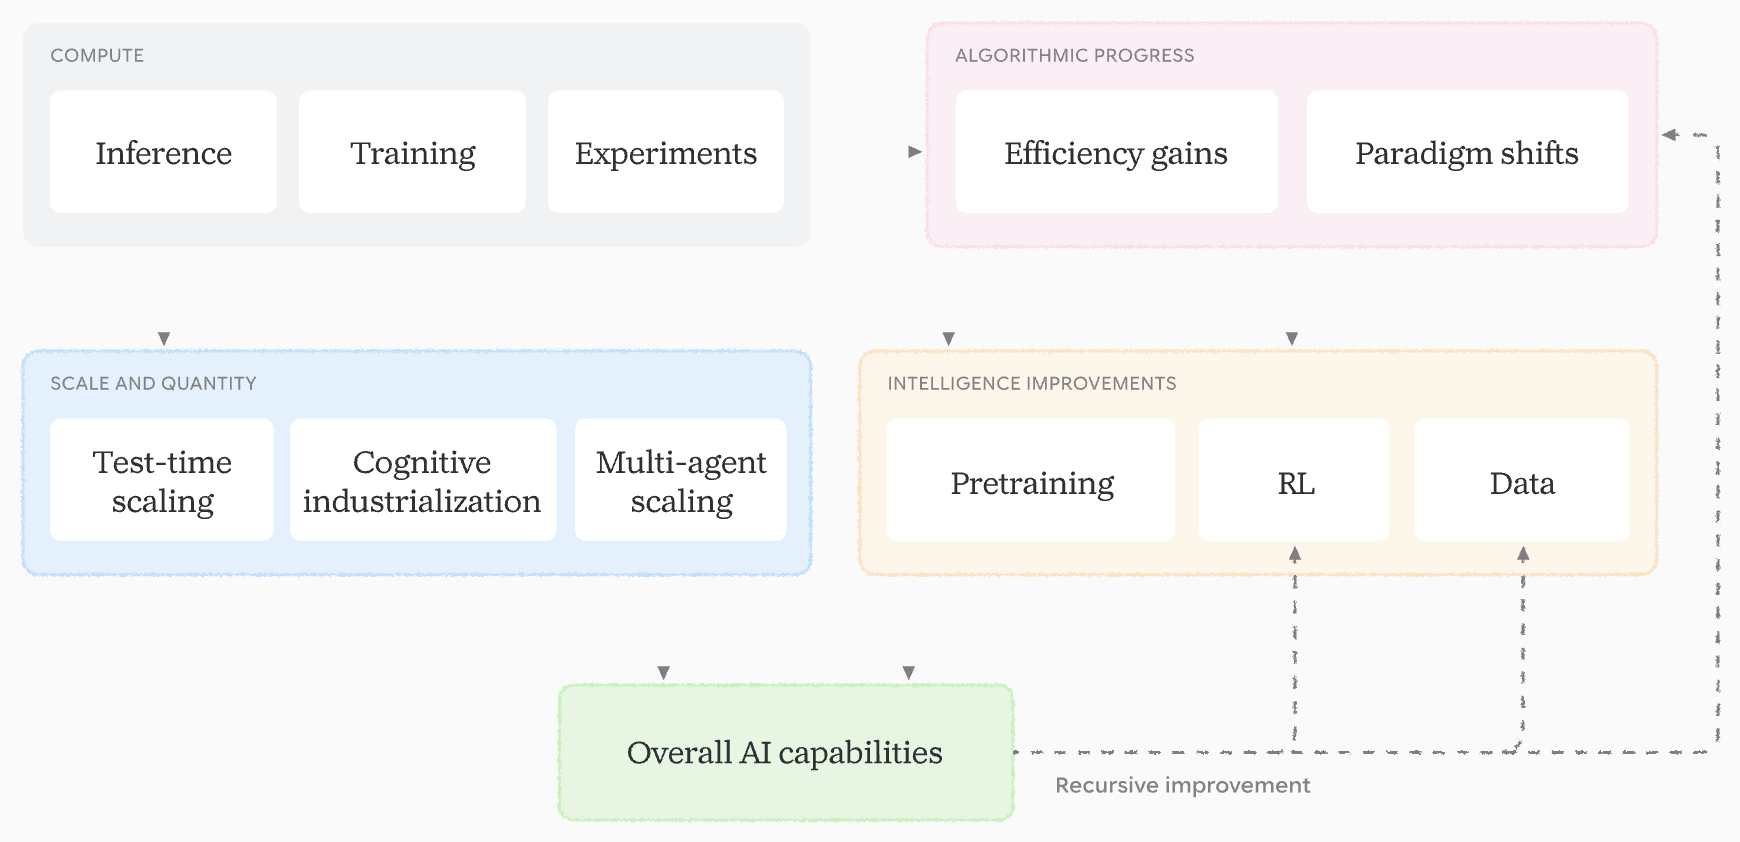
圖:從 AGI 邁向超級智能的四條核心演進路徑(Google DeepMind)
路徑一:模型與數據縮放擴展(Scaling)
第一條路徑是人類目前最為熟悉、也最為直觀的規模擴展法則(Scaling Laws)。通過繼續增加神經網絡的參數容量、注入更為海量的高質量多模態數據,並匹配相適應的訓練 FLOPs。
縮放法則的強大之處在於其驚人的可預測性與經驗有效性。隨著有效算力每年保持數倍以上的複合擴張,模型對複雜概念表徵與跨領域知識遷移的深度將持續深化。
與此同時,後訓練(Post-training)階段的推理時計算擴展(Inference-time Compute)與強化學習探索,正在開闢出模型容量之外的全新第二增長曲線。
路徑二:技術範式轉移(Paradigm Shifts)
第二條路徑關乎深層算法與底層架構的根本性範式躍遷。歷史經驗表明,單一技術範式的邊際收益終將放緩,而全新的顛覆性架構往往應運而生。
當前主流的純自迴歸 Transformer 架構在應對超長程因果規劃、不確定性下的主動假設檢驗以及環境物理交互時,依然暴露出固有的侷限性。
未來可能的範式突破包括但不限於:融入世界模型的基於搜索的深度規劃框架、神經符號混合系統,以及借鑑生物腦神經機制的全新非 Transformer 神經形態架構。
路徑三:提升智能體協同機制(Agent Coordination)
第三條路徑著眼於由多個異構智能體構成的分佈式協作體系。人類之所以能夠創造燦爛的現代文明,並非因為個體大腦比遠古智人強大數倍,而是依託了高度精密的社會分工與制度協同。
當數以萬計的專業化 AGI 智能體能夠藉助標準化的通信協議、激勵相容的協調機制以及多角色分工相互協作時,整個網絡所湧現出的集體智慧將遠遠超越任何單一模型的算力上限。
這種多智能體系統不僅能夠自組織地攻關複雜科研項目,還能夠在動態環境博弈中通過彼此制衡與交叉驗證,大幅降低單點幻覺與推理謬誤的發生率。
路徑四:遞歸自我改進(Recursive Self-Improvement)
第四條路徑則是通向超級智能最具爭議、也最為深遠的核心驅動力:遞歸自我改進(RSI)。
在傳統的科研範式中,人類研究人員構成了改進 AI 系統的主要瓶頸;而當 AGI 自身具備了閱讀最新論文、自主設計模型架構、編寫高效編譯底層並開展大規模算法實驗的能力時,智能的演進將徹底閉環。
每一次系統的迭代升級,都會創造出更為強大的下一代 AI 開發者,進而以更快的速度催生更高級的算法突破。這種自我強化的正反饋循環,正是數學家與計算機先驅所預言的智力爆炸的核心動力來源。
通向超級智能的多元演進之路
必須強調的是,這四條演進路徑絕非非此即彼的割裂關係,而是呈現出極為緊密的協同共振效應。
規模擴展為全新技術範式的萌發奠定了算力與數據基礎;而更高效的智能體協同架構,又反過來能夠大幅加速遞歸自我改進過程中的並行研發效率。
從人類智能到超級智能,既不是遙不可及的神話,也不是單一奇點的瞬間降臨,而是一場由工程探索、數學論證與產業協同共同譜寫的波瀾壯闊的技術長征。
唯有深入理解支撐這一進程的物理法則與演進路徑,人類社會才能在超級智能的黎明真正到來之際,做好從容駕馭與負責任引導的充分準備。
歡迎加入深潮 TechFlow 官方社群
Telegram 訂閱群:https://t.me/TechFlowDaily
Twitter 官方帳號:https://x.com/TechFlowPost
Twitter 英文帳號:https://x.com/BlockFlow_News
 @GoogleDeepMind














