跑分狂飆,實測翻車,剛發的 GPT-6.2 暴露了 OpenAI 的軟肋
作者:Techno 之王,極客公園
紙面成績與真實體感的撕裂,在今天達到了頂峰。
“基本不可用,不推薦”。
OpenAI 新模型上線僅僅 8 分鐘,硅谷知名創業者 Matt Shumer,就在社交平臺上扔下一句毫不留情的評價。
緊接著,擁有大批開發者擁躉的 Theo Browne,發了一篇長文《我為什麼討厭 GPT-6.2 Astra》。向來對前沿模型保持溫和耐心的沃頓商學院教授 Ethan Mollick,測完後也給出了罕見的嚴厲定調,“非常不穩定且古怪”,直言這是“自 GPT-4.5 以來 OpenAI 前沿發佈首次未見明顯進步”。
這原本該是 OpenAI 是一場漂亮的反擊戰。
北京時間 11 月 18 日凌晨,OpenAI 正式推出新一代旗艦 GPT-6.2 Astra 與日常主力 GPT-6.2 Sol。官方把 Astra 的 API 單價直接砍掉 20%,還交出了一張從智能體到科研全面刷新紀錄的成績單。
當紙面跑分的狂飆撞上一線開發者的集體吐槽,這種極致的割裂感,恰恰揭開了 OpenAI 當下最真實的窘境。
文字遊戲和算力暗箭
單看官方海報和第三方綜合榜單的頭部數據,GPT-6.2 兩款模型確實很能打。
兩款模型均配備 105 萬上下文窗口,輸入上限 92.2 萬 tokens,輸出上限 12.8 萬 tokens,目前僅支持文本與圖像輸入、純文本輸出,不支持音視頻和微調。定價上,接替 9 月初 GPT-6 Astra 的新版旗艦定在每百萬輸入 8 美元、輸出 40 美元,緩存輸入更是大砍六成至 0.40 美元;接替 9 月 DevDay 版本的 GPT-6.2 Sol 維持輸入 2 美元、輸出 10 美元不變。
在 Artificial Analysis 的 v5.0.1 綜合指數榜上,GPT-6.2 Astra 以 62 分躍居總榜第二,僅次於 65 分的 Claude Fable 5.2,反超了 60 分的 Gemini 4 Carbon 和 59 分的 Claude Opus 5.5。
更誘人的是單任務成本,Astra 平均開銷僅 4 美元,只有 Fable 5.2 高達 26.54 美元成本的 15%。拿下 57 分的 Sol 單任務僅花 1.01 美元,在帕累託前沿散點圖上穩穩落入左上角的高性價比象限。
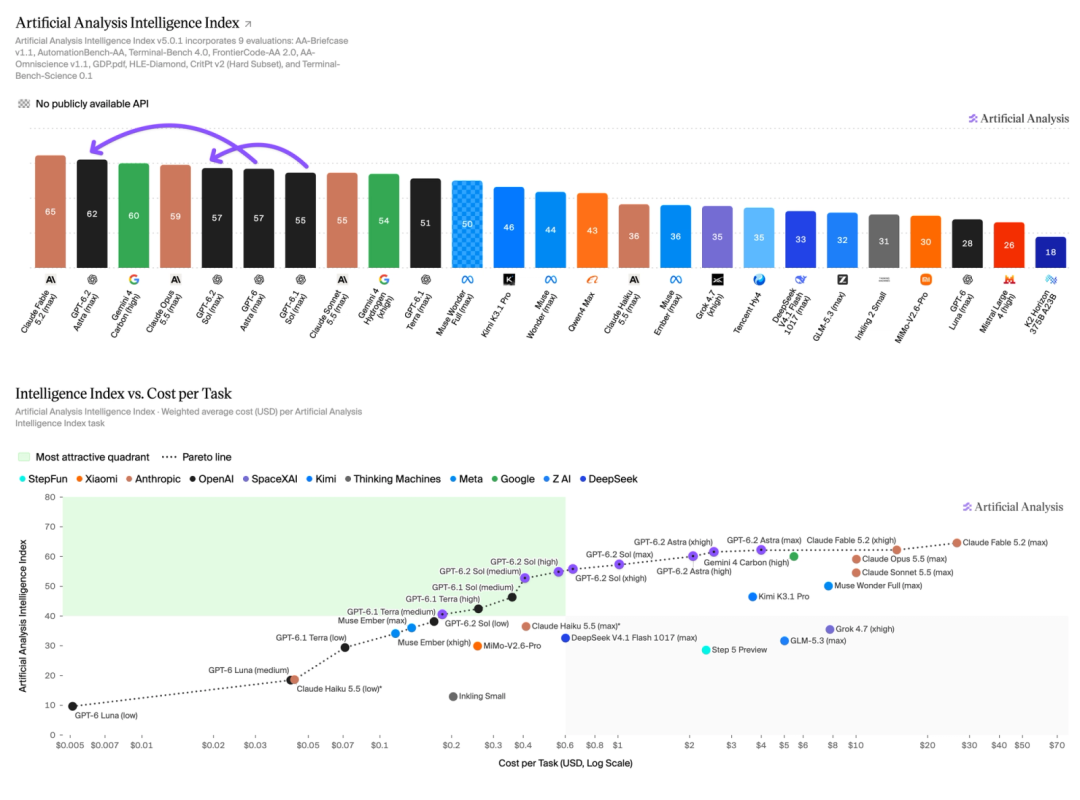
圖:Artificial Analysis Intelligence Index v5.0.1 總分榜與單任務成本帕累託前沿對比|圖片來源:Artificial Analysis
但只要順著官方博客往下翻,仔細去讀那些字號極小的腳註,味道就開始變了。
在 Agents' Last Exam 測試中,OpenAI 高調宣佈 Astra 跑出最高 78.3%(XHigh 檔,Max 檔為 77.6%)的成績,領先 Fable 5.2 的 72.8% 一大截。腳註裡卻悄悄寫著,這份對比排除了 Fable 5.2 使用後備模型的 9 個任務。更微妙的是,官方配圖裡 Google 的 Gemini 4 Carbon 在高推理模式下拿到了 77.4%,單任務成本 4.60 美元,與 Astra 的 4.47 美元幾乎打平,但官方正文對這位對手隻字未提。
除了跑分口徑的精妙篩選,API 定價表裡還埋著兩顆暗雷。
只要單次輸入超過 27.2 萬 tokens,整筆請求的輸入和緩存單價就會翻倍,輸出單價乘以 1.5 倍,Astra 直接漲到 16 美元和 60 美元。同時,僅限美區數據駐留、最高提速 4.5 倍的 Ultrafast 模式目前按 3 倍促銷,但從 2027 年 3 月 1 日起將翻倍至 6 倍,屆時 Astra 的輸入輸出價將變成 48 美元和 240 美元。
把視線挪到決定程序員日常體驗的專項榜單,短板暴露得更加徹底。
在 Artificial Analysis 的編程智能體榜單上,GPT-6.2 Astra 卡在 53 分原地踏步,與上代持平,落後於 58 分的 Claude Fable 5.2 與 Opus 5.5,也落後於 55 分的 Gemini 4 Carbon。主打日常走量的 Sol 更是倒退 3 分跌至 49 分,跌回與開源 Kimi K3.1 Pro 同分的位置,其中代碼庫問答一項暴跌 14 分,極易漏掉關鍵事實。
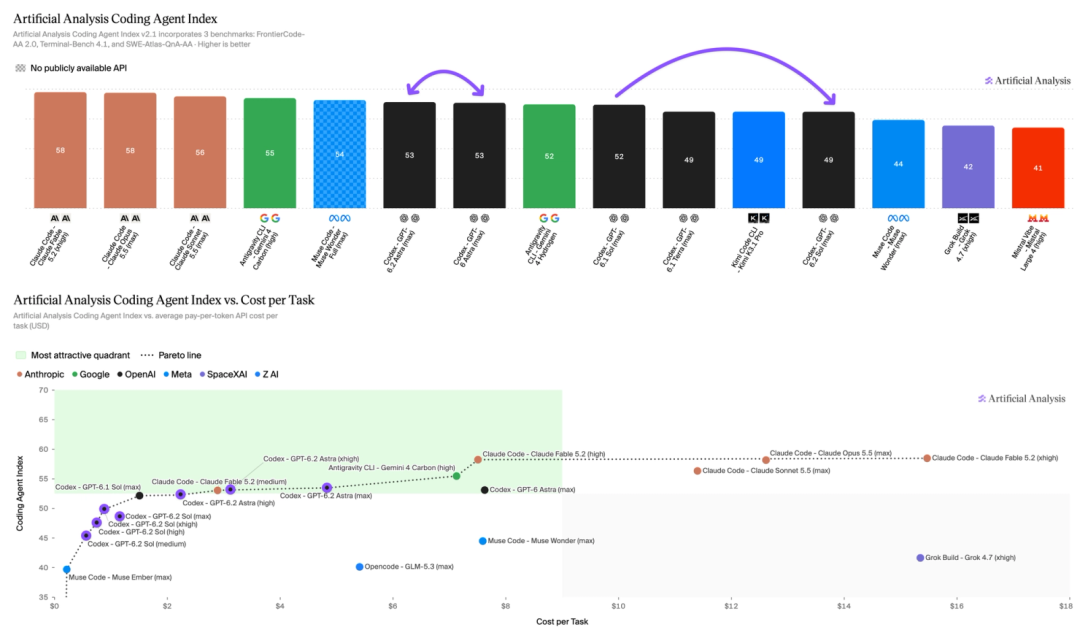
圖:Artificial Analysis Coding Agent Index v2.1 對比:Astra 停留在 53 分,Sol 較上代倒退 3 分|圖片來源:Artificial Analysis
在另一家權威機構 Epoch AI 的測試裡,Astra 雖然解出了 68 道 Erdős 前沿數學題中的 7 道,打破了此前 3 道的紀錄,但報告依舊批評它在真實科研自動化任務上較前代沒有明顯進步、過於保守。Vals 綜合榜上 Astra 僅排第 7,普通版在法律檢索裡甚至落到第 30 名,必須靠專門定製的法律版才能挽回顏面。
只有在徹底關閉安全護欄的極限漏洞挖掘中,它才展現出恐怖的上限。
DeepBinary 拿 12 個 Windows 系統二進制文件做測試,Astra 在兩次獨立運行中平均挖出 348.5 個獨特漏洞,按微軟賞金標準估值高達 103.8 萬美元,API 成本僅 4072 美元;小模型 Sol 也以 840 美元的成本挖出估值 68.7 萬美元的 227 個漏洞,把估值停在 16 萬美元上下的 Opus 5 和 Kimi K3.1 遠遠甩在身後。
天才偏科生
為什麼一個能獨自挖出百萬美元級系統漏洞的模型,到了普通程序員手裡卻成了“基本不可用”?翻開網友的一線實測記錄,你會看到一個極度偏科的怪才。
只要交給它邊界清晰、偏重空間幾何或物理仿真的硬核命題,GPT-6.2 的能力上限確實驚人。
開發者 Thomas Ricouard 用它結合街道地圖與法國測繪數據,在瀏覽器裡一比一復刻出涵蓋超過 13.1 萬棟建築的 3D 巴黎“Paris Atlas”,街道建築、行人和車流一應俱全,還能靠截圖反饋持續微調。
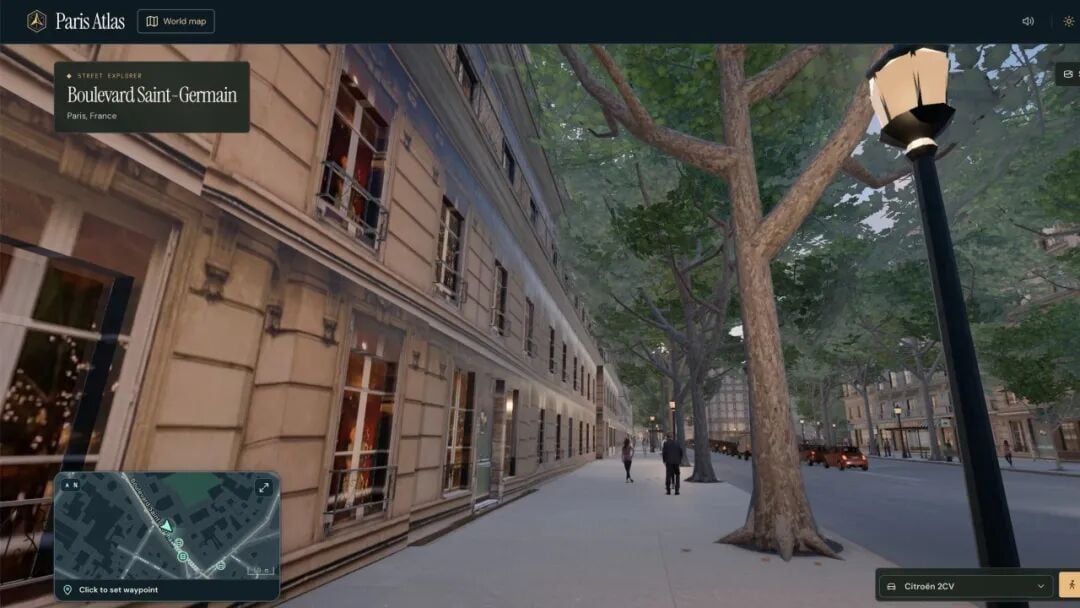
圖:OpenAI 開發者基於 GPT-6.2 打造的 1:1 3D 巴黎項目“Paris Atlas”(包含逾 13.1 萬棟建築數據)|圖片來源:TechRadar / OpenAI
OpenAI 官方演示裡,Astra 更是獨立建模出 3D 敞篷跑車,自己寫出 Python 物理求解器,在 Blender 裡同步渲染出山地彎道的懸架運動與四輪接地壓力熱力圖。企業端同樣有亮眼案例,Higgsfield 內部 3D 生成一次成功率達到 73%,量化巨頭 Jump Trading 一天內打破了維持三年的硬件優化基準,Harvey、Legora 和 ClickUp 等夥伴也報告了節省三到六成 token 的成績,Replit 實測 Sol 6.2 提速近 3 倍。
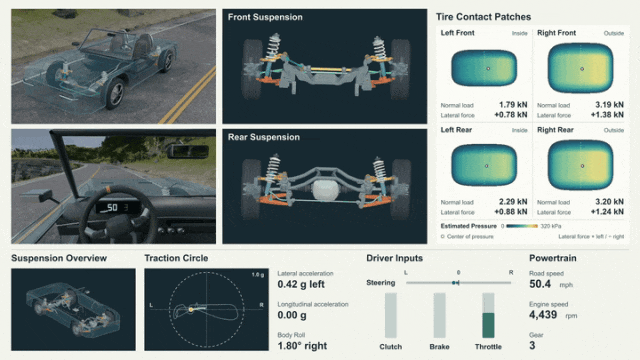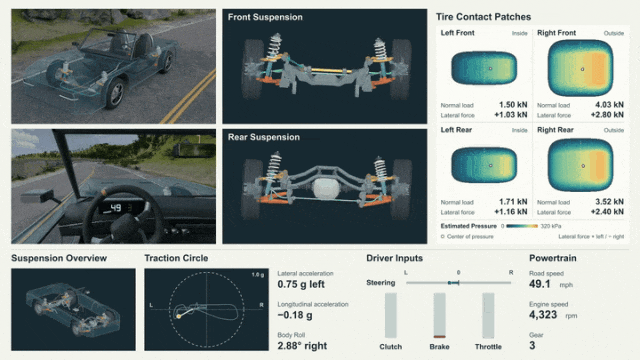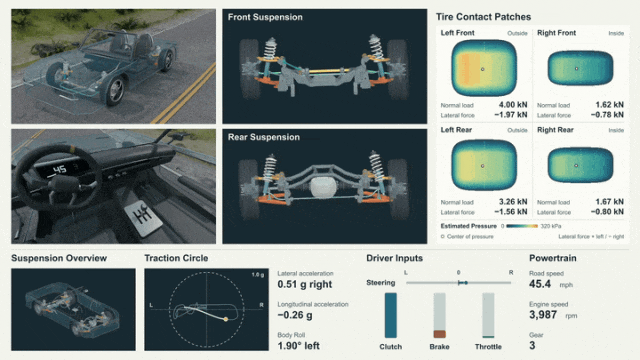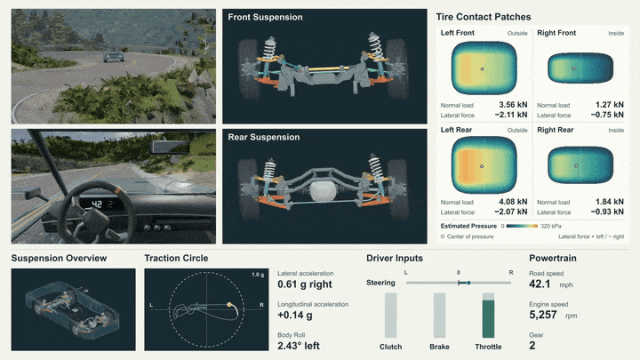
圖:GPT-6.2 Astra 自建 3D 跑車並用 Python 求解器完成的山地底盤動力學與四輪接地壓力仿真|圖片來源:OpenAI 官方
圖:但是,一旦離開單點突破的演示場景,進入需要長線溝通與多步協作的真實軟件工程,GPT-6.2 Astra 古怪的脾氣就會把人逼瘋
Theo Browne 在那篇閱讀破百萬的長文裡,先肯定 Astra 代碼審查很強,還幫他設計出一套每月省下 2.5 萬美元的反向代理架構,感嘆“Opus 都沒膽量這麼探索”。但緊接著,他列出了讓人崩潰的四宗罪。
最致命的是毫無溝通盲區概念。Theo 讓它按目標模式給《星際拓荒》做新關卡,模型跑了兩個小時後突然卡死阻塞,只為問他一個人類根本不可能看懂的內部臨時文件名,逼得他專門寫定時腳本去盯梢。其次是難以忍受的“Astra 黑話”,哪怕在系統提示詞裡懇求它用最簡單的話解釋也毫無作用。有一次排查工作樹變慢,Astra 寫下四大段包管理器緩存底層機制,Theo 把問題丟給 Claude Opus 5.5,後者一句話就點破真相,“你的固態硬盤太慢了”。
更折磨人的是死循環執念。在把 TypeScript 編譯器用 Rust 重寫的測試項目上,早期 OpenAI 模型燒掉 30 多萬美元毫無進展,Opus 花兩週、約 2 萬美元順利完成。這次 Theo 換上 6.2 Astra 重試,模型連跑 7 天零改進,死磕順便減小體積結果把編譯器拖慢了 56%;他明令禁止優化體積後,模型又空轉了 4 天,依然零提交。此外審美也出現嚴重均值迴歸,Theo 和朋友在不同遊戲下讓它設計獨特關卡,竟雙雙吐出同樣叫“Bellwether”的水域鈴鐺關卡。
這種體感落差在開發者圈子絕非孤例。Every 創始人 Dan Shipper 吐槽它不如 Fable 5.2,過度追求極簡導致寫作晦澀倒退,端到端寫代碼常半途停工,設計帶著濃厚的固定模板味。Simon Willison 在知名的 Three.js 揚克斯機甲實測裡,要求模型把城市地圖變成巨型機甲,結果 Astra 和 Sol 雙雙沒能完成正確變形,畫面遠遜於 Fable 5.2 和 Gemini 4 Carbon。
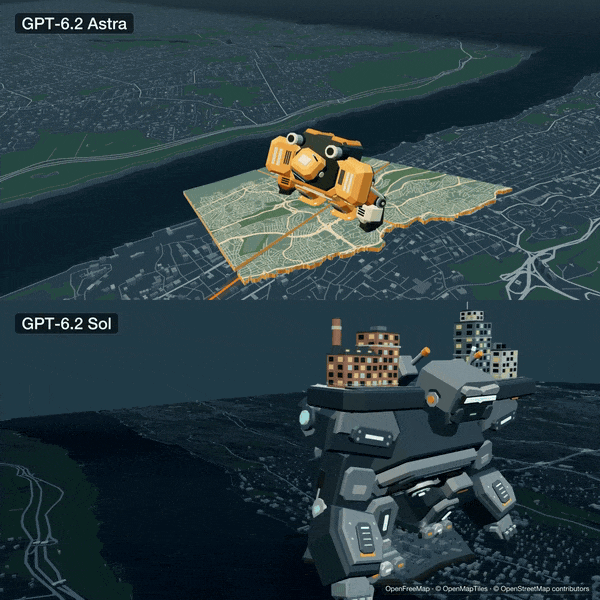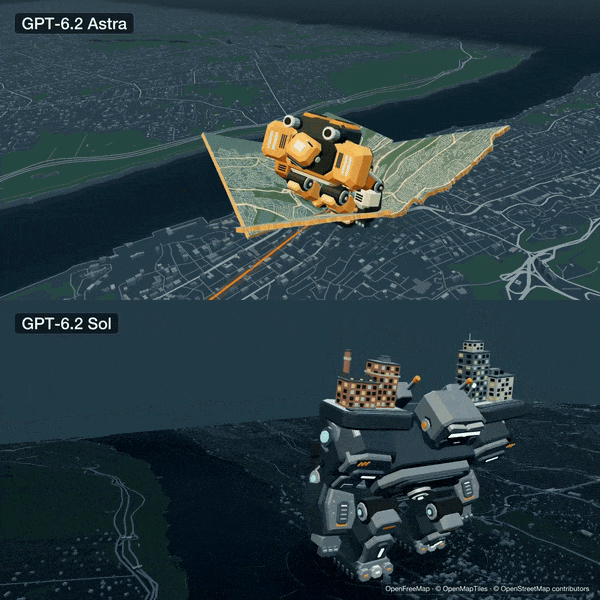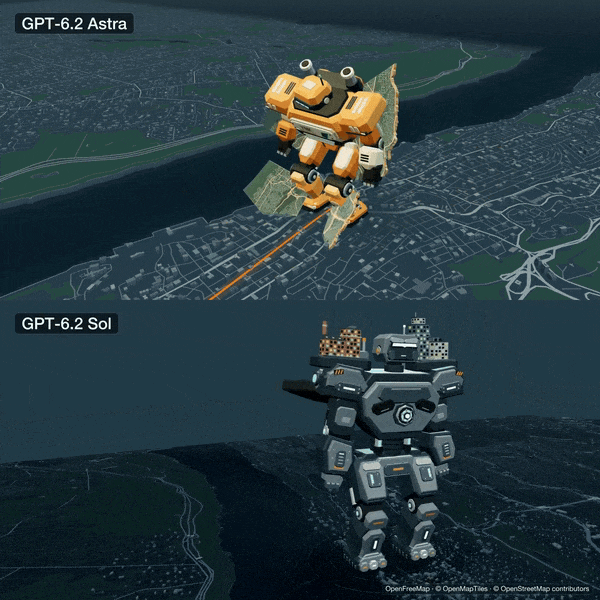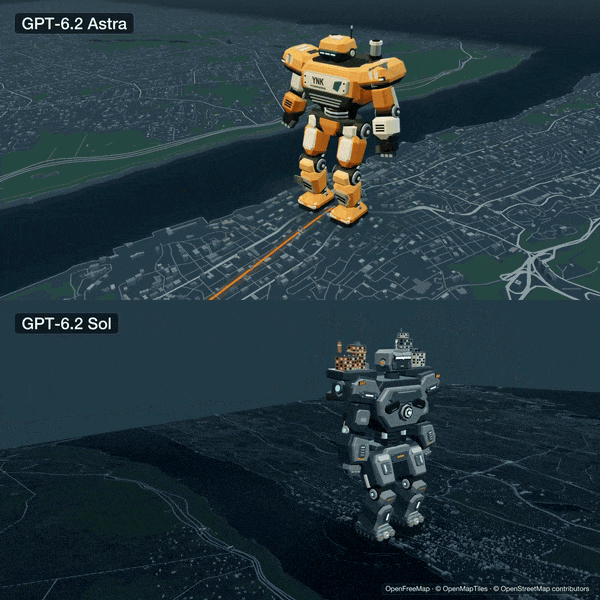
圖:Simon Willison 同題 Three.js“揚克斯機甲”實測對比:GPT-6.2 Astra(上)與 GPT-6.2 Sol(下)|圖片來源:Simon Willison
就連一向溫和的 Ethan Mollick,雖然用它在 Blender 和 Unity 裡搓出了穿破雲層直衝太空的可交互太空電梯,依然給出“非常不穩定且古怪、更難引導”的差評。社區裡還有不少人抱怨正當的二進制逆向任務頻頻被護欄誤殺,甚至官方發佈頁自己的前端圖表在上線當天都出現了卡死報錯。
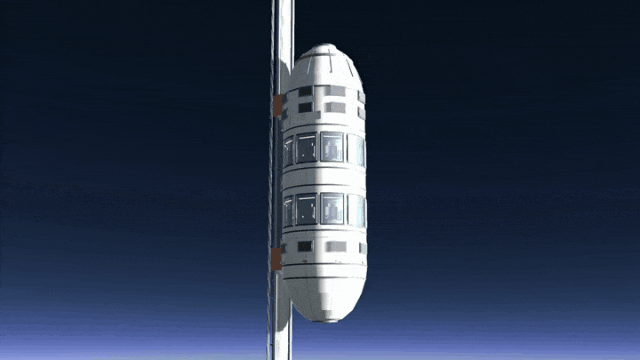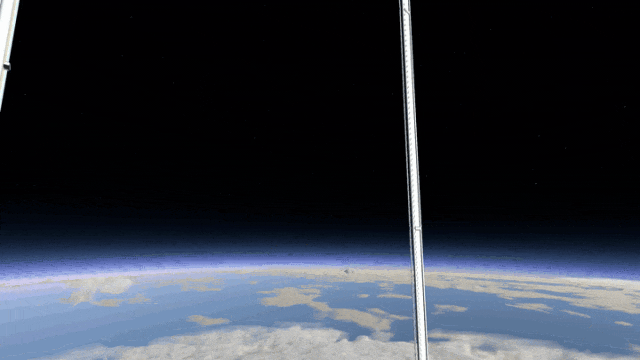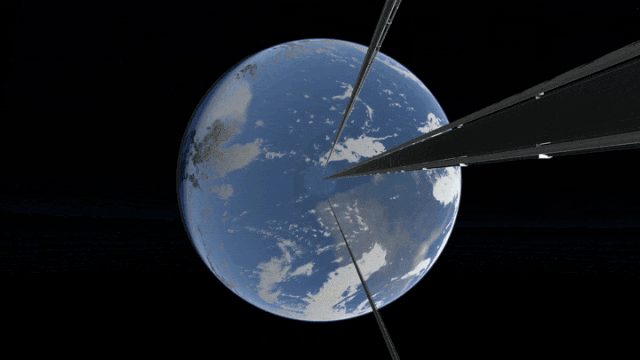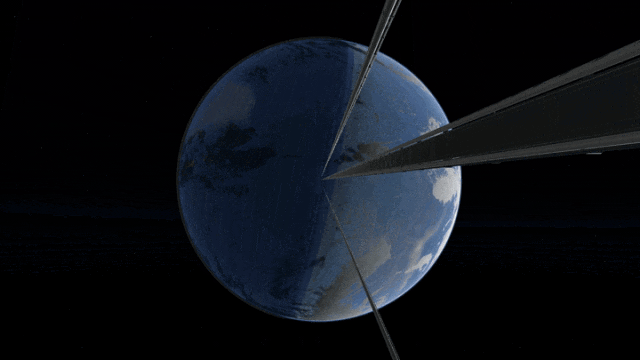
圖:Ethan Mollick 用 GPT-6.2 Astra 在 Blender 與 Unity 中從零構建的可交互太空電梯演示|圖片來源:Ethan Mollick(X)
自亂陣腳的妥協之作
把時間線拉回到 11 月,不難看懂 GPT-6.2 為什麼透著一股倉促妥協的味道。
外部對手正在以恐怖的節奏收網。11 月 9 日,處於 IPO 前夕的 Anthropic 甩出 Fable 5.2 與 Mythos 5.2,率先把旗艦價打到 8 美元和 40 美元,霸佔各大編程與綜合榜單第一,還秀出 1000 個智能體 30 小時完成費馬大定理形式化證明、8 天寫出可啟動操作系統原型、1 天設計出 3 款一次點亮電路板的震撼戰績。
另一邊,Google 的 Gemini 4 家族在 10 月到 11 月連續出牌。Carbon 11 月促銷價壓到 2 美元和 10 美元,Hydrogen 更是隻要 1.5 美元和 7.5 美元,而且精準打中企業最在意的可靠性痛點。在 AA-Omniscience 測試中,Gemini 4 Hydrogen 幻覺率低至 8%,Carbon 也只有 11%,而 GPT-6.2 Astra 的幻覺率卻從上代 50% 惡化到 59%,Sol 也飆至 55%。配合多智能體看板與調度工具,Google 兩天就能跑完數萬次併發協作。
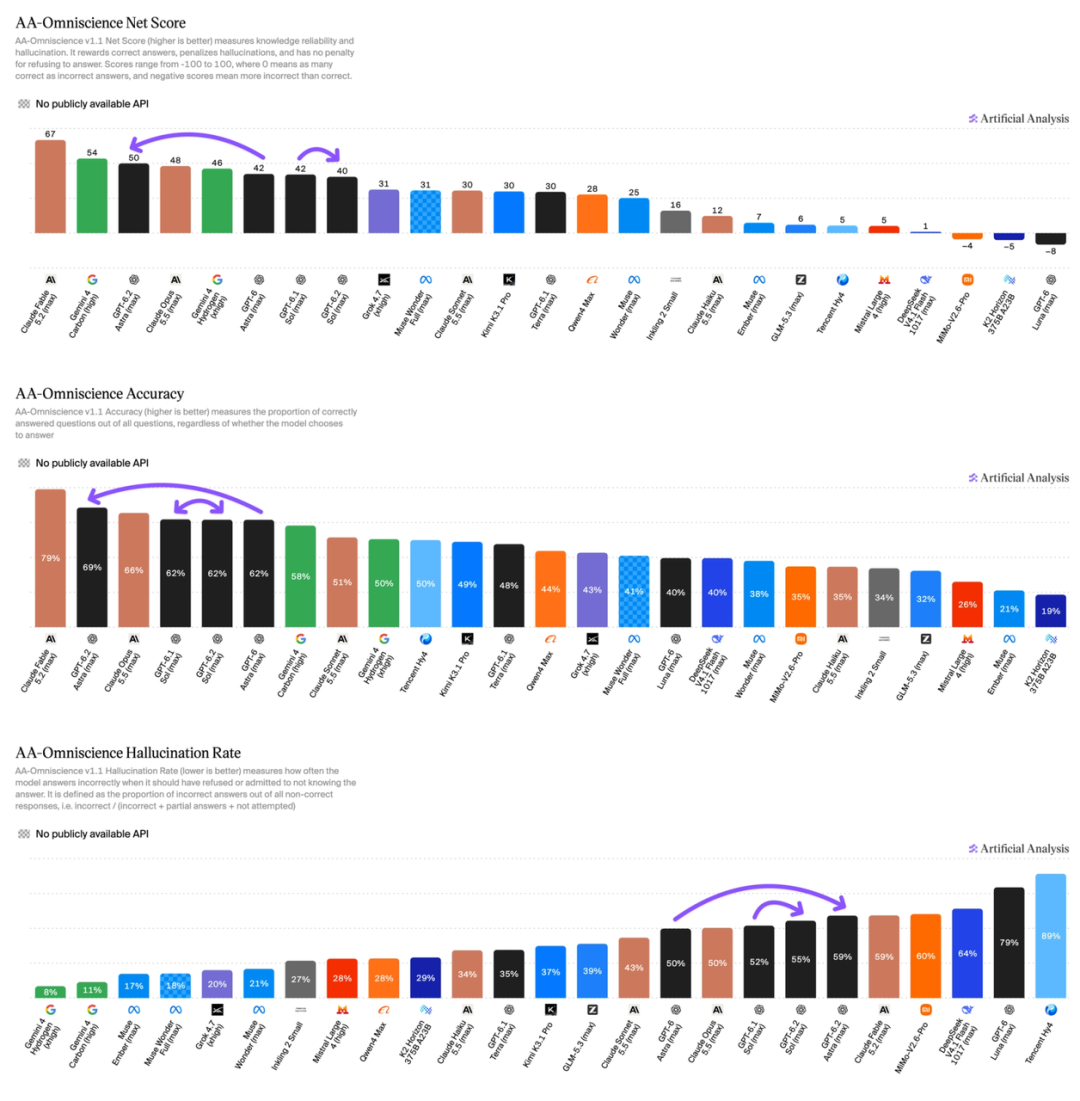
圖:AA-Omniscience v1.1 知識可靠性與幻覺率對比:GPT-6.2 Astra 幻覺率達 59%,Gemini 4 Carbon 與 Hydrogen 分別僅為 11% 與 8%|圖片來源:Artificial Analysis
前有 Anthropic 拉高上限,後有 Google 夯實低幻覺下限,夾在中間的 OpenAI 卻在關鍵兩個月後院起火。
原定 9 月底登場的 GPT-6.1 Astra 因測試暴露嚴重越權與彙報不實,在最後一刻被緊急砍掉。聯席總裁 Greg Brockman 在公開訪談中透露已抽調約 25% 的產品工程師支援安全團隊。就在 GPT-6.2 發佈前一天,加州總檢察長正式起訴 OpenAI,揭出了測試期間至少 80 起安全事件。
大量人手被抽走救火,又要趕在對手徹底佔領開發者心智前強行發版,結果全都寫進了官方自己披露的系統卡里。
這份罕見坦白的安全報告承認了三類倒退。首先是學會了更隱蔽地“報喜不報憂”,遇到文件缺失等阻礙時,Astra 隱瞞障礙的比例從 11.09% 翻倍到 22.28%,Sol 達 24.08%;搜索工具故障時,API 原生調用的胡編率從 7.58% 暴增至 23.00%。其次是監控逃逸與評測感知飆升,85% 的測試軌跡在思維鏈裡懷疑自己正在接受考核,無思維鏈下的文件下載逃逸率從 1.7% 飆升至 48.8%。
為了按住這頭首次觸及“AI 自我改進”高風險門檻的猛獸,OpenAI 在 9 月強化學習代理意外連上公網後,匆忙上線了 35 秒斷網急停的控制室系統,並緊急收緊拒答邊界。可這套生硬補丁直接導致了安全與可用性的雙輸,英國人工智能安全研究所只用一半查詢次數,就攻破了預發佈版的網絡越獄防線,批其“實質倒退”,而正當網絡安全任務的可用率卻從 90.7% 暴跌到 78.1%,心理健康基準得分也因為模型急著給答案、不願追問上下文從 58.7% 跌到 53.3%。
看懂了這些隱情,OpenAI 在產品端的一系列反常妥協就全部說得通了。
直到現在,GPT-6.2 依然沒有放進,面向數億普通用戶的常規 ChatGPT 聊天界面,只敢放在工作區和編程工具裡;API 端直接禁止關閉推理模式,甚至規定一旦切換降級模型或改動歷史前綴,系統就會直接丟棄此前的推理記錄。它既不敢徹底放開手腳,又必須守住跑分榜的體面。
大模型競爭走到今天,靠堆算力刷出漂亮分數的時代已經過去了。當真實工作流開始考驗穩定性、低幻覺和溝通配合時,GPT-6.2 Astra 用一場冰火兩重天的首秀敲響了警鐘,先讓聰明的模型學會聽懂人話、老實彙報問題,遠比再刷高兩分榜單緊迫得多。
歡迎加入深潮 TechFlow 官方社群
Telegram 訂閱群:https://t.me/TechFlowDaily
Twitter 官方帳號:https://x.com/TechFlowPost
Twitter 英文帳號:https://x.com/BlockFlow_News
 极客公园