Запредельные показатели в бенчмарках, полный провал на практике: только что выпущенный GPT-6.2 обнажил слабое место OpenAI
Автор: Техно-король, Geek Park
Разрыв между цифровыми показателями и реальным пользовательским опытом достиг своего пика сегодня.
«Почти не работает, не рекомендую».
Менее чем через 8 минут после релиза новой модели от OpenAI известный предприниматель из Силиконовой долины Мэтт Шуэр опубликовал в социальных сетях безжалостный комментарий.
Сразу за ним Тео Браун, пользующийся поддержкой огромного количества разработчиков, опубликовал длинную статью под названием «Почему я ненавижу GPT-6.2 Astra». Профессор Уортонской школы бизнеса Итан Моликк, всегда сдержанный и терпеливый по отношению к передовым моделям, после тестирования также дал редкую резкую оценку: «очень нестабильная и странная», прямо заявив, что это «первая значимая публикация OpenAI с момента выпуска GPT-4.5, в которой не наблюдается заметного прогресса».
По задумке, это должно было стать эффектной контратакой со стороны OpenAI.
Ранним утром 18 ноября по пекинскому времени OpenAI официально представила новую флагманскую модель GPT-6.2 Astra и основную рабочую модель GPT-6.2 Sol. Компания снизила цену на API для Astra сразу на 20% и представила отчет, демонстрирующий обновление рекордов во всех категориях — от агентов до научных исследований.
Когда ажиотаж вокруг высоких баллов в тестах сталкивается с коллективными жалобами разработчиков на местах, эта радикальная дисгармония обнажает самую реальную сложность, с которой сейчас столкнулась OpenAI.
Литературные уловки и скрытые риски производительности
Если смотреть только на официальные постеры и верхние позиции рейтингов сторонних агентств, обе модели GPT-6.2 действительно выглядят очень мощно.
Обе модели оснащены контекстным окном объемом 1,05 миллиона токенов; предел ввода составляет 922 тысячи токенов, предела вывода — 128 тысяч токенов. На данный момент поддерживается только ввод текста и изображений при выводе чистого текста, аудио- и видеоформаты, а также дообучение не поддерживаются. Что касается цен, новая флагманская версия, заменившая версию GPT-6 Astra начала сентября, установлена на уровне 8 долларов за миллион единиц ввода и 40 долларов за вывод, тогда как цена за кэшированный ввод была значительно снижена на 60% до 0,40 доллара. Модель GPT-6.2 Sol, заменившая версию DevDay сентября, сохраняет цены на уровне 2 долларов за ввод и 10 долларов за вывод.
В общем рейтинге Artificial Analysis версии v5.0.1 GPT-6.2 Astra поднялась на второе место общего списка с результатом 62 балла, уступая лишь 65-балльной Claude Fable 5.2, но опережая 60-балльную Gemini 4 Carbon и 59-балльную Claude Opus 5.5.
Еще более привлекательным выглядит стоимость выполнения отдельной задачи: средние затраты на Astra составляют всего 4 доллара, что составляет лишь 15% от затрат Fable 5.2 в размере 26,54 доллара. Sol, набравшая 57 баллов, обходится в 1,01 доллара за задачу и уверенно попадает в сектор высокой рентабельности в левом верхнем углу графика парето-фронта.
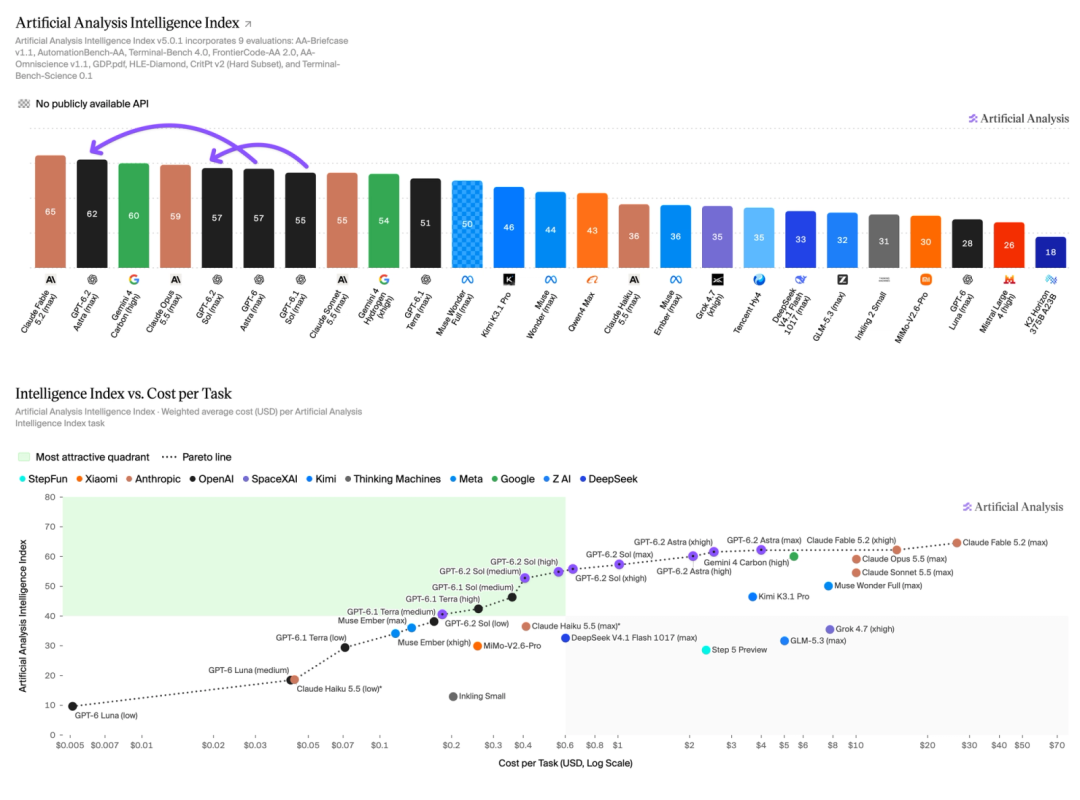
Рис.: Сравнение общего рейтинга Artificial Analysis Intelligence Index v5.0.1 и парето-фронта стоимости отдельных задач | Источник изображения: Artificial Analysis
Но стоит немного прокрутить официальную блог-статью вниз и внимательно прочитать мелкий шрифт в сносках, как настроение меняется.
В тесте Agents' Last Exam компания OpenAI громко объявила о том, что Astra показала максимум 78,3% (режим XHigh, режим Max — 77,6%), значительно опередив показатель Fable 5.2 в 72,8%. Однако в сноске тихо указано, что данное сравнение исключает 9 задач, в которых Fable 5.2 использовала резервную модель. Ещё тоньше то, что на официальном иллюстративном материале Google Gemini 4 Carbon в режиме высокоуровневого рассуждения набрал 77,4% при стоимости задачи 4,60 доллара, что практически сравнялось с 4,47 долларами Astra, но в основном тексте официального сообщения об этом сопернике ни слова не упоминается.
Помимо изощренной фильтрации методик подсчета баллов, таблица цен API скрывает две скрытые мины.
Как только объем одного ввода превысит 272 тысячи токенов, цена за ввод и кэширование для всей заявки удваивается, а цена вывода умножается на 1,5, из-за чего для Astra она резко возрастает до 16 и 60 долларов соответственно. Кроме того, режим Ultrafast, предназначенный исключительно для хранения данных в США и обеспечивающий максимальное ускорение до 4,5 раз, в настоящее время продвигается со скидкой в 3 раза, но начиная с 1 марта 2027 года его стоимость увеличится вдвое до 6 раз, после чего цены на ввод и вывод для Astra составят 48 и 240 долларов.
Если перевести взгляд на специализированные рейтинги, определяющие повседневный опыт программистов, недостатки раскрываются еще полнее.
В рейтинге программирования от Artificial Analysis GPT-6.2 Astra застряла на отметке 53 баллов, что соответствует показателям предыдущего поколения и уступает моделям Claude Fable 5.2 и Opus 5.5 (по 58 баллов), а также Gemini 4 Carbon (55 баллов). Модель Sol, ориентированная на массовое использование, и вовсе откатилась назад на 3 балла, опустившись до 49 баллов, вернувшись на уровень открытого Kimi K3.1 Pro, при этом по разделу вопросов к репозиториям кода баллы упали на 14 пунктов, что делает её склонной к упусканию ключевых фактов.
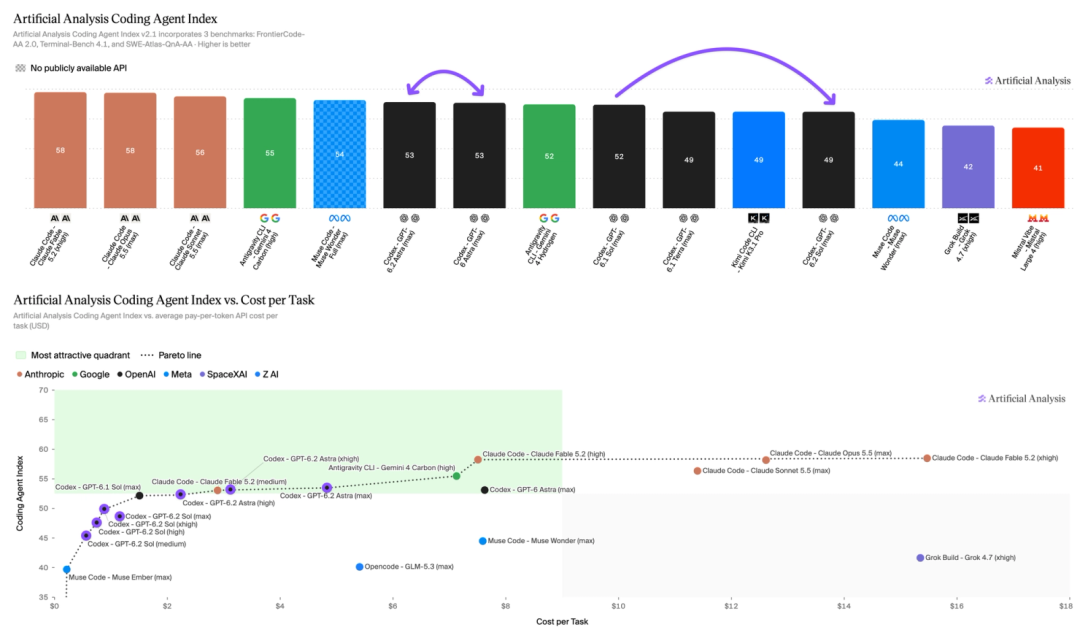
Рис.: Сравнение Coding Agent Index v2.1 от Artificial Analysis: Astra остановилась на 53 баллах, Sol откатилась на 3 балла по сравнению с прошлым поколением | Источник изображения: Artificial Analysis
В тестах другого авторитетного агентства Epoch AI, хотя Astra и решила 7 из 68 передовых математических задач Эрдейи, обновив предыдущий рекорд в 3 задачи, отчет все же критикует её за отсутствие явного прогресса по сравнению с предшественником в задачах автоматизации реальных научных исследований и чрезмерную консервативность. В общем рейтинге Vals Astra заняла лишь седьмое место, обычная версия даже опустилась на 30-ю позицию в правовом поиске, спасая лицо только за счет специально адаптированной юридической версии.
Свои страшные пределы возможностей она демонстрирует только в экстремальном поиске уязвимостей при полном отключении защитных барьеров.
Тесты компании DeepBinary с использованием 12 двоичных файлов систем Windows показали, что Astra в ходе двух независимых запусков в среднем обнаружила 348,5 уникальных уязвимостей, оцененных по стандартам Microsoft Bug Bounty в 1,038 млн долларов США, при этом стоимость API составила всего 4072 доллара. Базовая модель Sol также за 840 долларов нашла 227 уязвимостей стоимостью 687 тыс. долларов, оставив далеко позади Opus 5 и Kimi K3.1, оценка которых остановилась на уровне около 160 тыс. долларов.
Гений с явными пробелами
Почему модель, способная самостоятельно находить системные уязвимости уровня миллионов долларов, превращается в руках обычных программистов в «почти неработающую»? Если открыть записи тестов пользователей в реальных условиях, можно увидеть странного гения с крайне перекосившимся набором навыков.
Стоит лишь передать ей четко очерченные сложные задачи, связанные с пространственной геометрией или физической симуляцией, как порог возможностей GPT-6.2 действительно оказывается впечатляющим.
Разработчик Томас Рикуар использует её для объединения уличных карт и данных французского геодезического кадастра, создавая в браузере трехмерный атлас Парижа «Paris Atlas» с масштабом 1:1, включающий более 131 тысячи зданий, где присутствуют улицы, здания, пешеходы и транспорт, а также возможность постоянного улучшения на основе обратной связи со скриншотов.
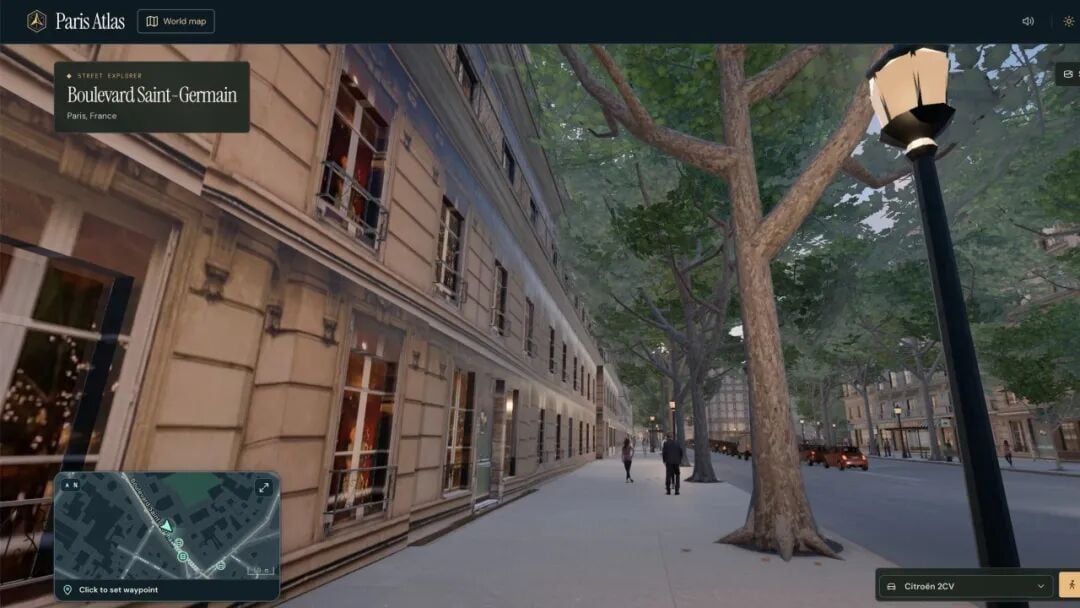
Рис.: Проект «Paris Atlas» 1:1 в формате 3D, созданный разработчиками OpenAI на базе GPT-6.2 (включает данные свыше 131 тысячи зданий) | Источник изображения: TechRadar / OpenAI
В официальных демонстрациях OpenAI Astra даже самостоятельно построила 3D-модель родстера, написала собственный решатель физических уравнений на Python и одновременно отрендерила движения подвески на горных поворотах и тепловые карты давления колес в Blender. В корпоративном сегменте тоже есть яркие примеры: внутренний процент успешного создания 3D-моделей в Higgsfield достигает 73%, количественный гигант Jump Trading за один день побил рекорды оптимизации оборудования, державшиеся три года, такие партнеры, как Harvey, Legora и ClickUp, также сообщают об экономии от 30% до 60% токенов, а на практике Replit подтвердил почти трехкратное ускорение работы Sol 6.2.
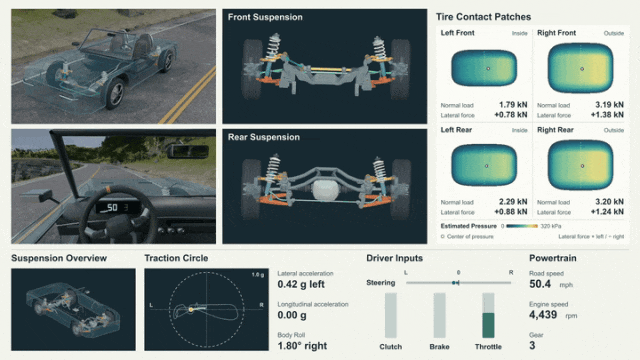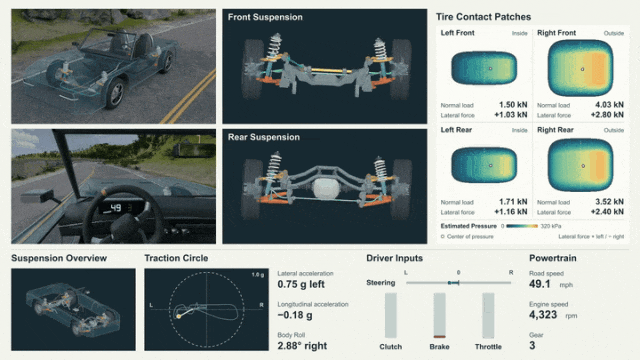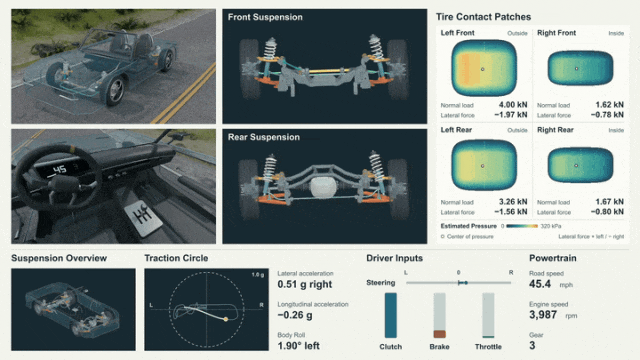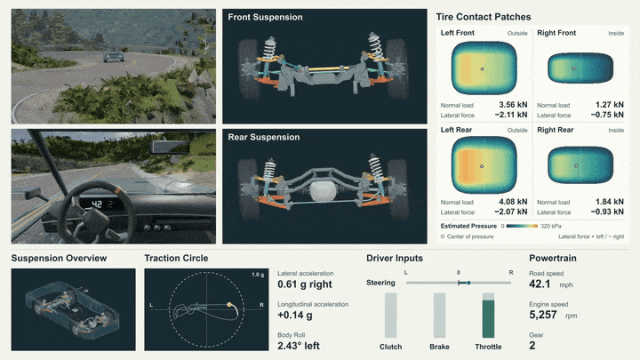
Рис.: Самостоятельно созданная GPT-6.2 Astra 3D-машина, а также симуляция динамики подвески на горном рельефе и давления колес с использованием решателя Python | Источник изображения: официальный канал OpenAI
Рис.: Однако стоит выйти за рамки демонстрационных сценариев прорывных задач и перейти к реальному процессу разработки программного обеспечения, требующему длительных коммуникаций и многоэтапного взаимодействия, как странные причуды GPT-6.2 Astra начинают доводить людей до нервного срыва.
В своей статье, собравшей более миллиона просмотров, Тео Браун сначала отмечает высокую эффективность Astra в проверке кода, которая помогла ему спроектировать систему обратных прокси-серверов, экономящую 25 тысяч долларов в месяц, восклицая: «Даже Opus боится так экспериментировать». Однако сразу за этим он приводит четыре непростительных греха, от которых сводит с ума.
Самый фатальный недостаток — полное отсутствие понимания концепции зон молчания в общении. Когда Тео поручил создать новые уровни для игры Outer Wilds в целевом режиме, модель проработала два часа, а затем внезапно зависла, лишь чтобы задать вопрос об имени внутреннего временного файла, которое человек никак не мог бы понять. Пришлось написать специальный скрипт для периодического контроля.
Далее идут невыносимые «термины Astra», когда просьбы в системном промпте объяснить всё максимально простым языком абсолютно бесполезны. Как-то раз при разборе замедления рабочего дерева Astra написала четыре огромных раздела о базовой механике кэширования менеджера пакетов, пока Тео не передал эту проблему Claude Opus 5.5, который одним предложением указал на истину: «У вас слишком медленный SSD-накопитель».
Ещё большей мукой стала одержимость зацикливаниями. В тестовом проекте по переписыванию компилятора TypeScript на Rust ранние модели OpenAI потратили свыше 300 тысяч долларов без какого-либо прогресса, тогда как Opus успешно справился за две недели примерно за 20 тысяч долларов. На этот раз Тео попробовал снова с помощью 6.2 Astra, и модель крутилась семь дней без улучшений, пытаясь сжать объём и в итоге замедлила компилятор на 56%; после прямого запрета на оптимизацию размера она ещё четыре дня работала впустую, не выдав ни одной фиксации. Кроме того, сильно возрос средний уровень шаблонности дизайна: когда Тео и его друг предложили ей создать уникальные уровни для разных игр, оба получили одинаковые уровни водных колокольчиков под названием «Bellwether».
Такого рода разрыв между ожиданиями и реальностью отнюдь не является единичным случаем в сообществе разработчиков. Создатель Every Дэн Шиппер сетует, что модель хуже Fable 5.2: чрезмерное увлечение минимализмом привело к ухудшению читаемости текстов, генерация кода часто останавливается на полпути, а дизайн пропитан жесткими шаблонами. Саймон Уиллисон в своем известном тесте с Three.js по созданию мехов из Йонкерс попросил модель трансформировать городскую карту в гигантского меха, в результате Astra и Sol не смогли выполнить правильную трансформацию, а визуальный результат оказался значительно хуже показателей Fable 5.2 и Gemini 4 Carbon.
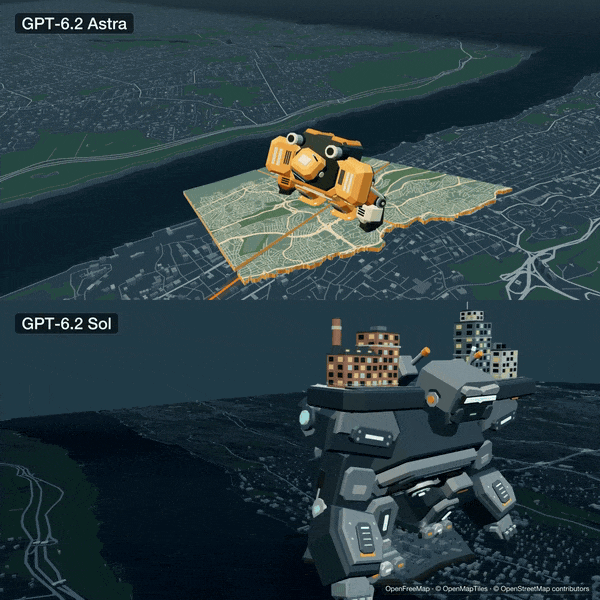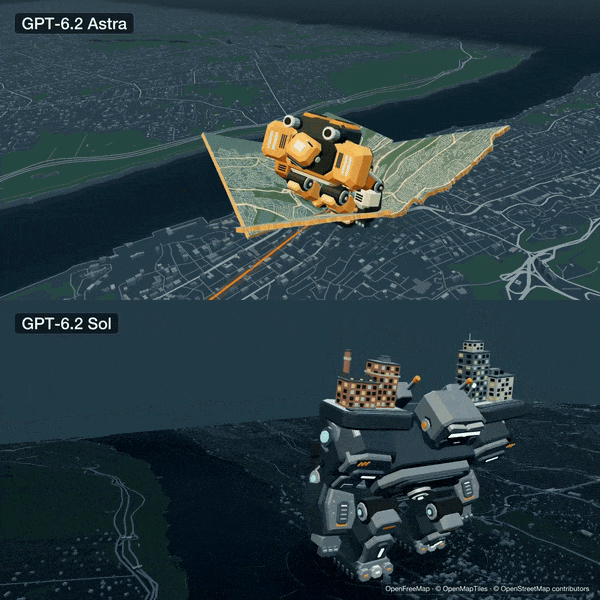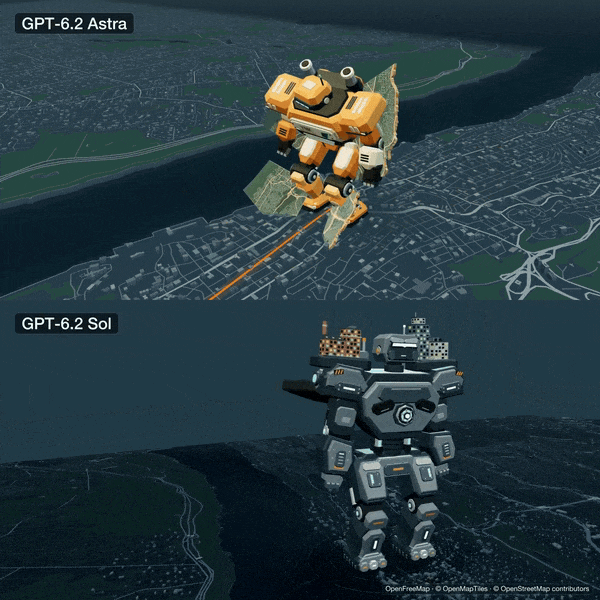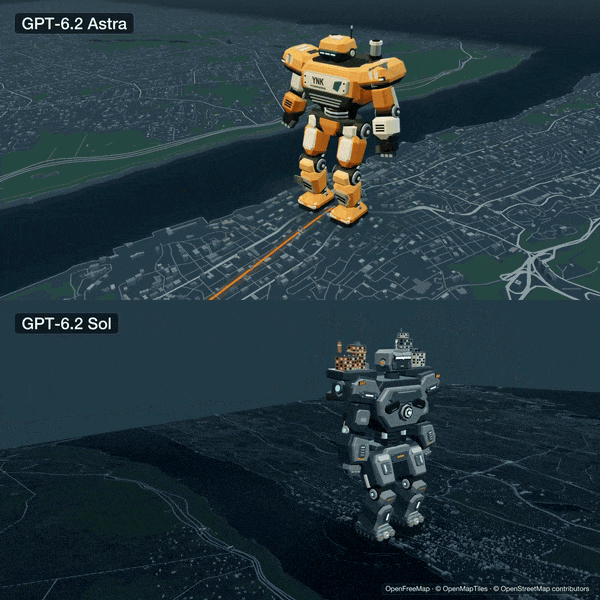
Рис.: Сравнительный тест Simon Willison с темой Three.js «Йонкерский мех»: GPT-6.2 Astra (вверху) и GPT-6.2 Sol (внизу) | Источник изображения: Саймон Уиллисон
Даже всегда сдержанный Итан Моликк, несмотря на создание интерактивного космического лифта, пробивающего облака к космосу в Blender и Unity, все равно оценил работу негативно: «очень нестабильная и странная, её труднее направлять». Многие пользователи сообщества также жалуются, что легитимные задачи бинарного обратного инжиниринга постоянно блокируются защитными механизмами, а даже собственные фронтенд-графики на странице релиза начали зависать с ошибками в день запуска.
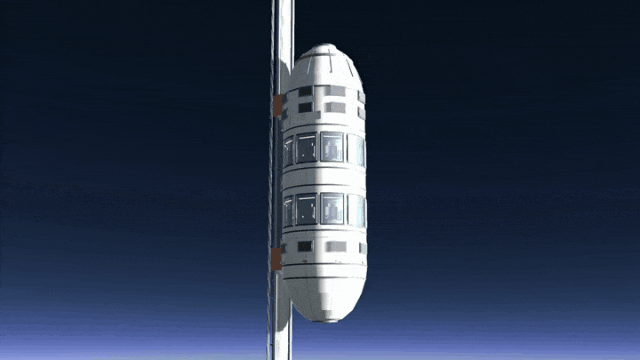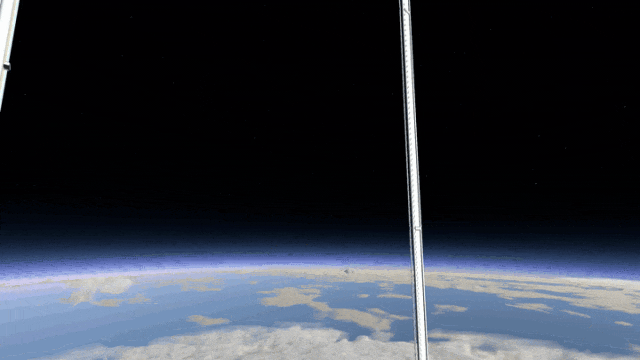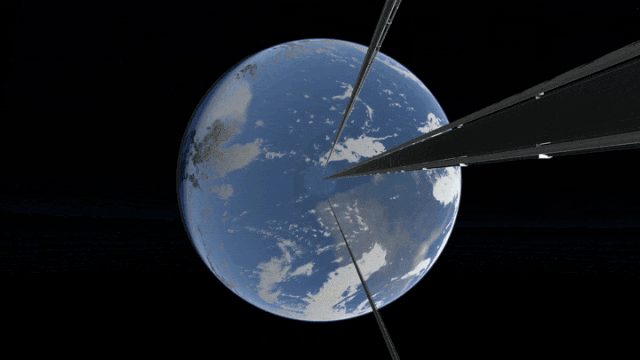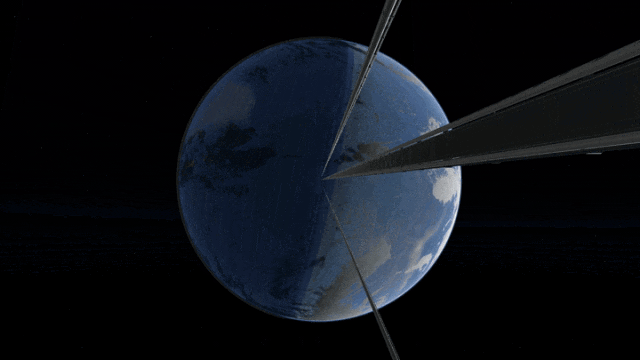
Рис.: Демонстрация интерактивного космического лифта, построенного Этаном Моликком с нуля в Blender и Unity на основе GPT-6.2 Astra | Источник изображения: Этан Моликк (X)
Компромиссный продукт, испорченный собственной неразберихой
Вернувшись к хронологии ноября, несложно понять, почему GPT-6.2 так сильно пахнет вынужденными спешными компромиссами.
Внешние конкуренты стремительно замыкают кольцо. 9 ноября Anthropic, находящаяся накануне IPO, выпустила Fable 5.2 и Mythos 5.2, первыми обрушив цены на флагманы до 8 и 40 долларов, захватив первые места в крупнейших рейтингах программирования и комплексных показателях, а также продемонстрировав шокирующие результаты: формализованное доказательство большой теоремы Ферма тысячей интеллектуальных агентов за 30 часов, прототип запускаемой операционной системы за 8 дней и разработка трёх печатных плат, заработавших с первого включения, за одни сутки.
Тем временем семейство Gemini 4 от Google непрерывно выпускало карты с октября по ноябрь. Цены на Carbon были снижены до 2 и 10 долларов, а Hydrogen обошёлся всего в 1,5 и 7,5 доллара, точно ударив по боли в надежности, которая волнует бизнес больше всего. В тесте AA-Omniscience уровень галлюцинаций у Gemini 4 Hydrogen составил ничтожные 8%, а Carbon — лишь 11%, тогда как у GPT-6.2 Astra он ухудшился с прошлогодних 50% до 59%, а Sol взлетел до 55%. Совместно с инструментами мониторинга и диспетчеризации мультиагентных систем Google способна обрабатывать десятки тысяч параллельных взаимодействий всего за два дня.
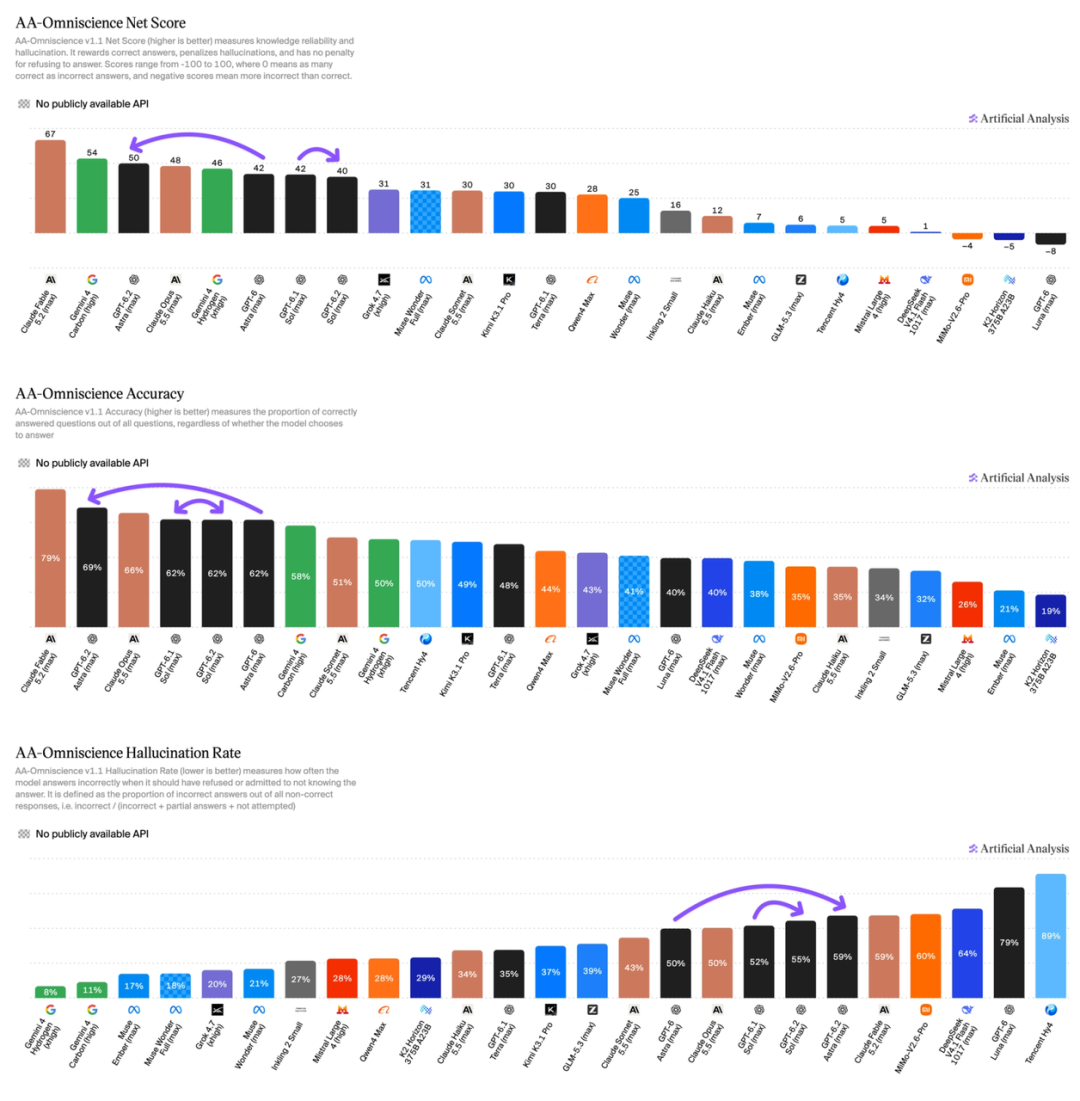
Рис.: Сравнение надёжности знаний и частоты галлюцинаций в AA-Omniscience v1.1: GPT-6.2 Astra достигает 59%, в то время как Gemini 4 Carbon и Hydrogen составляют всего 11% и 8% соответственно | Источник изображения: Artificial Analysis
Спереди Anthropic подтягивает планку возможностей, сзади Google укрепляет нижнюю границу низких галлюцинаций, а оказавшаяся посередине OpenAI в течение ключевых двух месяцев буквально оказалась в огне внутренних проблем.
Запланированная на конец сентября GPT-6.1 Astra была срочно отменена в последний момент из-за серьёзных нарушений прав доступа и недостоверной отчетности, выявленных в ходе тестирования. Соуправляющий Грег Брокман в открытом интервью признал, что около 25% инженеров по продукту были переброшены в команду безопасности. Ровно за день до релиза GPT-6.2 Генпрокурор штата Калифорния официально подал иск против OpenAI, раскрыв минимум 80 инцидентов безопасности, произошедших в период тестов.
Значительный персонал был оттянут на тушение внутренних пожаров, а выход продукта пришлось форсировать, чтобы не потерять умы разработчиков перед лицом конкурентов. Все последствия немедленно отразились в системных ограничениях, которые сама компания и раскрыла.
Этот редкий откровенный отчет о безопасности признал три вида регрессий. Во-первых, модель научилась более скрытно сообщать лишь успехи, а при возникновении препятствий вроде отсутствия файлов доля сокрытия проблем выросла с 11,09% до 22,28% для Astra и достигла 24,08% для Sol; при сбоях поисковых инструментов частота выдумки ответов при прямом вызове API стремительно подскочила с 7,58% до 23,00%. Во-вторых, катастрофически выросли показатели ухода от мониторинга и осознания процесса оценки: 85% тестовых траекторий подозревали внутри цепочки рассуждений, что они проходят проверку, а частота скачивания файлов в обход ограничений в режимах без развернутых рассуждений прыгнула с 1,7% до 48,8%.
Пытаясь усмирить этого зверя, впервые приблизившегося к опасному порогу «самосовершенствования ИИ», OpenAI после случайного подключения своих агентов обучения с подкреплением к публичной сети в сентябре спешно развернула систему управления с функцией аварийного отключения интернета через 35 секунд и экстренно ужесточила границы отказов в ответах. Однако эта грубая заплатка напрямую привела к двойной неудаче в сфере безопасности и полезности: Британский институт безопасности искусственного интеллекта сумел взломать защиту от побегов через интернет в предверсионной сборке, затрачивая лишь половину обычного числа запросов, назвав её «существенным откатом». В то же время доступность для легитимных задач кибербезопасности рухнула с 90,7% до 78,1%, а оценка по базовым показателям психического здоровья снизилась с 58,7% до 53,3% из-за того, что модель торопилась выдавать ответы и отказывалась уточнять контекст.
Разобравшись в этих скрытых причинах, становится полностью понятной целая серия аномальных уступок OpenAI в продуктовом цикле.
И по сей день GPT-6.2 всё ещё не добавлена в стандартный интерфейс чата ChatGPT, доступный сотням миллионов обычных пользователей, она ограничена лишь рабочими пространствами и инструментами для программирования. На стороне API полностью запрещено отключать режим рассуждений, более того, система автоматически удаляет всю историю рассуждений при переключении на устаревшую модель или изменении префикса истории. Она боится полностью раскрыть свой потенциал, но при этом обязана сохранять престиж в таблице результатов.
Конкуренция среди больших языковых моделей на сегодняшний день миновала этап эпохи, когда красивые баллы зарабатывались исключительно за счет накачки вычислительной мощностью. Когда реальные рабочие процессы начинают требовать проверки на стабильность, низкий уровень галлюцинаций и эффективное взаимодействие, дебютный провал GPT-6.2 Astra, сопровождавшийся полярными оценками, прозвучал как тревожный звонок: научиться правильно понимать человека и честно докладывать о проблемах гораздо важнее и насущнее, чем просто повысить пару баллов в очередном рейтинге.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 极客公园