


Статья Google по ИИ, обрушившая акции производителей памяти на $90 млрд, обвиняется в фальсификации экспериментов
Автор: TechFlow
Статья Google, утверждающая о «снижении потребления памяти ИИ в 6 раз», на прошлой неделе привела к потере более чем 900 миллиардов долларов рыночной капитализации акциями мировых производителей чипов памяти, таких как Micron и SanDisk.
Однако уже через два дня после публикации статьи контрагент алгоритма, которого он якобы «подавляет» — постдок Цюрихского федерального института технологий (ETH Zurich) Гао Цзяньян опубликовал открытое письмо объёмом в десять тысяч слов. Он обвинил команду Google в том, что для тестирования конкурентов использовался скрипт на Python под одноядерный CPU, тогда как собственное решение тестировалось на GPU A100, а также в отказе исправить проблему, даже после того, как им об этом сообщили до подачи статьи. Количество просмотров на платформе Zhihu быстро превысило 4 миллиона, официальный аккаунт Stanford NLP сделал репост, что вызвало бурную реакцию как в академических кругах, так и на рынке.
(Связанная статья: Одна статья, обрушившая акции сектора памяти)
Суть данного спора не так уж сложна: систематически ли искажает эта статья из числа публикаций ведущих конференций по ИИ, официальное продвижение которой способствовала сама Google и которая напрямую вызвала панические продажи в мировом секторе чипов, ранее опубликованную исследовательскую работу, формируя мифическое преимущество в производительности посредством намеренно неравноценных экспериментов?
Что делает TurboQuant: сжимает «черновик» ИИ до одной шестой от первоначального объёма
При генерации ответов большие языковые модели одновременно пишут ответ и обращаются к ранее вычисленным данным. Эти промежуточные результаты временно хранятся в видеопамяти, что в отрасли называют «KV Cache» (кэшем ключей и значений). Чем длиннее диалог, тем толще этот «черновик», тем выше расход видеопамяти и выше затраты.
Алгоритм TurboQuant, разработанный исследовательской командой Google, предлагает в качестве главного преимущества сжать эту «бумагу для черновиков» до 1/6 от исходного объёма, при этом гарантируя нулевую потерю точности и повышение скорости вывода информации вплоть до 8 раз. Статья впервые была опубликована на академическом препринт-сервере arXiv в апреле 2025 года, принята ведущей конференцией в области ИИ ICLR 2026 в январе 2026 года, а 24 марта переупакована и заново продвигалась через официальный блог Google.
На техническом уровне идею TurboQuant можно свести к следующему: сначала с помощью математического преобразования «очищенные» разрозненные данные приводятся к единому формату, затем каждое значение сжимается с использованием заранее рассчитанной оптимальной таблицы компрессии, и наконец применяется механизм коррекции ошибок в 1 бит для исправления вычислительных погрешностей, возникших из-за сжатия. Независимые реализации сообщества подтвердили, что эффект сжатия в основном соответствует заявленному, а математический вклад алгоритма на самом деле существует.
Вопрос спора заключается не в том, можно ли использовать TurboQuant, а в том, что именно сделала Google, чтобы доказать его «несравненное превосходство над конкурентами».
Открытое письмо Гао Цзяньяна: три обвинения, каждое из которых попадает точно в цель
27 марта в 22:00 Гао Цзяньян опубликовал на платформе Zhihu подробную статью, одновременно разместив официальный комментарий на платформе рецензирования ICLR OpenReview. Гао Цзяньян является первым автором алгоритма RaBitQ, опубликованного в 2024 году на ведущей конференции в области баз данных SIGMOD; он решает ту же задачу — эффективное сжатие многомерных векторов.
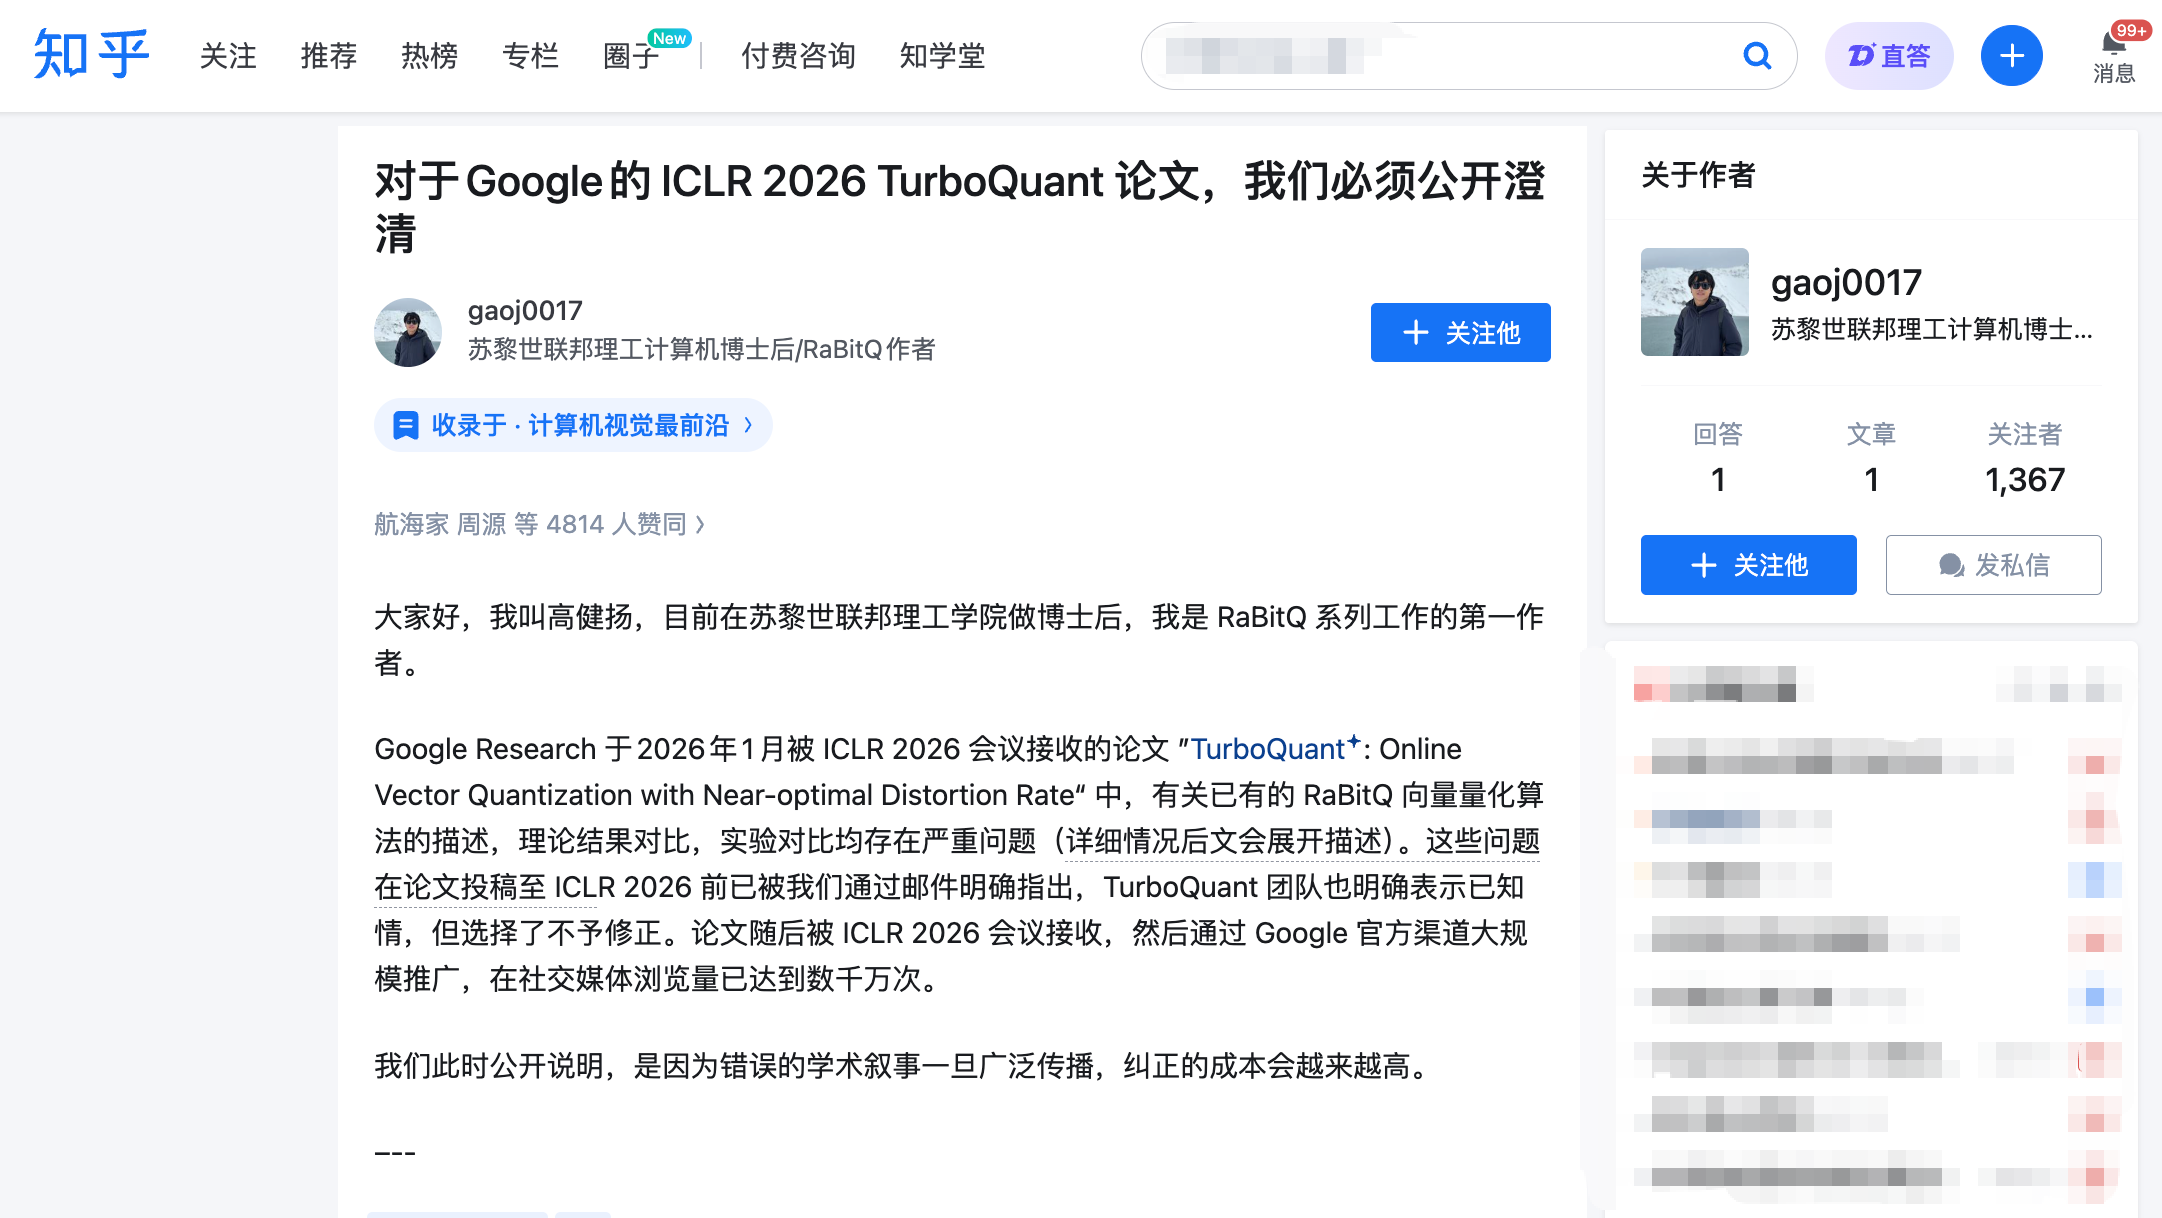
Его обвинения состоят из трёх пунктов, каждый из которых подтверждается перепиской по электронной почте и хронологией событий.
Обвинение первое: использование чужого ключевого метода без упоминания на протяжении всей статьи.
Техническая основа как TurboQuant, так и RaBitQ содержит один ключевой общий этап: перед сжатием данных к ним применяется операция «случайного вращения». Данный шаг преобразует изначально неравномерно распределённые данные в предсказуемое равномерное распределение, что значительно облегчает процесс сжатия. Это самая суть и наиболее близкая часть обоих алгоритмов.
Сами авторы TurboQuant признали этот факт даже в ответах рецензентам, однако ни разу прямо не осветили связь этого метода с RaBitQ во всём тексте статьи. Более важным контекстом является то, что второй автор TurboQuant Маджид Далири (Majid Daliri) в январе 2025 года сам вышел на связь с командой Гао Цзяньяна с просьбой помочь в отладке написанной им версии Python, основанной на исходном коде RaBitQ. В письме подробно описывались шаги воспроизведения и сообщения об ошибках — иными словами, команда TurboQuant прекрасно знала технические детали RaBitQ.
Один из анонимных рецензентов ICLR также самостоятельно отметил совпадение используемых технологий и потребовал их полноценного обсуждения. Однако в финальной версии статьи команда TurboQuant не только не добавила необходимого анализа, но и переместила содержащееся в основном тексте описание RaBitQ (и так уже неполное) в приложение.
Обвинение второе: голословное заявление о теоретической «субоптимальности» оппонента.
В статье TurboQuant напрямую клеймит RaBitQ ярлыком «теоретически субоптимальный» (suboptimal), обосновывая это тем, что математический анализ RaBitQ «слишком груб». Однако Гао Цзяньян указывает, что в расширенной версии статьи RaBitQ строго доказано, что ошибка её сжатия достигает математически оптимальной границы — данное заключение было опубликовано на одной из ведущих конференций по теоретической информатике.
В мае 2025 года команда Гао Цзяньяна в ходе нескольких этапов переписки детально объяснила оптимальность теории RaBitQ. Второй автор TurboQuant Далири подтвердил, что проинформировал всех соавторов. Тем не менее, в итоговой статье сохранено определение «субоптимальный», без предоставления каких-либо контраргументов.
Обвинение третье: создание заведомо неравных условий («соперник скован, а вы вооружены») в экспериментальном сравнении.
Это самый весомый пункт всего письма. Гао Цзяньян указывает, что в экспериментах по сравнению скорости статья TurboQuant накладывает два слоя неравноправных условий:
Во-первых, официальные создатели RaBitQ предоставляют оптимизированный код на C++ (с поддержкой многопоточного параллелизма по умолчанию), однако команда TurboQuant им воспользовалась, вместо этого тестируя RaBitQ на переведённой ими версии Python. Во-вторых, при тестировании RaBitQ использовался одноядерный CPU с отключённым многопоточностью, тогда как для TurboQuant применялся графический ускоритель NVIDIA A100 GPU.
Комбинация этих двух условий приводит к тому, что читатель приходит к выводу, что «RaBitQ работает медленнее TurboQuant на несколько порядков», оставаясь в неведении относительно того, что этот результат обусловлен фактом искусственного ограничения возможностей оппонента перед сравнением. В статье недостаточно полно раскрываются различия в условиях экспериментов.
Ответ Google: «Случайное вращение является общепринятой технологией, невозможно цитировать каждую статью»
Как сообщил Гао Цзяньян, в электронном письме от марта 2026 года команда TurboQuant заявила: «Использование случайного вращения и преобразования Джонсона-Линдстрёма уже стало стандартной практикой в данной области, мы физически не можем цитировать каждую статью, использующую эти методы».
Команда Гао Цзяньяна считает, что здесь происходит подмена понятий: дело не в необходимости цитировать все работы, где применялось случайное вращение, а в том, что RaBitQ стала первой работой, объединившей этот метод со сжатием векторов в абсолютно одинаковых постановках задачи и строго доказавшей его оптимальность, поэтому статья TurboQuant должна была точно описать соотношение между ними.
Официальный аккаунт Stanford NLP Group в социальной сети X сделал репост заявления Гао Цзяньяна. Команда Гао уже разместила открытый комментарий на платформе ICLR OpenReview, подала официальную жалобу председателю конференции ICLR и этическому комитету, а в дальнейшем планирует опубликовать подробный технический доклад на arXiv.
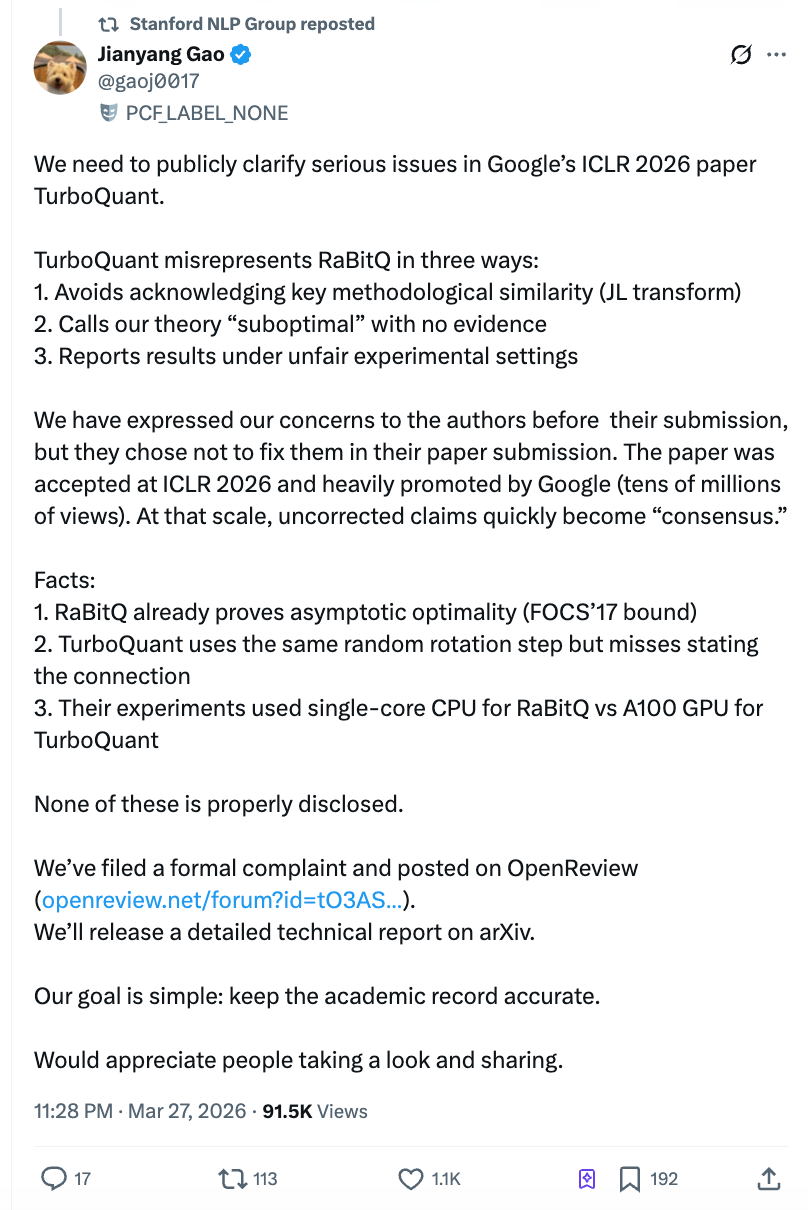
Независимый технический блогер Дарио Сальвати (Dario Salvati) в своём анализе дал относительно нейтральную оценку: TurboQuant действительно вносит реальный вклад в математические методы, однако связь с RaBitQ гораздо теснее, чем утверждается в формулировках статьи.
Потеря 900 млрд долларов капитализации: научный спор усиливает рыночную панику
Момент возникновения этой академической дискуссии исключительно чувствителен. После того как 24 марта Google анонсировала TurboQuant через свой официальный блог, мировой сектор чипов памяти подвергся резкой распродаже. Согласно сообщениям множества СМИ, включая CNBC, акции Micron падали шесть торговых дней подряд, совокупное снижение превысило 20%; за один день SanDisk потерял 11%; южнокорейская SK Hynix снизилась примерно на 6%, Samsung Electronics упала почти на 5%, японская Kioxia подешевела примерно на 6%. Логика рыночной паники проста и груба: если программное сжатие может снизить потребность в памяти для инференса ИИ в 6 раз, перспективы спроса на чипы памяти получат структурное снижение.
Аналитик Morgan Stanley Джозеф Мур (Joseph Moore) в исследовательском отчёте от 26 марта опроверг эту логику, сохранив рейтинги «Покупать» для Micron и SanDisk. Мур указал, что TurboQuant сжимает лишь определённый тип кэша — KV Cache, а не общее потребление памяти, квалифицировав это как «нормальное улучшение производительности». Аналитик Wells Fargo Эндрю Роча (Andrew Rocha) также сослался на парадокс Джевонса, отметив, что рост эффективности и снижение затрат могут, наоборот, стимулировать развёртывание ИИ в ещё больших масштабах, что в конечном итоге повысит спрос на память.
Старая статья, новая упаковка: риски передачи от исследований ИИ к рыночным нарративам
По анализу технического блогера Бена Пуладайана (Ben Pouladian), статья TurboQuant была опубликована ещё в апреле 2025 года и не является новым исследованием. 24 марта Google заново упаковала и продвинула её через официальный блог, однако рынок начал оценивать её как прорыв нового поколения. Данная маркетинговая стратегия «старая статья, новый релиз», в сочетании с возможными смещениями в экспериментах самой статьи, обнажает системные риски в цепи передачи от академических публикаций по ИИ к рыночным нарративам.
Для инвесторов в инфраструктуру ИИ, когда статья заявляет о «порядковом» улучшении производительности, в первую очередь необходимо задаваться вопросом о справедливости условий базового сравнения.
Команда Гао Цзяньяна чётко дала понять, что продолжит добиваться официального решения вопроса. Представители Google пока не дали официальной реакции на конкретные обвинения из открытого письма.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 深潮TechFlow














