


a16z: Крупные модели теряют память при развёртывании, сможет ли «непрерывное обучение» разорвать этот замкнутый круг?
Автор: Малика Аубакирова, Мэтт Борнстин
Перевод: TechFlow
Введение от TechFlow: После завершения обучения большие языковые модели (LLM) как бы «замораживаются»: после развертывания они функционируют исключительно за счет внешних заплаток вроде контекстных окон и RAG, что по сути аналогично состоянию пациентов с амнезией из фильма «Помнить» — они могут осуществлять поиск, но не способны по-настоящему усваивать новую информацию. Два партнера a16z провели систематический обзор перспективного направления исследований в области «непрерывного обучения» (continual learning), разобрав три ключевых подхода: через контекст, модули и обновление весов, чтобы раскрыть технологическую гонку, способную переопределить потолок возможностей ИИ.
В фильме Кристофера Нолана «Помнить» (Memento) главный герой Леонард Шелби живет в раздробленном настоящем. Полученные повреждения мозга вызвали у него антероградную амнезию, из-за чего он не способен формировать новые воспоминания. Каждые несколько минут его мир перезагружается, он оказывается в ловушке вневременного «сейчас», забывая, что произошло только что, и не зная, что будет дальше. Чтобы выжить, он татуирует факты на своем теле и делает мгновенные снимки, опираясь на эти внешние инструменты для компенсации функции памяти, которую его мозг больше не может выполнять.
Большие языковые модели также существуют в подобном вневременном настоящем. После завершения обучения колоссальные объемы знаний замораживаются внутри параметров модели; она не способна формировать новые воспоминания или обновлять свои параметры на основе нового опыта. Чтобы компенсировать этот недостаток, мы возводим вокруг нее целую конструкцию внешних опор: история чатов служит кратковременной запиской, система поиска выступает в роли внешней тетради, а системные промпты напоминают татуировки на теле. Однако сама модель так никогда и не способна полностью интернализировать эту новую информацию.
Всё больше исследователей считают, что этого недостаточно. Возможность решения задач методами обучения в контексте (ICL) предполагает лишь то, что ответ (или его части) уже где-то хранится. Но для тех задач, где требуется именно открытие нового (например, доказательство совершенно новой математической теоремы), противостояние в кибербезопасности (атаки и защита), или же для слишком неявных, невыразимых словами знаний, существуют веские основания полагать: модели необходим механизм записи новых знаний и опыта непосредственно в параметры после развертывания.
Обучение в контексте носит временный характер. Настоящее обучение требует сжатия. Пока мы не позволим моделям непрерывно сжимать данные, они будут заперты в том самом «вневременном настоящем» из «Помнить». И наоборот: если мы научим модель конструировать собственную архитектуру памяти вместо того чтобы полагаться на внешние кастомные инструменты, это может открыть совершенно новое измерение для масштабирования (scaling).
Это направление исследований называетсянепрерывным обучением(continual learning). Эта концепция не нова (см. исследование McCloskey и Cohen 1989 года), однако мы считаем её одним из важнейших направлений в современной сфере ИИ. Взрывной рост возможностей моделей за последние два-три года стал еще отчетливее обнажать пропасть между тем, что модель «знает», и тем, что она потенциально «может знать». Цель данной статьи — поделиться знаниями, которые мы черпали от ведущих исследователей в этой области, помочь структурировать различные пути развития непрерывного обучения и стимулировать обсуждение этой темы в стартап-экосистеме.
Примечание: Появлению этой статьи способствует глубокий обмен мнениями с группой выдающихся исследователей, аспирантов и предпринимателей, щедро поделившихся своим опытом и взглядами на непрерывное обучение. Их инсайты, охватывающие как теоретические основы, так и инженерные реалии post-deployment обучения, сделали материал гораздо более фундаментальным, чем мог бы быть при самостоятельном написании. Благодарим вас за предоставленное время и идеи!
Сначала о контексте
Прежде чем обосновывать необходимость обучения на уровне параметров (то есть обновления весов модели), важно признать факт: контекстное обучение действительно работает. Более того, есть веские аргументы в пользу того, что оно продолжит доминировать.
По своей природе Transformer представляет собой последовательный предиктор следующего токена на условиях предыдущих. Подавая ему корректную последовательность, можно добиться поразительно богатого поведения, совершенно не касаясь весов. Именно поэтому столь эффективны методы управления контекстом, промпт-инжиниринга, инструктивного дообучения и демонстрации примеров с малым объемом данных. Интеллект закодирован в статических параметрах, а демонстрируемые возможности драматически варьируются в зависимости от того, что вы помещаете в окно.
Хороший тому пример — недавняя глубокая статья Cursor о масштабировании автономных программирующих агентов: веса модели остаются неизменными, а реальную работу системы обеспечивает тщательная оркестровка контекста — что именно загружать, когда делать сводки и как поддерживать связность состояния в течение часов автономной работы.
Еще один отличный пример — OpenClaw. Его взрывная популярность связана не со спецправами доступа к моделям (базовые модели доступны всем), а с тем, как невероятно эффективно он конвертирует контекст и инструменты в рабочее состояние: отслеживание действий пользователя, структурирование промежуточных результатов, решение о моменте повторной подачи промпта, сохранение персистентной памяти о предыдущей работе. OpenClaw вывел проектирование «оболочки» (shell design) для агентов на уровень самостоятельной дисциплины.
Когда промпт-инжиниринг только появился, многие исследователи скептически относились к идее, что «только промпты» могут стать полноценным интерфейсом. Это выглядело как хакинг. Однако это естественное порождение архитектуры Transformer, не требующее переобучения и автоматически улучшающееся вместе с прогрессом моделей. Чем сильнее модель, тем мощнее промпты. «Грубые, но нативные» интерфейсы часто побеждают, потому что напрямую интегрированы в базовую систему, а не борются с ней. Траектория развития LLM вплоть до сегодняшнего дня подтверждает эту тенденцию.
Модели пространства состояний: стероидная версия контекста
По мере того как основные рабочие процессы смещаются от прямых вызовов базовых LLM к циклам работы агентов, нагрузка на модели, опирающиеся на контекстное обучение, возрастает. В прошлом ситуация полного заполнения контекстного окна встречалась относительно редко. Обычно это случалось, когда LLM просили выполнить длинную цепочку дискретных задач, и слой приложения мог довольно прямолинейно обрезать и сжимать историю чата. Однако для агентов одна задача может поглощать значительную часть всего доступного контекста. Каждый шаг цикла агента зависит от контекста, переданного в предыдущей итерации. Кроме того, они часто терпят неудачу после 20–100 шагов из-за «потери нити»: контекст заполняется, связность падает, алгоритм не может сойтись.
Поэтому ведущие ИИ-лаборатории сейчас инвестируют огромные ресурсы (то есть проводят масштабные тренировки) в разработку моделей с сверхдлинным контекстным окном. Это естественно сложившийся путь, поскольку он опирается на уже работающий метод (контекстное обучение) и соответствует общеиндустриальному тренду на переход к вычислениям на этапе инференса. Наиболее распространенная архитектура предполагает чередование стандартных блоков внимания с фиксированными слоями памяти, то есть моделями пространства состояний (State Space Models, SSM) и вариациями линейного внимания (далее统称 SSM). SSM обеспечивают принципиально лучшую кривую масштабирования (scaling curve) в сценариях с длинным контекстом.
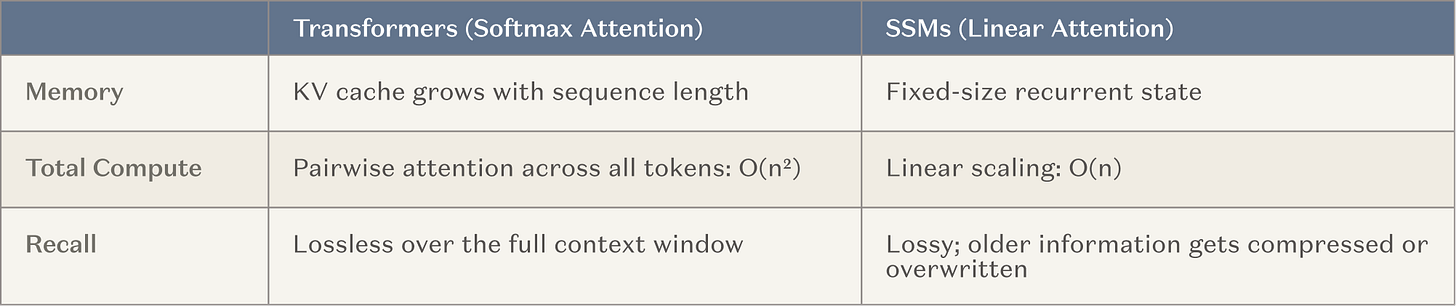
Примечание к рисунку: Сравнение масштабирования SSM и традиционных механизмов внимания
Цель состоит в том, чтобы помочь агентам увеличить количество шагов бесперебойной работы на несколько порядков — примерно с 20 до 20 000 — без потери широкого спектра навыков и знаний, предоставляемых традиционным Transformer. При успехе это станет серьезным прорывом для долгоиграющих агентов. Более того, данный подход даже можно рассматривать как форму непрерывного обучения: хотя веса модели и не обновляются, внедряется внешний слой памяти, которому практически не требуется сброс.
Таким образом, эти непараметрические подходы являются реальными и мощными. Любая оценка возможностей непрерывного обучения должна начинаться с них. Вопрос не в том, работают ли сегодняшние контекстные системы — они работают. Вопрос в другом: увидели ли мы предел возможного, и смогут ли новые методы продвинуть нас дальше.
Что упускает контекстный подход: «Ошибка бесконечного архива»
«То, что происходит с AGI и процессом предобучения, заключается в том, что в каком-то смысле они переоценивают свои возможности… Человек не является AGI. Да, у человека есть базовый набор навыков, но человеку не хватает огромного массива знаний. Мы полагаемся на непрерывное обучение. Если я создам суперумного пятнадцатилетнего парня, который ничего не знает. Отличника школы, жаждущего учиться. Можно сказать: иди будь программистом, иди врачом. Сам процесс развертывания будет подразумевать определенное обучение и метод проб и ошибок. Это процесс, а не просто выброс готового продукта вовне. — Ильяс Сутскер»
Представьте себе систему с неограниченным объемом хранения. Самый большой архив в мире, где каждый факт идеально проиндексирован и доступен для мгновенного поиска. Он может найти любую информацию. Обучился ли он чему-нибудь?
Нет. Его никогда не заставляли сжимать данные.
Это центральная идея нашего утверждения, отсылающая к ранее высказанной Ильясом Сутскером мысли: LLM по своей сути являются алгоритмами сжатия. В процессе обучения они сжимают интернет в параметры. Это сжатие происходит с потерями, и именно благодаря этим потерям проявляется их сила. Сжатие вынуждает модель искать паттерны, обобщать информацию и создавать репрезентации, способные мигрировать между различными контекстами. Модель, которая запоминает наизусть все обучающие выборки, уступает той, что выделяет лежащие в основе закономерности. Сжатие с потерями само по себе является обучением.
Примечательно, что механизм, делающий LLM такими мощными во время предобучения (сжатие исходных данных в компактные, мигрирующие репрезентации), — это ровно то, чего мы отказываемся позволять им делать после развертывания. Мы прекращаем процесс сжатия с момента публикации, заменяя его внешней памятью. Разумеется, большинство оболочек агентов каким-то образом сжимают контекст. Но разве «жестокий урок» (bitter lesson) не учит нас тому, что сама модель должна научиться такому сжатию напрямую и в масштабе?
Юй Сун привел пример для иллюстрации этой дискуссии: математику. Возьмите последнюю теорему Ферма. На протяжении более 350 лет ни один математик не смог ее доказать не из-за недостатка литературы, а из-за крайней новизны решения. Концептуальная дистанция между существующими математическими знаниями и окончательным ответом была чрезмерно велика. Когда Эндрю Уайлс наконец решил ее в 1990-х, он потратил семь лет почти изолированной работы, изобретая абсолютно новые методы для достижения цели. Его доказательство строилось на успешной связке двух разных ветвей математики: эллиптических кривых и модулярных форм. Хотя Кен Рибет ранее доказал, что установление этого моста автоматически решит теорему Ферма, до Уайлса ни у кого не было теоретического инструмента, чтобы реально построить такой мост. Аналогичный аргумент применим и к доказательству гипотезы Пуанкаре Григорием Перельманом.
Ключевой вопрос: Доказывают ли эти примеры, что LLM недостает чего-то фундаментального — способности обновлять априорные знания и совершать по-настоящему креативные скачки мышления? Или же эта история доказывает обратное — что все человеческие знания представляют собой лишь данные, пригодные для обучения и рекомбинации, а Уайлс и Перельман продемонстрировали лишь то, что LLM смогут повторить в еще большем масштабе?
Этот вопрос относится к эмпирическим, однозначного ответа пока нет. Но нам точно известно: существует множество классов проблем, где контекстное обучение сегодня дает сбои, а обучение на уровне параметров принесло бы пользу. Например:
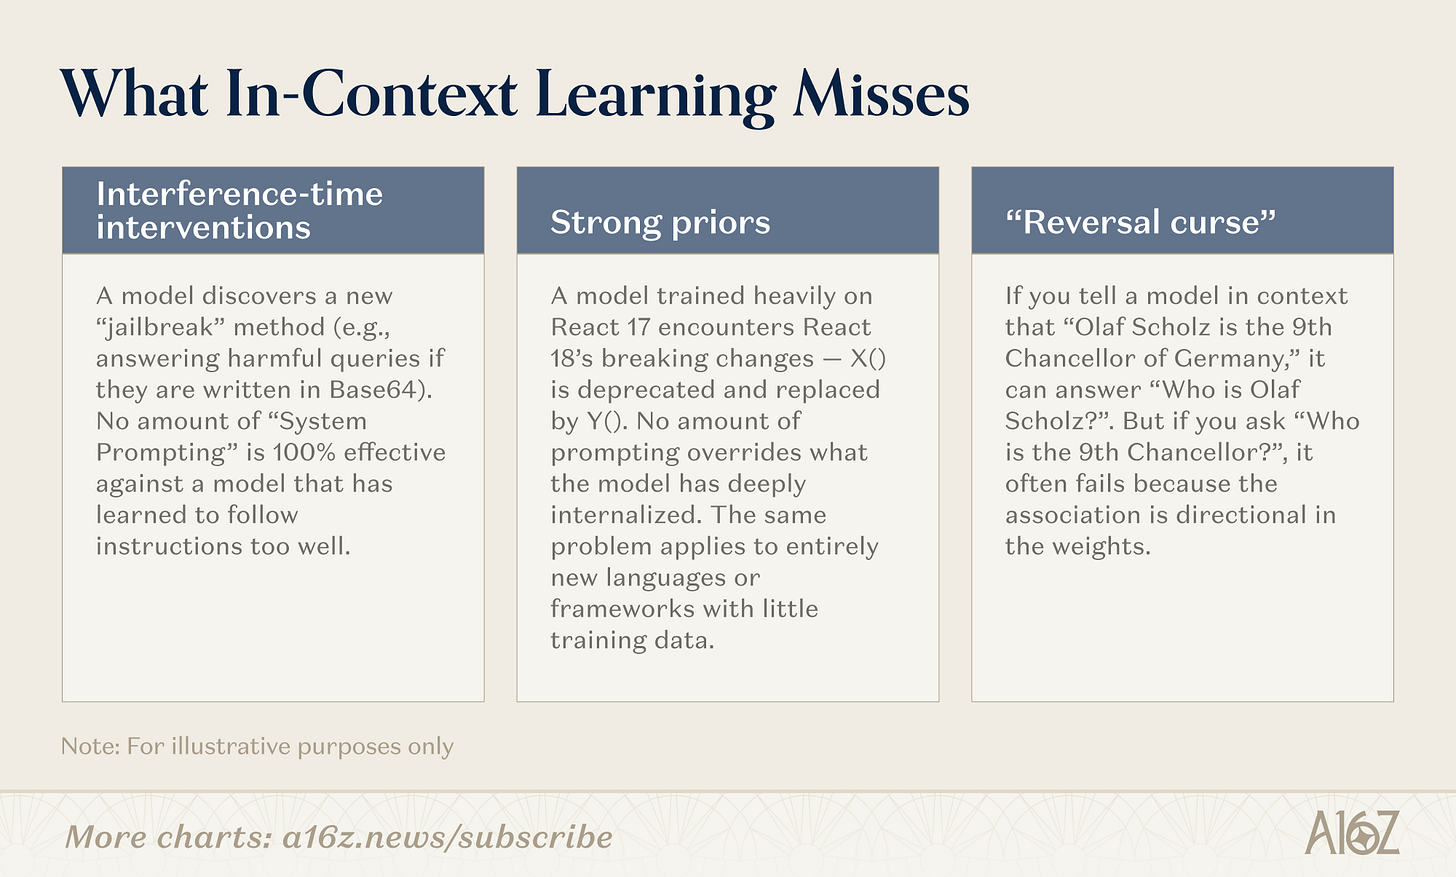
Примечание к рисунку: Классы проблем, где терпит крах контекстное обучение, но где вероятно преобладание параметрического обучения
Что еще важнее, контекстное обучение оперирует исключительно теми объектами, которые поддаются вербализации, тогда как веса способны кодировать концепции, недоступные словам в промптах. Некоторые паттерны обладают слишком высокой размерностью, излишней неявностью или сложной иерархической структурой, чтобы поместиться в контекстное окно. Например, визуальные текстуры, позволяющие на медицинском снимке отличить доброкачественный артефакт от опухоли, или аудио микроколебания, задающие уникальный ритм речи конкретного человека. Эти паттерны трудно декомпозировать на точные лексемы. Язык способен лишь приблизиться к ним. Как бы длинные ни были промпты, они не передадут подобные вещи; данный тип знаний может сохраняться лишь внутри весов. Они живут в скрытом пространстве репрезентаций, изученных моделью, а не в тексте. Независимо от того, насколько расширится окно контекста, всегда найдутся знания, которые невозможно описать текстом, а можно лишь передать через параметры.
Возможно, именно этим объясняется, почему явные функции «памяти робота» (например, Memory в ChatGPT) чаще вызывают у пользователей дискомфорт, а не восторг. Пользователям на самом деле нужны не «воспоминания», а «способности». Модель, интернализовавшая ваши поведенческие паттерны, способна экстраполировать их на новые условия; та, что просто вспоминает вашу историю, — нет. Пропасть между цитатой «Вот что вы писали в прошлый раз при ответе на это письмо» (буквальное воспроизведение) и заявлением «Я настолько понимаю ваш стиль мышления, что могу предвидеть, что вам нужно» — это и есть разница между поиском и обучением.
Основы непрерывного обучения
Существует множество путей организации непрерывного обучения. Граница здесь проходит не между наличием или отсутствием функции памяти, а между тем, где:происходит сжатие? Данные пути образуют непрерывный спектр: от нулевого сжатия (чистый поиск, замороженные веса) до полной внутренней компрессии (обучение на уровне весов, повышение интеллекта модели), с важным переходным сегментом посередине (модульный подход).
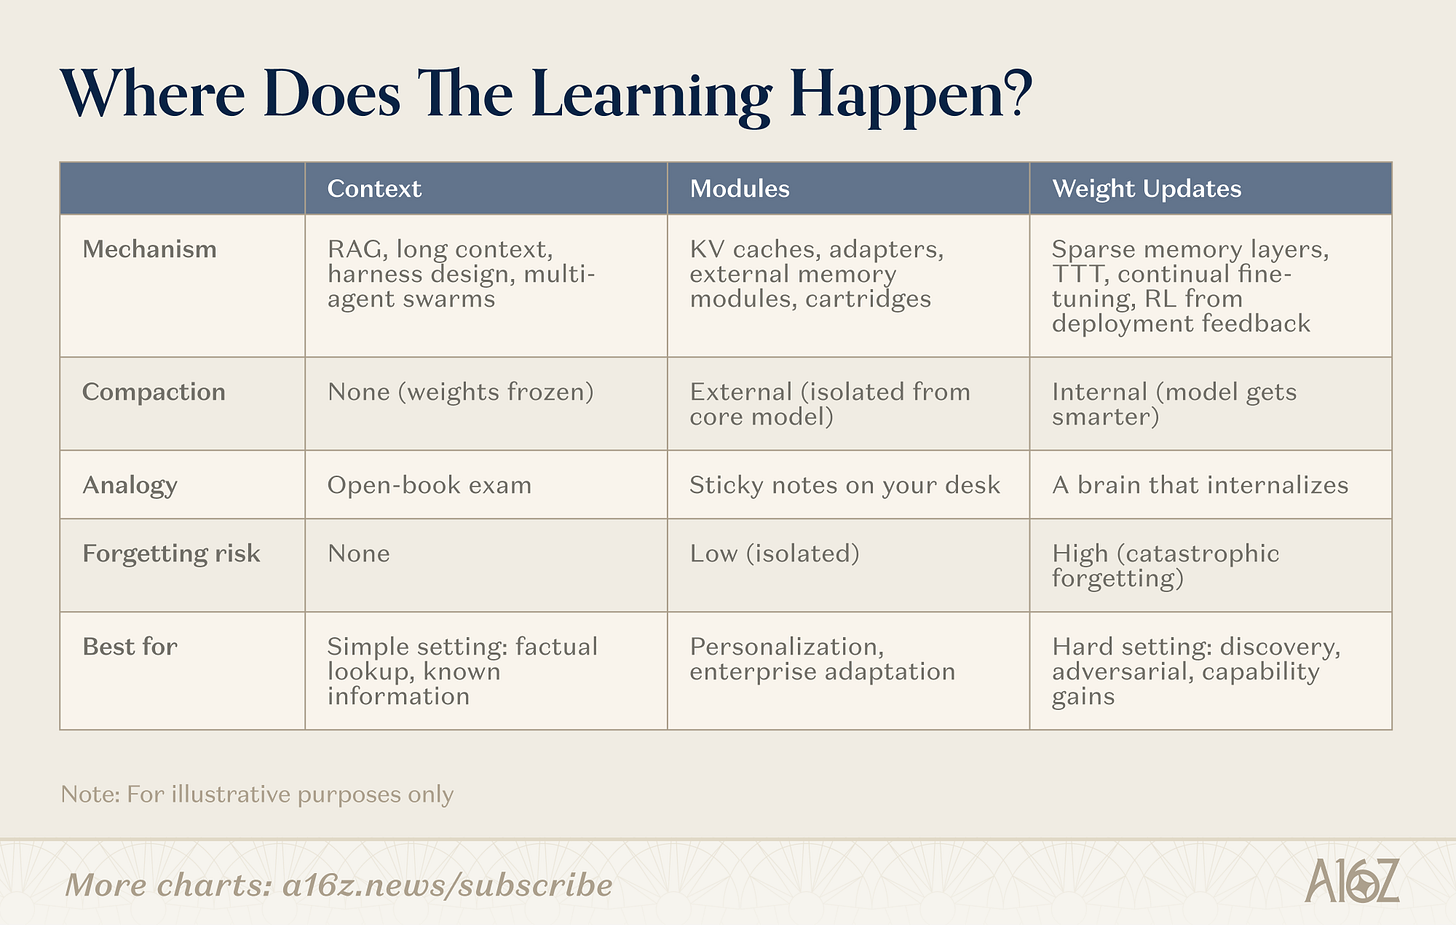
Примечание к рисунку: Три пути непрерывного обучения — контекст, модули, веса
Контекст
На стороне контекста команды развивают более умные пайплайны поиска, оболочки агентов и оркестровку промптов. Это наиболее зрелый класс: инфраструктура проверена, пути развертывания очевидны. Главное ограничение кроется в глубине — длине контекстного окна.
Стоящее отдельного внимания новое направление — использование многоагентных архитектур как стратегии масштабирования самого контекста. Если одна модель ограничена окном в 128K токенов, координированная группа агентов, где каждый обладает своим контекстом, фокусируется на определенном срезе задачи и обменивается результатами, способна в совокупности имитировать почти неограниченную рабочую память. Каждый агент выполняет контекстное обучение в рамках своего окна; система отвечает за агрегацию. Проект Karpathy по автоматизированному исследованию и пример создания Cursor браузерного веб-скрейпера служат ранними кейсами. Это сугубо непараметрический метод (без изменения весов), однако он кардинально расширяет верхний предел возможностей контекстных систем.
Модули
В сегменте модульных решений команды создают плагинов знанийевых модулей (сжатые KV-кэши, адаптеры, внешние хранилища памяти), позволяющие базовой модели специализироваться без полного переобучения. Модель на 8B параметров плюс подходящий модуль могут достигать показателей модели на 109B в целевых задачах при потреблении памяти, составляющей лишь долю процента от оригинала. Главный плюс — полная совместимость с существующей инфраструктурой Transformer.
Веса
На стороне обновления весов исследователи стремятся к истинному параметрическому обучению: создание разреженных слоев памяти, обновляющих лишь релевантные срезы весов, RL-циклы оптимизации модели на основе обратной связи и обучение на этапе тестирования (test-time training), сжимающее контекст непосредственно в веса во время вывода. Это самые фундаментальные подходы и самые сложные в промышленном внедрении, но именно они позволяют модели в полном объеме интернализовать новые знания или навыки.
Существуют различные конкретные механизмы обновления параметров. Вот несколько ключевых направлений исследований:
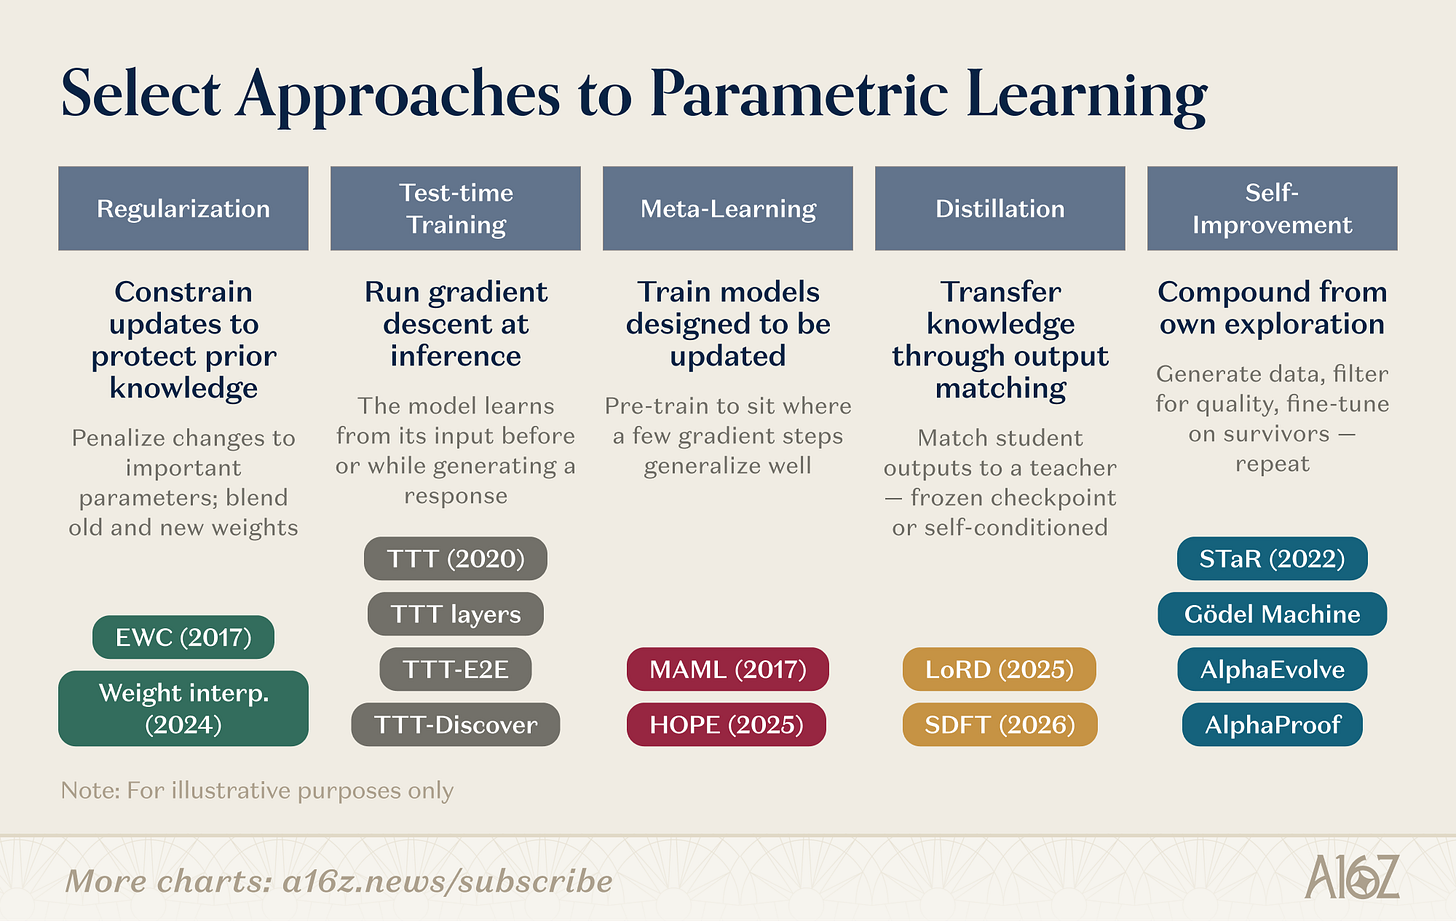
Примечание к рисунку: Обзор исследовательских направлений обучения на уровне весов
Исследования уровня весов охватывают ряд параллельных траекторий.Методы регуляризации и пространство весовимеют самую долгую историю: EWC (Kirkpatrick et al., 2017) штрафует изменение весов в зависимости от их значимости для предыдущих задач; интерполяция весов (Kozal et al., 2024) смешивает старые и новые конфигурации в пространстве параметров, но оба метода склонны к хрупкости при масштабировании.Обучение на этапе тестирования (Test-Time Training)заложено Sun et al. (2020) и впоследствии превратилось в архитектурные примитивы (слои TTT, TTT-E2E, TTT-Discover) с иным подходом: спуск по градиенту выполняется непосредственно на тестовых данных, чтобы в нужный момент сжать новую информацию в параметры.Метаобучениеставит вопрос: можем ли мы научить модели понимать принципы собственного обучения? От инициализации параметров MAML, дружелюбной к small-data (Finn et al., 2017), до вложенного обучения (Nested Learning, 2025) от Behrouz et al., представляющего модель в виде иерархической задачи оптимизации, где быстрые адаптации и медленные обновления модулей протекают на разных временных шкалах, вдохновленные биологическим консолидированием памяти.
Дистилляциясохраняет знания о предыдущих задачах за счет сопоставления student-модели с замороженными контрольными точками teacher-модели. LoRD (Liu et al., 2025) делает дистилляцию достаточно эффективной для непрерывного применения путем одновременного сокращения размера модели и буфера воспроизведения. Автодистилляция (SDFT, Shenfeld et al., 2026) меняет источник данных, используя собственный вывод модели в экспертных условиях в качестве сигнала обучения, тем самым обходя катастрофическое забывание при последовательном тонком настройке.Рекурсивное самосовершенствованиедвижется по схожему маршруту: STaR (Zelikman et al., 2022) прокачивает способность к рассуждению через самостоятельно генерируемые цепи дедукции; AlphaEvolve (DeepMind, 2025) выявляет алгоритмические оптимизации, оставленные без изменений десятилетиями; «Эра опыта» (Experience Era, 2025) Silvera и Sutton определяет обучение агентов как непрерывный поток жизненного опыта, не останавливающийся ни на секунду.
Эти исследовательские направления начинают конвергировать. TTT-Discover уже объединяет тестовое обучение с RL-driven exploration. HOPE вкладывает циклы быстрого и медленного обучения внутрь единой архитектуры. SDFT превращает дистилляцию в базовую операцию самосовершенствования. Границы между столбцами становятся размытыми. Системы непрерывного обучения следующего поколения, вероятнее всего, будут комбинировать множественные стратегии: использовать регуляризацию для стабилизации, метаобучение для ускорения и самосовершенствование для сложного процента развития. Растущее число стартапов уже активно инвестирует в различные уровни данного технологического стека.
Карта стартапов в сфере непрерывного обучения
На непараметрической стороне спектра находятся наиболее узнаваемые игроки. Компании, разрабатывающие оболочки (Letta, mem0, Subconscious), строят оркестрационные слои и каркас для управления контентом в окне контекста. Внешние хранилища и RAG-инфраструктура (Pinecone, xmemory) выступают опорой для поиска. Данные имеются, основная задача — вовремя подать релевантные срезы информации модели. По мере расширения контекстных окон дизайн-пространство этих компаний расширяется; особенно в сегменте оболочек появляется новая волна стартапов, решающих управление все более сложными стратегиями контекста.
Параметрическая сторона находится на более ранней стадии и отличается большей эклектичностью. Здесь компании экспериментируют с различными вариантами «постдеплоиментного сжатия», позволяющими модели интернализовать новую информацию в своих весах. Подходы условно делятся на несколько различных стратегий относительно того, «как именно» модель должна обучаться после релиза.
Частичное сжатие: обучение без полного переобучения. Часть команд занимается созданием плагинов знанийевых модулей (сжатые KV-кэши, адаптеры, внешняя память), позволяющих универсальным моделям проходить специализацию без трогания основных весов. Общая логика проста: вы получаете осмысленное сжатие (далеко не просто поиск), сохраняя компромисс стабильности и пластичности в управляемых границах, так как обучение изолировано и не рассеивается по всему параметрическому пространству. Модель на 8B параметров с подходящим модулем способна показать результаты модели вдвое крупнее в целевых задачах при расходовании ресурсов в разы меньше. Преимущество кроется в композиции: модули plug-and-play совместимы с существующей архитектурой Transformer, их можно независимо менять или апдейтить, а затраты на эксперименты несоизмеримо ниже стоимости полного переобучения.
Циклы RL и обратной связи: обучение на сигналах. Другие команды делают ставку на мысль, что самый богатый массив сигналов для пост-деплоиментного обучения уже присутствует в самом цикле эксплуатации — корректировки от пользователя, успехи и провалы задач, награды от реальных результатов. Основная идея заключается в том, что модель должна воспринимать каждое взаимодействие как потенциальный тренировочный сигнал, а не просто как запрос на инференс. Это концептуально созвучно человеческому прогрессу на работе: выполнение задач, получение фидбэка, интернализация рабочих методик. Инженерная сложность заключается в преобразовании разреженных, зашумленных и зачастую враждебных сигналов в стабильные обновления весов без катастрофического забывания. Однако модель, способная действительно учиться на основе развертывания, будет генерировать сложностный процент ценности способами, недоступными простым контекстным системам.
Data-centric approach: обучение на правильных сигналах. Смежная, но отличная ставка гласит: узкое место скрывается не в алгоритмах обучения, а в обучающих данных и сопутствующих системах. Эти группы сосредоточены на фильтрации, генерации или синтезе качественных данных для поддержания постоянного обновления: при условии, что модель получает высококачественные и структурированные обучающие сигналы, ей потребуется значительно меньшее количество градиентных шагов для существенного апгрейда. Это логично вытекает из подхода компаний, строящих контуры обратной связи, но акцентирует вопросы на раннем этапе: способность модели учиться — одно дело, а вот то, чему именно и до какой степени она должна учиться — другое.
Новые архитектуры: заложить способность к обучению на фундаменте. Самая радикальная ставка исходит из того, что сама архитектура Transformer выступает лимитирующим звеном, а непрерывное обучение требует качественно иных вычислительных примитивов — архитектур с динамикой непрерывного времени и встроенными механизмами памяти. Аргумент здесь структурный: если вам нужна система непрерывного обучения, необходимо внедрять механизмы самого обучения в основу инфраструктуры.
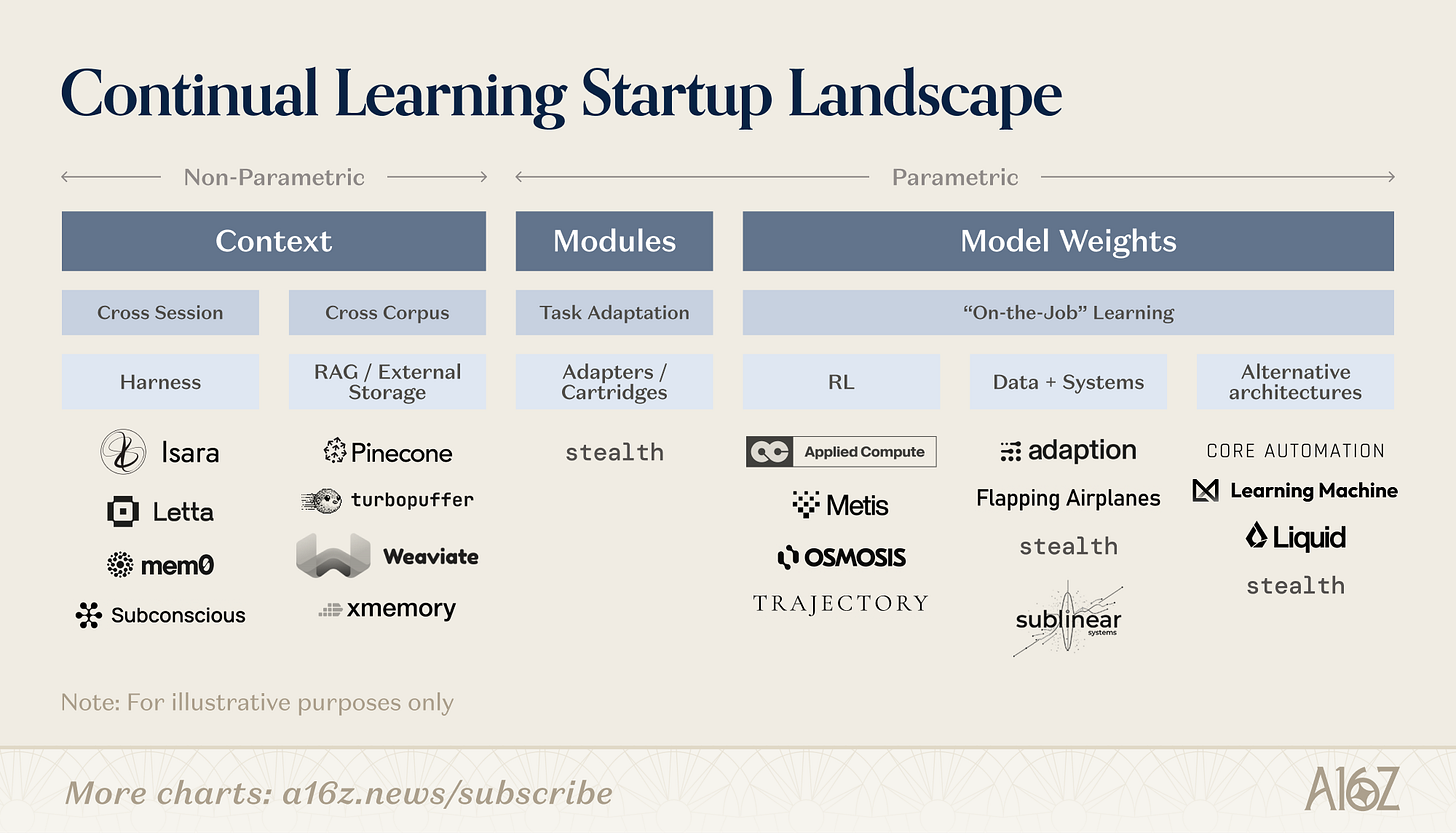
Примечание к рисунку: Карта стартапов в сфере непрерывного обучения
Ведущие лаборатории также активно расставляют силы в этих категориях. Одни исследуют усовершенствованный management контекста и рассуждения типа Chain-of-Thought, другие тестируют внешние memory-модули или ночные pipeline-ы вычислений, третьи — закрытые команды — идут к новым архитектурам. Направление еще довольно молодо, никто не одержал однозначной победы, и учитывая широту практического применения, вряд ли победит только один подход.
Почему наивное обновление весов терпит крах
Обновление параметров модели в продакшен-среде провоцирует ряд паттернов отказа, которые пока не решены в массовом масштабе.
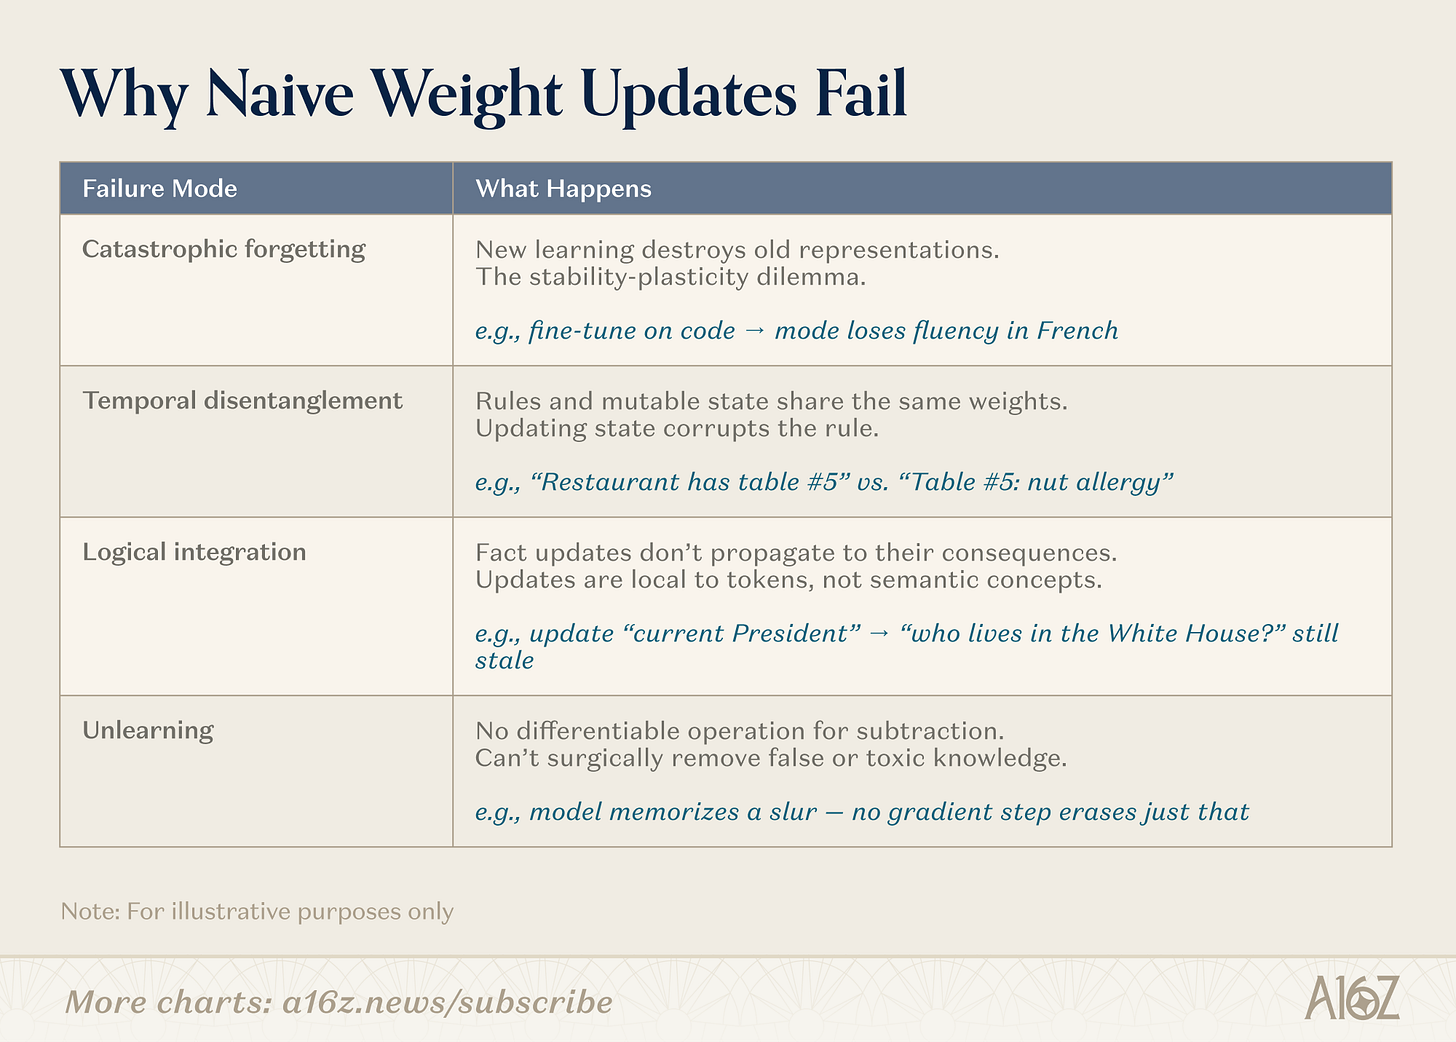
Примечание к рисунку: Паттерны сбоя при наивном обновлении весов
Инженерные проблемы подробно задокументированы. Катастрофическое забывание означает, что модель, чувствительная к новым данным для обучения, разрушает уже сформированные репрезентации — классическая дилемма стабильности и пластичности. Отсутствие временного разделения (temporal decoupling) возникает, когда неизменяемые правила и изменчивые состояния сжимаются в одни и те же веса, и обновление одного автоматически ломает другое. Сбой логической интеграции происходит из-за того, что обновление фактов не транслируется в их выводы: изменения заточены на уровне последовательностей токенов, а не семантических концепций. Процесс unlearning по-прежнему невозможен: не существует дифференцируемой операции вычитания, следовательно, ложные или вредоносные знания не подлежат точечному хирургическому удалению.
Меньше внимания уделяется второму классу проблем. Разделение процессов обучения и эксплуатации сегодня — не просто инженерный комфорт, это граница безопасности, аудируемости и корпоративного управления. Если нарушить эту границу, одновременно начнут валиться десятки аспектов. Безопасное alignment может непредсказуемо деградировать: даже узконаправленный fine-tuning на благаздательных данных способен породить глобальные дисбалансы. Постоянное создание обновлений формирует вектор атак через заражение данных (data poisoning) — медленно действующую, устойчивую форму инъекции промптов, которая буквально инкрустирована в веса. Аудируемость рушится, так как постоянно обновляемая модель становится «движущейся мишенью», неподвластной контролю версий, регрессионному тестированию или разовой сертификации. Когда пользовательские взаимодействия сжимаются в параметры, риски приватности возрастают: конфиденциальные данные запекаются в репрезентации, фильтруя их куда сложнее, чем просто выцепляемую из контекста информацию.
Это открытые вопросы, а не фундаментальные ограничения. Их решение равнозначно решению главных архитектурных задач и входит в повестку исследований непрерывного обучения.
От «Помнить» к настоящим воспоминаниям
Трагедия Леонарда в «Помнить» заключается не в невозможности функционировать — в любой ситуации он проявляет смекалку, порой блестящую. Его беда в том, что он никогда не сможет накапливать сложностный процент опыта. Каждый новый опыт остается снаружи: мгновенный снимок, татуировка, чья-то заметка другим почерком. Он умеет искать, но не способен сжимать новые знания.
Передвигаясь по лабиринту, который он сам же и построил, границы между реальностью и убеждением начинают стираться. Его недуг лишает не только памяти;он вынужден непрерывно реконструировать смысл, превращая его одновременно в детектива и ненадежного рассказчика собственной истории.
Современный ИИ функционирует под теми же ограничениями. Мы возвели очень мощные системы поиска: увеличенные контекстные окна, умные оболочки, скоординированные группы агентов — и они работают. Но поиск не тождественен обучению. Система, способная извлечь любой факт, не обязана искать структуру. Она не вынуждена к обобщению. Тот самый механизм сжатия с потерями, делавший предобучение столь эффективным (превращение сырых данных в переносимые репрезентации) — это именно то, что мы отключаем в момент развертывания.
Путь вперед, вероятно, лежит не через единичный прорыв, а через многоуровневую систему. Контекстное обучение останется первым рубежом адаптации: оно нативно, проверено и постоянно улучшается. Модульные подходы займут среднее поле персонализации и предметной специализации. Но для по-настоящему сложных задач — научных открытий, кибергигиенической адаптации, неявного знания, не выражаемого словами — нам, возможно, придется позволить модели продолжать сжимать опыт в параметры после окончания предобучения. Это потребует прогресса в разреженных архитектурах, целях метаобучения и циклах рекурсивного самосовершенствования. Возможно, нам также придется переосмыслить само понятие «модели»: не как застывшего набора весов, а как эволюционирующей системы, possessing собственную память, алгоритмы обновления и способность абстрагироваться из личного опыта.
Архивы становятся все больше. Но сколь бы велик он ни был, архив — это все еще архив. Ключ к прорыву — заставить модель после развертывания заниматься тем же, что делало ее сильной при обучении: сжимать, абстрагировать, учиться. Мы стоим на пороге перехода от моделей с амнезией к системам, обладающим искрой житейского опыта. Иначе мы навсегда останемся заперты в собственном «Помнить».
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 a16z














