Расследование DeepSeek: почему DeepSeek предпочитает молодых людей без опыта работы?
Автор: Сэм Гао, Автор ElizaOS
0. Предисловие
В последнее время последовательные появления DeepSeek V3 и R1 заставили американских исследователей ИИ, предпринимателей и инвесторов испытывать FOMO. Этот праздник можно сравнить с удивлением, вызванным появлением ChatGPT в конце 2022 года.
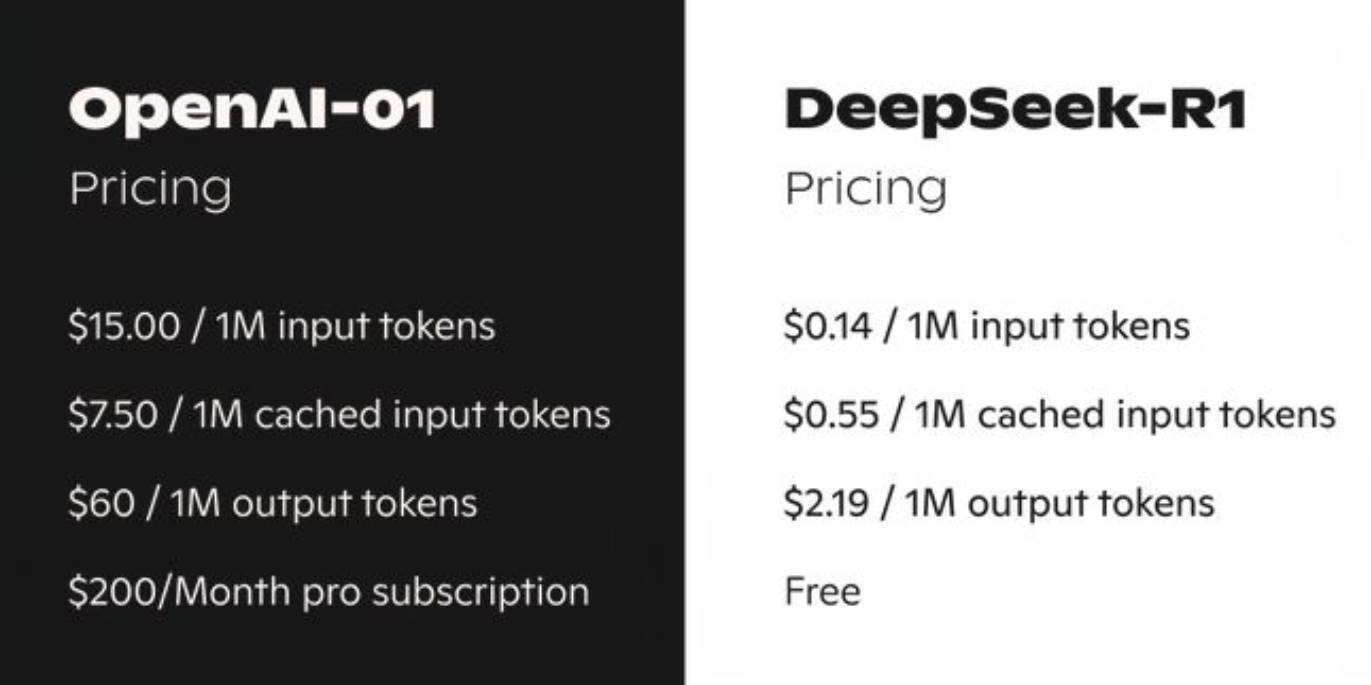
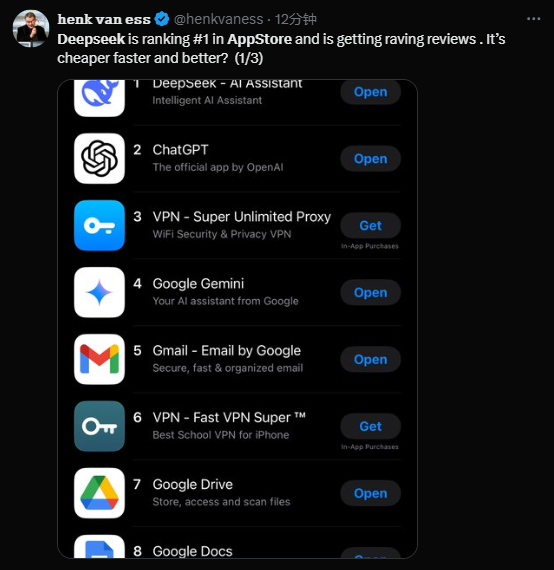
Благодаря полному открытию исходного кода DeepSeek R1 (модель можно бесплатно загрузить на HuggingFace для локального инференса) и чрезвычайно низкой цене (1/100 от цены OpenAI o1), DeepSeek всего за 5 дней заняла первое место в американском Apple AppStore.
Итак, откуда же взялась эта таинственная новая сила в области ИИ, инкубированная китайской квантовой компанией?
1. Происхождение DeepSeek
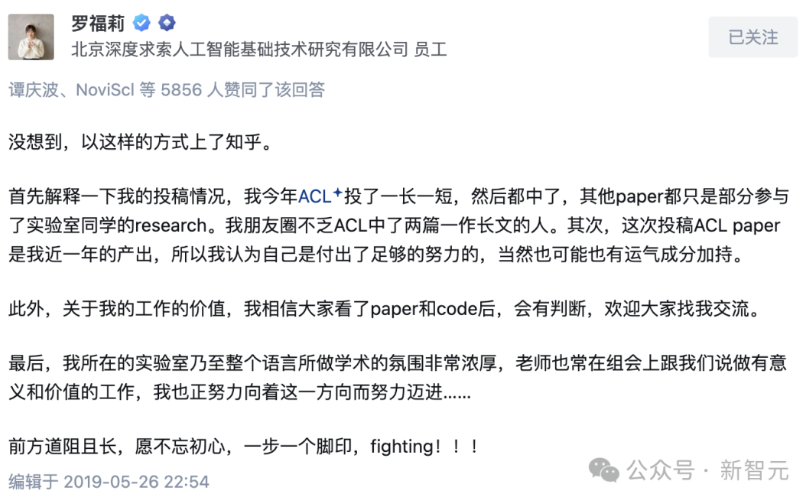
Впервые я услышал о DeepSeek еще в 2021 году. Тогда, работая в DAMO Academy, гениальная девушка из соседней группы, магистр Пекинского университета Ло Фули, опубликовавшая 8 статей на ACL (топовая конференция по обработке естественного языка) за год, уволилась и присоединилась к High-Flyer Quant. Тогда всем было очень интересно, зачем прибыльной квантовой компании нанимать таланты из области ИИ: неужели High-Flyer тоже нужно публиковать статьи?
Насколько мне известно, тогда исследователи ИИ, нанятые High-Flyer,大多 действовали независимо, исследуя некоторые передовые направления, среди которых наиболее核心ными были большие модели (LLM) и модели текст-в-изображение (тогдашний OpenAI Dall-e).
Время быстро пролетело до конца 2022 года. High-Flyer постепенно начала吸纳 все больше топовых талантов в области ИИ (в основном студенты Цинхуа и Пекинского университета). Под стимулом ChatGPT, CEO High-Flyer Лян Вэньфэн, накопивший многолетний опыт в области ИИ, твердо решил войти в сферу общего искусственного интеллекта: «Мы создали новую компанию, начиная с больших языковых моделей, затем будут и визуальные и другие».
Да, этой компанией является DeepSeek. В начале 2023 года, когда «шесть маленьких драконов», представленные Zhipu, Moonshot AI, Baichuan Intelligence и другими, постепенно вышли в центр сцены, в шумном и процветающем пространстве между Чжунгуаньцунь и Удадкоу, присутствие DeepSeek во многом было затмено «вниманием» (Attention), которое получили эти компании, пораженные горячими деньгами.
Поэтому в 2023 году, как纯 исследовательскому институту без звездного основателя (как 01.AI Ли Кайфу, Moonshot AI Ян Чжилиня, Baichuan Intelligence Ван Сяочуаня и др.), DeepSeek было трудно независимо привлечь финансирование с рынка. Поэтому High-Flyer решила выделить DeepSeek и полностью финансировать ее разработку. В 2023 году, в эту эпоху бума, ни одна венчурная инвестиционная компания не хотела предоставлять средства DeepSeek: во-первых, внутри DeepSeek были в основном刚刚 выпустившиеся PhD, без очень известных топовых исследователей, во-вторых, выход капитала был отложен на неопределенный срок.
В среде, полной шума и суеты, DeepSeek начала писать свои истории в исследовании ИИ:
-
Ноябрь 2023 年, DeepSeek выпустила DeepSeek LLM с多达 67 миллиардами параметров, производительность которой близка к GPT-4.
-
Май 2024 年, DeepSeek-V2 официально запущена.
-
Декабрь 2024 年, выпущена DeepSeek-V3, бенчмарки показали, что она превосходит Llama 3.1 и Qwen 2.5, одновременно сопоставима с GPT-4o и Claude 3.5 Sonnet, что вызвало взрыв внимания в индустрии.
-
Январь 2025 年, выпущена первая большая модель с возможностями рассуждения DeepSeek-R1, с ценой менее 1/100 от OpenAI o1 и превосходной производительностью, заставившая весь мировой технологический圈 содрогнуться: мир действительно осознал, что китайская сила действительно пришла... Открытый исходный код всегда побеждает!
2. Стратегия работы с талантами
Я рано познакомился с некоторыми исследователями DeepSeek, в основном занимающимися направлением AIGC, например, авторами Janus, выпущенного в ноябре 2024 年, и авторами DreamCraft3D, среди которых был один, помогший мне оптимизировать последнюю статью @xingchaoliu.
По моим наблюдениям, исследователи, которых я знаю, в основном очень молодые, в основном аспиранты или выпустившиеся менее 3 лет назад.
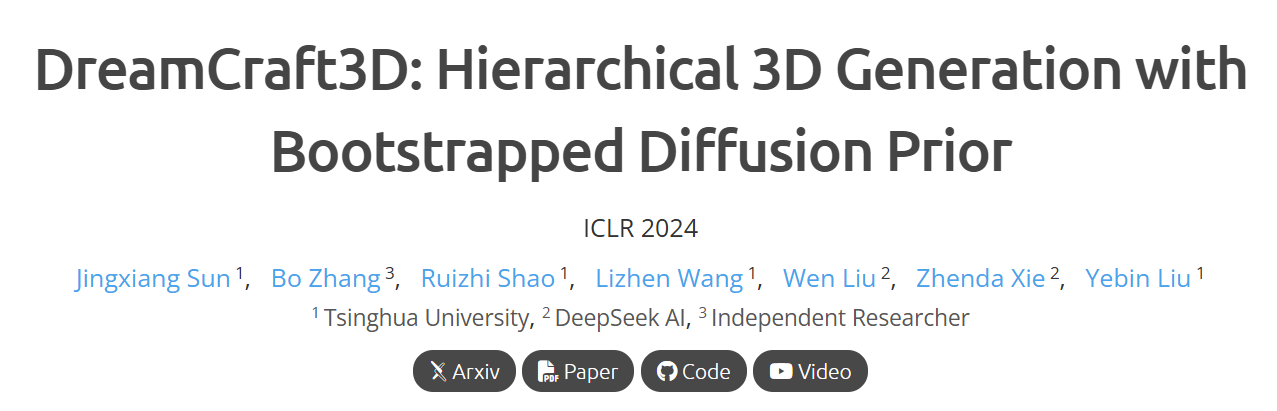
При этом большинство из них — студенты магистратуры или аспирантуры в районе Пекина, имеющие сильные академические достижения: в основном исследователи, опубликовавшие 3-5 статей на топовых конференциях.
Я спросил друзей из DeepSeek, почему Лян Вэньфэн нанимает только молодых людей?
Они передали мне слова CEO High-Flyer Лян Вэньфэна, его оригинальные слова следующие:
Завеса тайны над командой DeepSeek заставляет людей интересоваться: в чем ее секретное оружие? Зарубежные СМИ говорят, что этим секретным оружием являются «молодые гении», которые足以 конкурировать с финансово мощными американскими гигантами.
В индустрии ИИ нормой является наем опытных ветеранов, многие китайские локальные стартапы в области ИИ предпочитают нанимать старших исследователей или таланты с зарубежными докторскими степенями. Однако DeepSeek действует наоборот, предпочитая молодых людей без опыта работы.
Хедхантер, работавший с DeepSeek,透露, что DeepSeek не нанимает старших технических специалистов, «опыт работы в 3-5 лет уже является максимумом, тех, у кого более 8 лет, в основном отсеивают». Лян Вэньфэн в интервью 36Kr в мае 2023 年 также заявил, что большинство разработчиков DeepSeek — это либо刚刚 выпустившиеся студенты, либо люди, только начинающие карьеру в искусственном интеллекте. Он подчеркнул: «Наши ключевые технические позиции в основном занимают刚刚 выпустившиеся студенты или люди с одним-двумя годами опыта работы».
Без опыта работы, как DeepSeek выбирает людей? Ответ: смотрят на потенциал.
Лян Вэньфэн однажды сказал, что для дела долгосрочного опыт на самом деле не так важен, по сравнению с этим базовые способности, креативность и страсть важнее. Он считает, что возможно сейчас топ-50 лучших талантов в области ИИ в мире еще не в Китае, «но мы можем создать таких людей сами».
Эта стратегия напомнила мне раннюю стратегию OpenAI. Когда OpenAI была основана в конце 2015 年,核心思路 Сэма Альтмана заключалась в поиске молодых амбициозных исследователей, поэтому, кроме президента Грега Брокмана и главного ученого Ильи Суцкевера, остальные четыре核心 технических члена-основателя (Андрей Карпати, Дурк Кингма, Джон Шульман, Войцех Заремба) были刚刚 выпустившимися докторами наук, окончившими соответственно Стэнфордский университет, Амстердамский университет, Калифорнийский университет в Беркли и Нью-Йоркский университет.
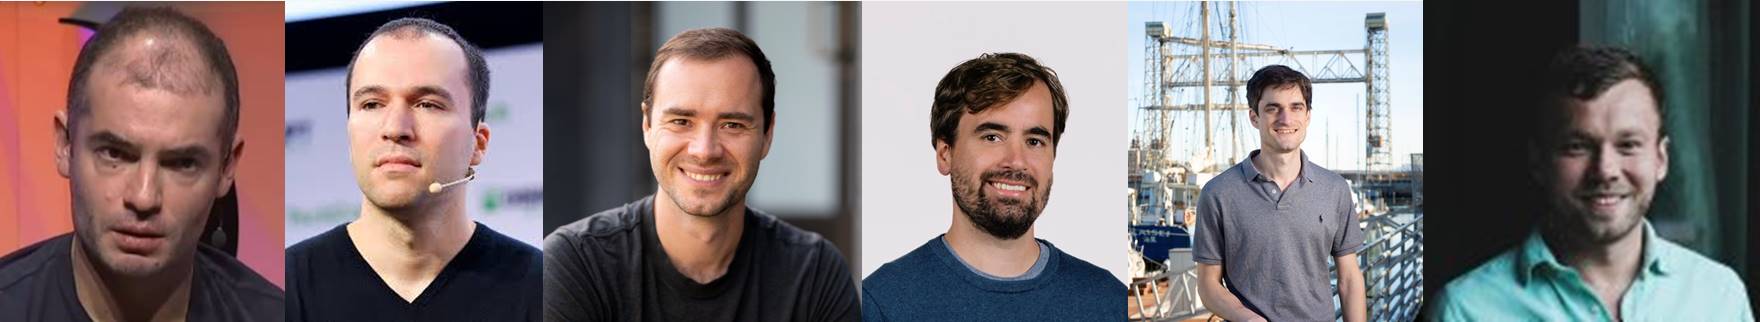
Слева направо: Илья Суцкевер (бывший главный ученый), Грег Брокман (бывший президент), Андрей Карпати (бывший технический руководитель), Дурк Кингма (бывший исследователь), Джон Шульман (бывший руководитель команды обучения с подкреплением) и Войцех Заремба (нынешний технический руководитель)
Эта «стратегия волчат» уже позволила OpenAI вкусить сладости, инкубировав таких, как отец GPT Алек Рэдфорд (эквивалентно выпускнику вуза третьего эшелона), отец модели текст-в-изображение DALL-E Адитья Рамеш (бакалавр NYU), а также руководитель мультимодальности GPT-4o, трехкратный золотой медалист олимпиад Прафулла Дхаривал и др. Позволив OpenAI, чей план спасения мира в начале создания был неясен, в хаотичном натиске молодых людей пробить путь к жизни, превратившись из безвестного рядом с DeepMind в гиганта.
Лян Вэньфэн именно увидел эту успешную стратегию Сэма Альтмана, поэтому твердо выбрал этот путь, однако, в отличие от OpenAI, которая ждала 7 лет, чтобы увидеть ChatGPT. Инвестиции Лян Вэньфэна дали результаты через чуть более 2 лет, что можно назвать китайской скоростью.
3. В защиту DeepSeek
В статье о DeepSeek R1 ее различные показатели удивительно отличны. Но это также вызвало сомнения у всех: есть два сомнительных момента,
-
① Используемая ею технология смеси экспертов (MoE) требует высоких требований к обучению и данным, что показывает, что сомнения всех в том, что Deepseek использует данные OpenAI для обучения, обоснованы.
-
② Deepseek использует технологию обучения с подкреплением (RL), которая требует очень высоких требований к оборудованию, но по сравнению с кластерами из десятков тысяч карт Meta и OpenAI, обучение Deepseek использовало только 2048 карт H800.
Из-за ограничений вычислительной мощности и сложности MoE, успешная с первого раза DeepSeek R1, стоившая всего 5 миллионов долларов, выглядит несколько подозрительно, однако, независимо от вашего отношения к R1 — боготворите ли вы ее «чудо низкой стоимости» или подвергаете сомнению ее «показушность», нельзя игнорировать ослепительность ее функциональных инноваций.
Сооснователь BitMEX Артур Хейс заявил: Приведет ли восхождение DeepSeek к тому, что глобальные инвесторы усомнятся в американской исключительности? Не严重 ли завышена стоимость активов США?
Профессор Стэнфордского университета Эндрю Ын публично заявил на Давосском форуме в этом году: «Я впечатлен прогрессом DeepSeek. Я считаю, что они смогли обучить модели очень экономичным способом. Их последняя выпущенная модель рассуждения非常出色……«Удачи»!»
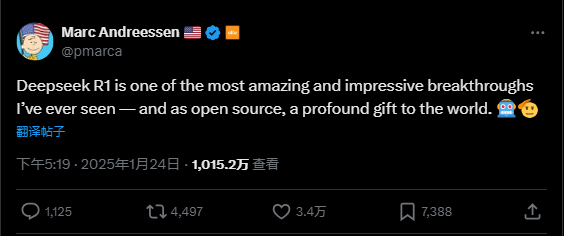
Основатель A16z, Марк Андриссензаявил: «Deepseek R1 — один из самых потрясающих и впечатляющих прорывов, которые я видел — и как открытый исходный код, это глубокий подарок миру».
DeepSeek, стоявшая в углу сцены в 2023 году, наконец в 2025 году, перед Китайским Новым годом, встала на вершину мирового ИИ.
4. Argo и DeepSeek
Как технический разработчик Argo и исследователь AIGC, я адаптировал важные функции в Argo под DeepSeek: как система workflow, грубый原始 workflow генерирует работу, Argo использует DeepSeek R1. Кроме того, Argo встроила LLM как стандартную DeepSeek R1 и选择了 отказаться от закрытых дорогих моделей OpenAI, причина в том, что система Workflow обычно содержит большое потребление токенов и контекстной информации (в среднем >=10k токенов), что приводит к тому, что если использовать дорогие OpenAI или Claude 3.5, стоимость выполнения Workflow очень дорога, прежде чем пользователи web3 получат реальное захват ценности, такие提前透支 расходы являются вредом для продукта.
По мере улучшения DeepSeek, Argo будет сотрудничать более тесно с китайскими силами, представленными DeepSeek: включая, но не ограничиваясь, китаизацию интерфейсов Text2Image/Video, китаизацию LLM.
Что касается сотрудничества, Argo в будущем пригласит исследователей DeepShare поделиться техническими результатами и предоставит гранты для топовых исследователей ИИ, предоставив помощь инвесторам и пользователям web3 в понимании прогресса ИИ.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News
 @samuel_ys92