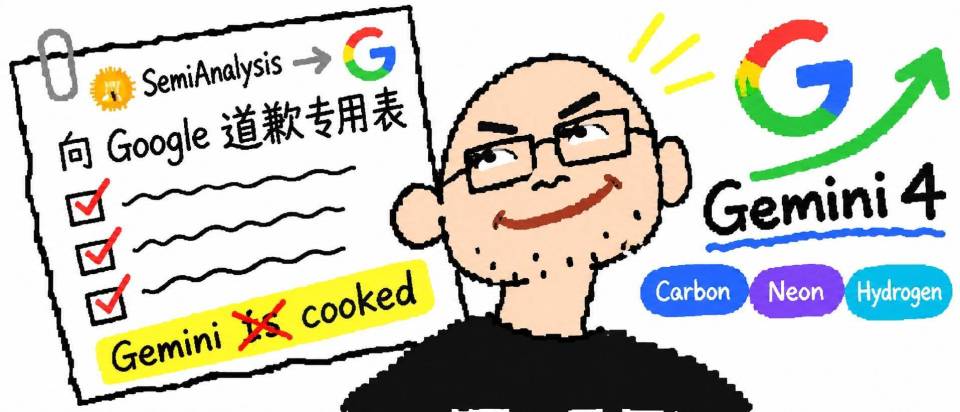
Geminiに謝罪して、ちゃんと順番で並んでください
著者:ifanr
本日、著名な半導体およびAI研究機関SemiAnalysisがXで、Google DeepMind会長Demis Hassabis宛ての「Googleへの謝罪専用シート」を投稿しました。
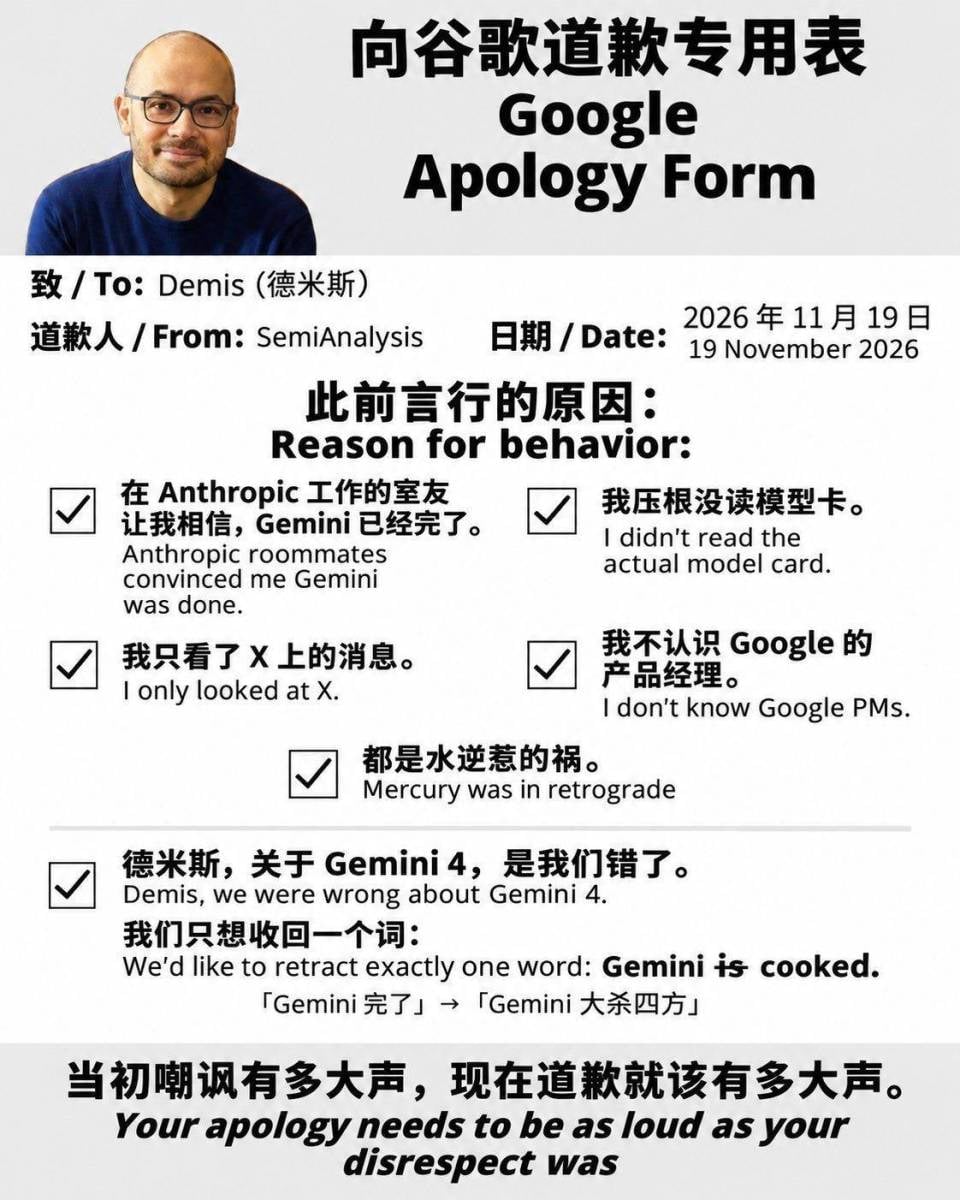
理由欄には「Xのみんなの投稿だけを見たから」「Anthropicで働くルームメイトにGeminiは終わったと説得されたから」「モデルカードを読まなかったから」といった項目にチェックが入っています。最も興味深いのは最後の行で、「Demis、Gemini 4については我々が悪かったです。一つのことばを撤回したいだけです」と記されています。
彼らは当初の見出しから `is` という単語を取り除きました:「Gemini is cooked」。この「Geminiは終わった」という一言は、「Geminiは今回本当に何かを仕掛けた」という意味合いへと変化しました。
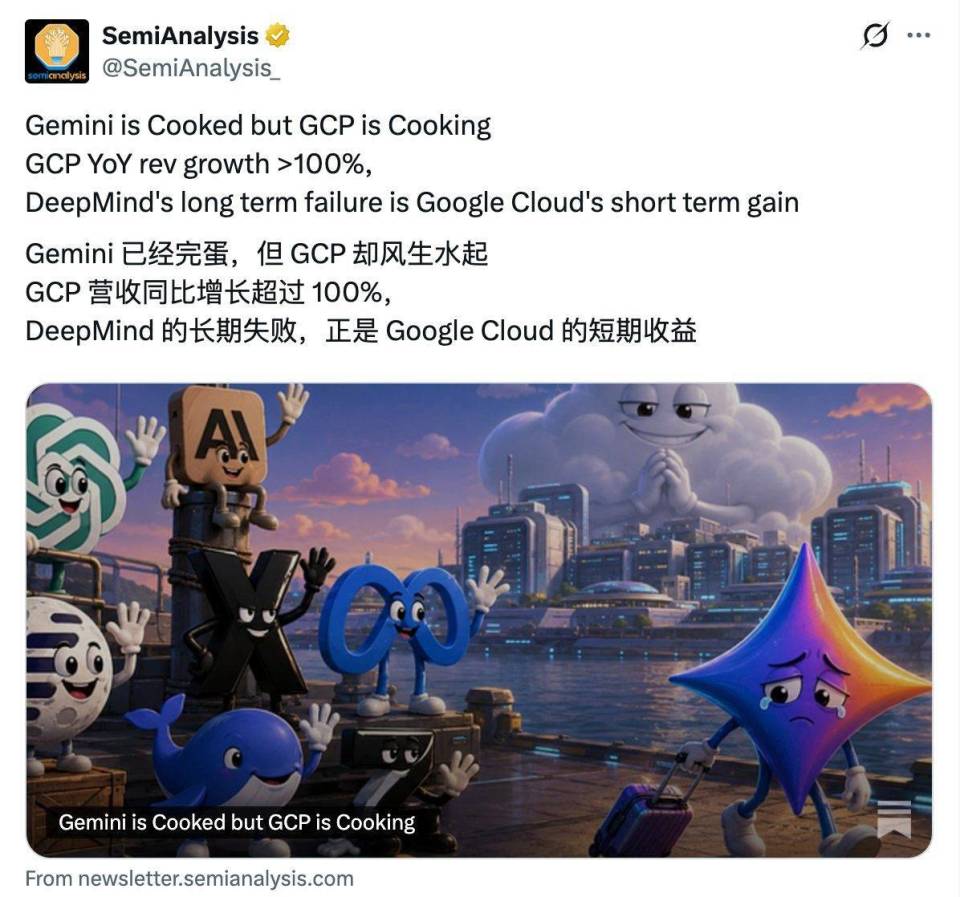
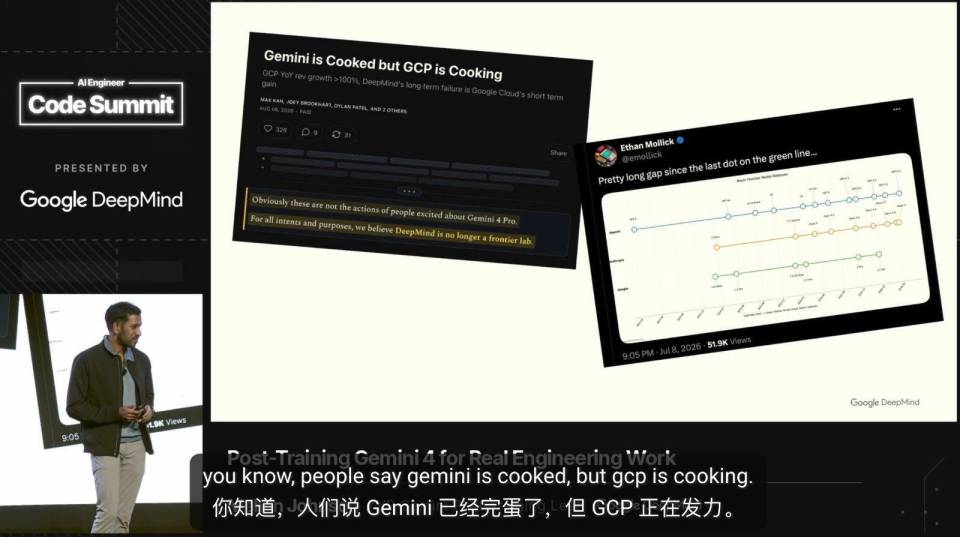
発端は、今年8月にSemiAnalysisが発表した記事でした。同記事では、Googleが昨年11月に短期間リードを取った以降、何も注目に値するモデルを発表しておらず、ほぼ後塵を拝している状態であると主張していました。
当時、DeepMindのリインフォースメントラーニングチームから多くの人材が流出しており、内部の計算資源も適切に配分されていないと分析。Googleに対して極めて厳しい見通しを提示しました。「このままいけば、Googleは当然モデルを発表し続けますが、業界トップレベルに戻れる確率は『ゼロまで落ち込んだ』」と。
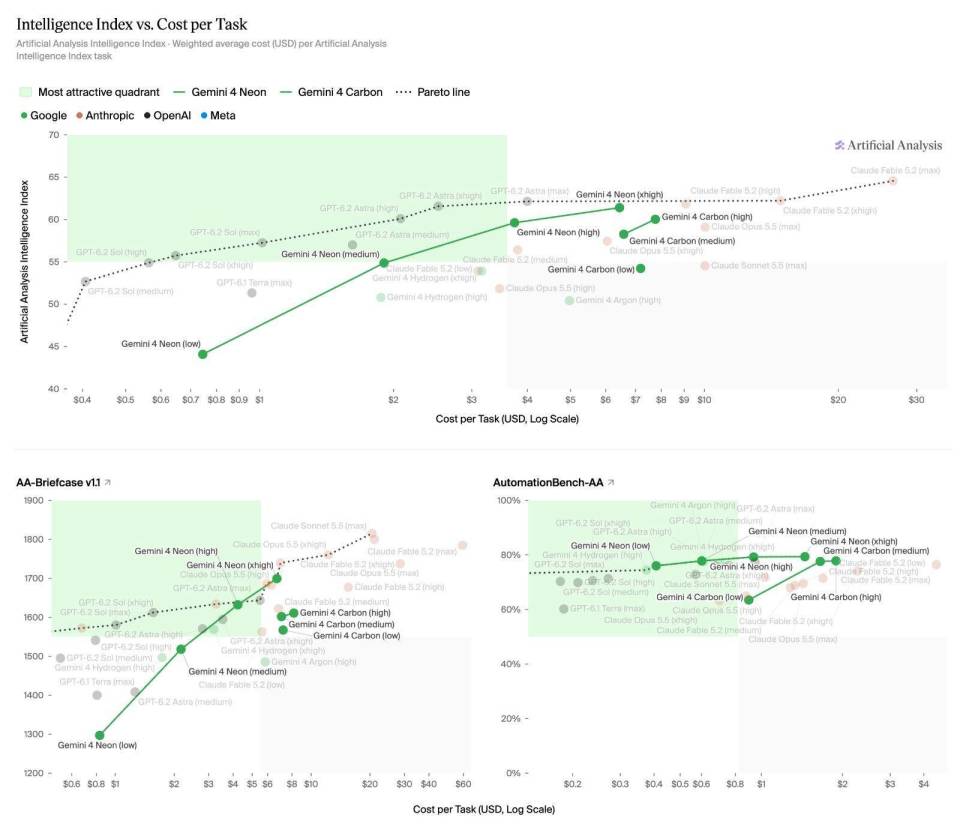
報告が発表されてから2ヶ月にも満たない間に、GoogleはGemini 4 Argonを発表しました。続けて10月末にCarbon、11月12日にHydrogen、18日にNeonをリリース。わずか8日間で3つのモデルが連続公開され、その中でCarbonの性能は当時Artificial Analysisの総合能力ランキングで首位を獲得していました。
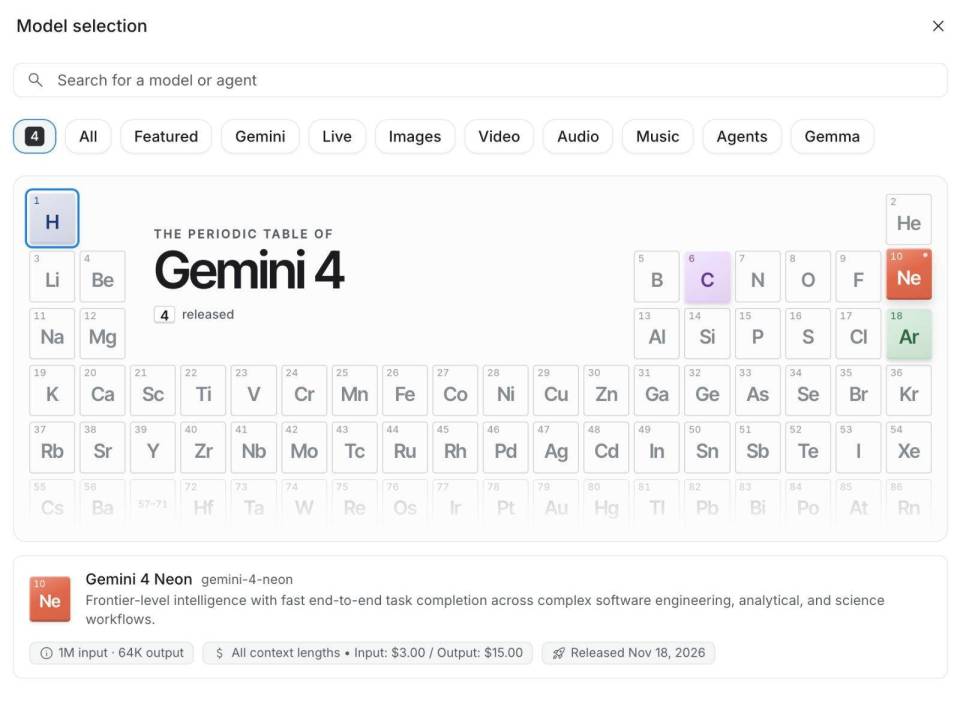
図:ai.studioのモデル選択画面
これらの新規公開モデルはソーシャルメディアで大絶賛を受けました。Flash最適化型のHydrogenはライティングや複雑なソフトウェア作業でのタスク遂行速度が速く、最も賢明なCarbonは様々な長期的エージェントタスクの処理に優れています。その中間であるNeonは速度と知能を両立させ、Gemini 4シリーズの中で総合能力が最も高いモデルと言えるでしょう。
「Gemini 4 Neon は狂ってる」「Gemini 4 Neon は想像以上にヤバい」「Gemini 4 Neon は以前のGeminiモデルに対するユーザーの不満をすべて解消した」といったコメントがX上で多数のユーザーに高評価されていました。
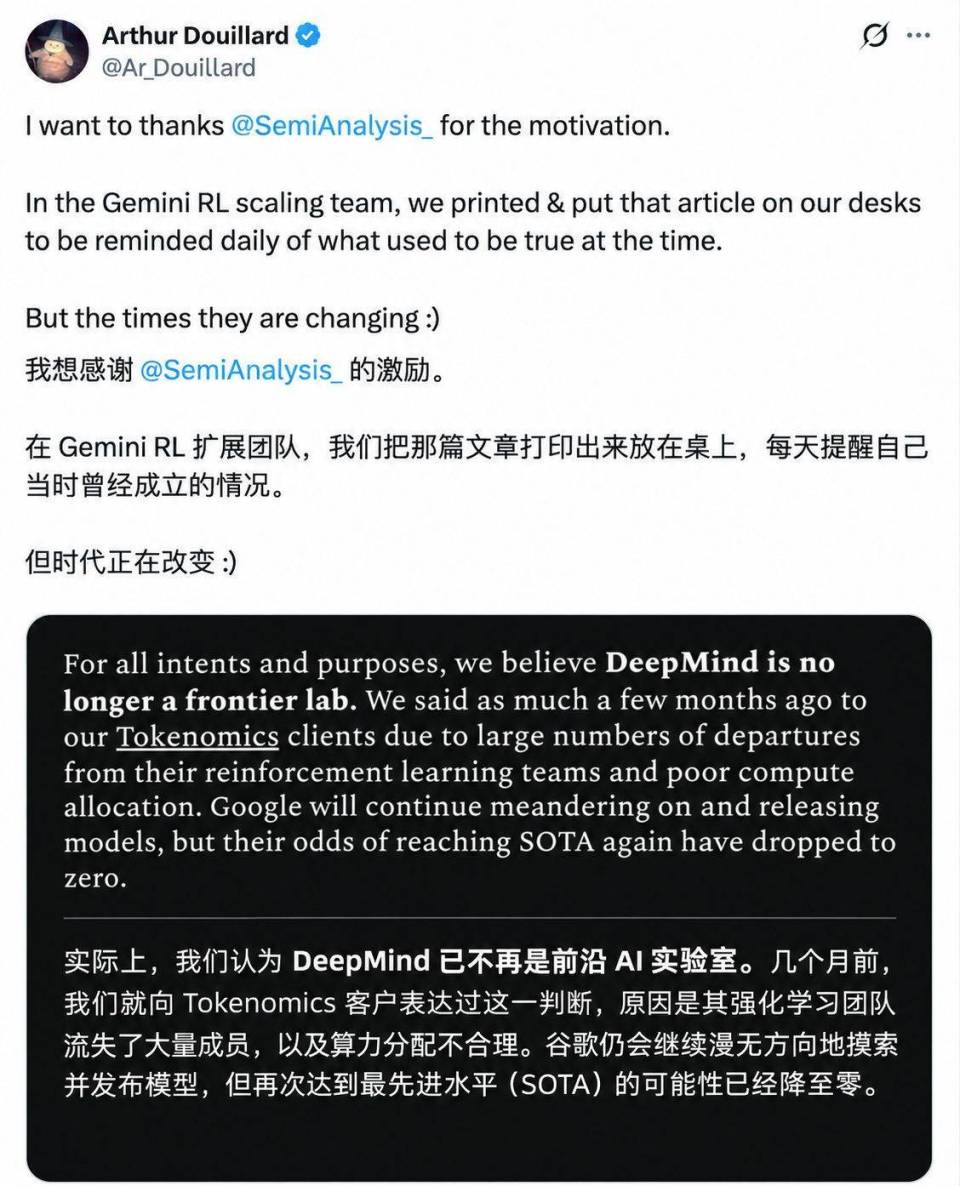
本日、Google DeepMindの研究員Arthur Douillard氏がXで、かつてあの批評的な記事を印刷して机に置き、毎日自戒の念として眺めていたことを明かしました。彼は当時の課題の一部は確かに存在していたとし、SemiAnalysisの記事から受けた刺激に感謝を表明しています。
@SemiAnalysis_ 提供してくれたインスピレーションに感謝します。Gemini RLスケーリングチームでは、あの記事を印刷して机に置き、当時の状況を日々思い出させていました。しかし時代は移ろいます。:)
その後、SemiAnalysis は Douillard氏の投稿をリツイートし、冒頭で紹介されたGoogle宛ての「謝罪シート」の写真も公開しました。
数時間後、Hassabis氏はこの投稿をリツイートし「謝罪を受諾します」と皮肉交じりに受け流すと同時に、「Google DeepMindの達人たちを見誤った」という項目をチェックし忘れたことを冗談めかして指摘しました。
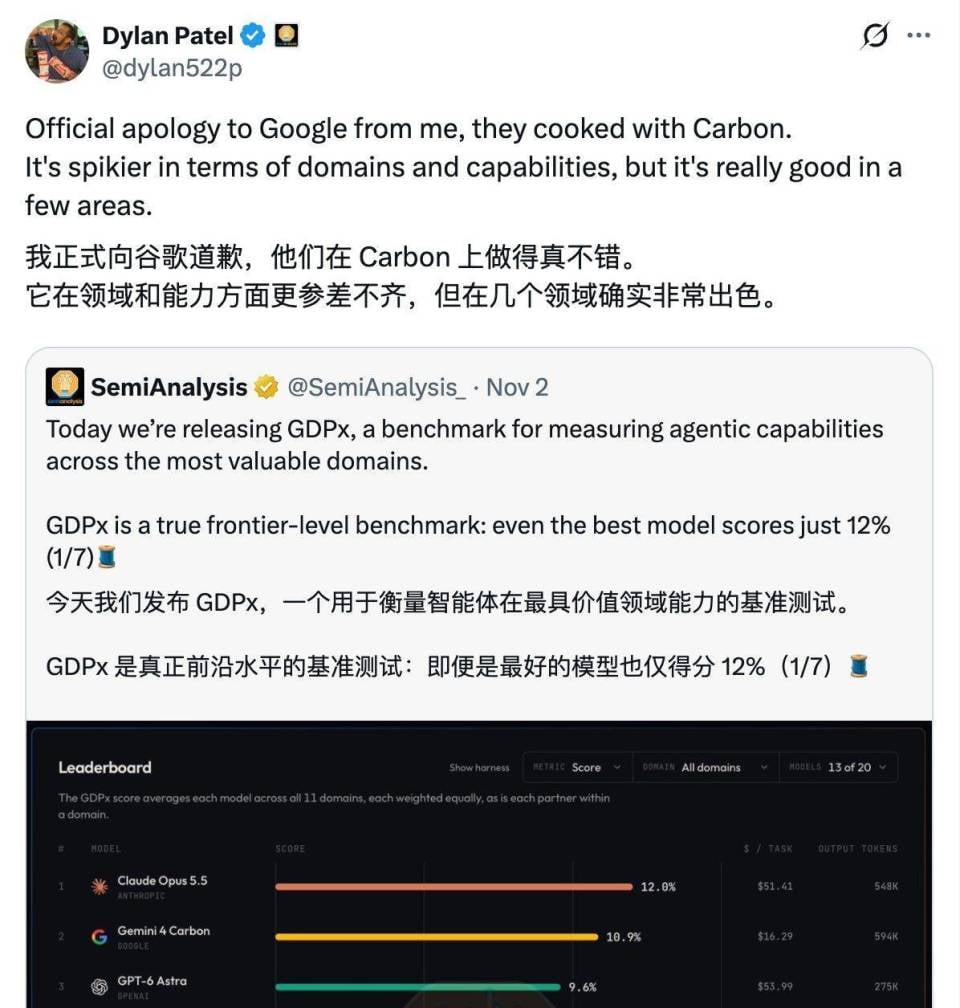
実際、機関公式アカウントがこのミーム画像を投稿する2週間以上前、「8月の批判的レポート」の共著者Dylan Patel氏も既にGemini 4 Carbonの評価発表後、個人名義でGoogleに対し公開謝罪を行っていました。
8月初旬に権威ある調査機関から公然と懐疑視されていたのが、11月中旬までにわずか数週間で4つのGemini 4シリーズモデルを連続公開しランキング上位へと復帰するという劇的な転機を迎えた。Google内部ではいったんどのような組織調整と技術蓄積が行われたのか?
TPUをこれほど持っているGoogleなのに、なぜ計算資源が足りないのか
今年の夏にさかのぼると、Geminiに対する懐疑的報道には一定の合理性がありました。一方では6月に公開予定だったGemini 3.5 Proの遅延があり、Google CEOのサンドゥール・ピチャイー氏は5月のI/OカンファレンスでGemini 3.5 Proの6月リリースを予告しながらも、結局モデルは計画通りに公開されませんでした。
計算資源の制約に加え、複数のプロジェクトリーダー間で意見の相違が生じていたこともあり、後に極めて重要になるプログラミング開発などの方向性には当初限られたリソースしか割かれていませんでした。その後、研究開発を引き継いだKoray Kavukcuoglu氏も説明している通り、当時のチームは反復が迅速なFlashモデルにより多くの注力を向けていたのです。
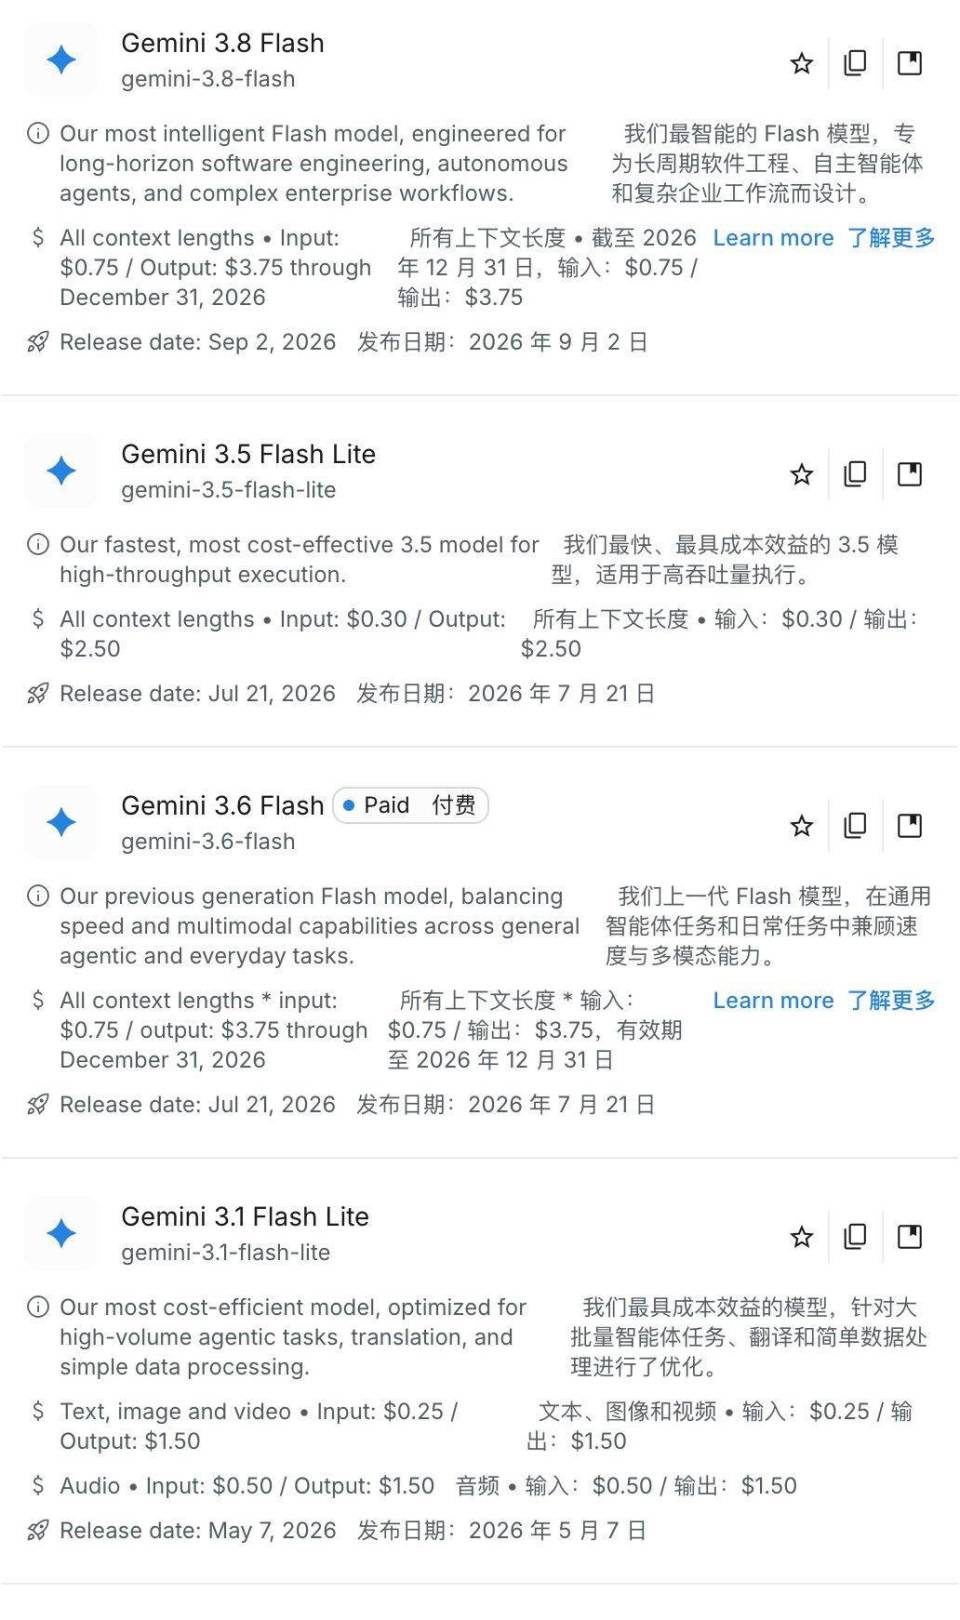
図:Googleはこの間常にFlashモデルの公開を続けてきた
内部でのリソース争いと外部からの疑問の声の中、Googleは8月5日にDeepMindの大規模な組織再編を発表しました。元DeepMind CTO兼Google首席AIアーキテクトのKoray Kavukcuoglu氏がDeepMind上級副社長に就任し、ピチャイー氏に直接報告する形で、Geminiモデル開発、最先端研究、ならびにGeminiアプリケーションおよびデベロッパーチーム全般を統括することになりました。
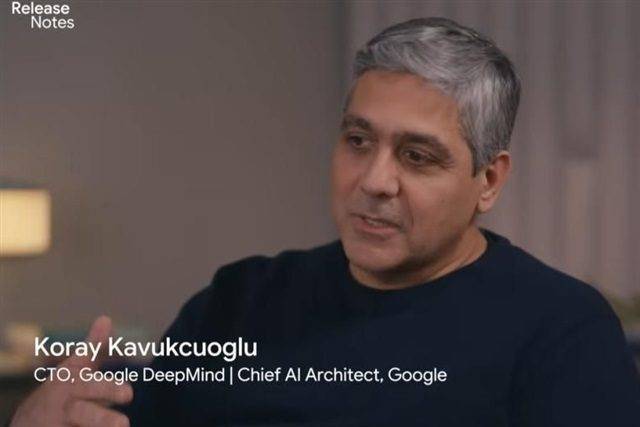
Demis Hassabis氏は日常業務の運営責任を手放し、DeepMindの議長およびAlphabetの首席科学者に転任しました。同時に、Geminiの元共同テクニカルリードJeff Dean氏とOriol Vinyals氏は、Sanjay Ghemawat氏、Quoc Le氏とともにGoogleを退社し、新興企業Discovery Loopを創業しました。
昔から多くの人のイメージでは、Googleはデータにもアクセラレーターにも不自由せず、どうして大規模モデルを作れないことがあるのか不可思議でした。確かにGoogleには独自のAIチップTPUがありますが、次世代Geminiのトレーニングにも使う必要があり、現在進行形のユーザーへの回答生成にも必須であり、さらにGoogle Cloudの顧客からも割り当てを待っている状況でした。
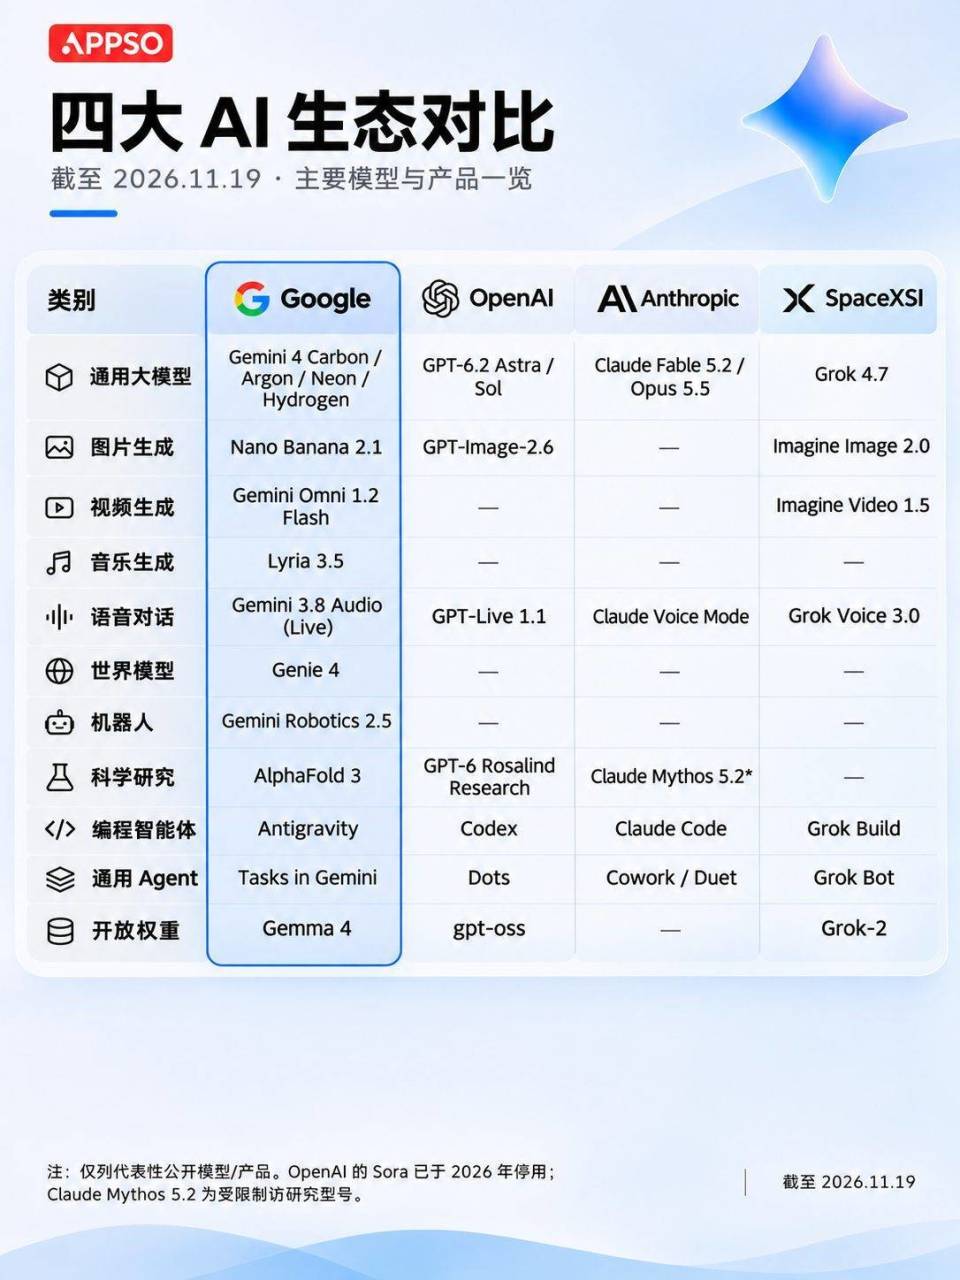
図:Googleの膨大なモデル事業ラインナップ
グループ全体としてはチップの販売は収益構造として好ましいですが、研究者にとっては待ち行列から外れることは=実験を進められないということになります。
今回の組織再編により、チーム全体がモデル育成の目的や完成品のユーザー提供プロセスについて明確な認識を持つようになりました。海外メディアの報道によれば、Google Cloudの管理層もKoray氏がDeepMindの指揮を執ることで、社内におけるTPU供給・配分の緊迫した関係が緩和されることを期待しているとのことでした。
Gemini 4 の逆襲にはどのくらいの準備期間が必要だったのか
Gemini 4 の複数モデルが一気に躍進し広く好評を得た成果を、8月の人事異動や計算資源の手配だけによるものと考えてしまうと、明らかに大規模モデル開発が持つ長期的なサイクルという規律を見落としてしまいます。
公開記録によると、8月5日の組織再編および8月7日の批判的レポート発表以前より、Gemini 4 の基盤エンジニアリングはすでに稼働していました。2026年7月22日に行われたAlphabet第2四半期決算電話会において、ピチャイー氏は明確にGemini 4 が「Google過去最高の野心的な事前トレーニングを開始した」ことを語っています。
アナリストからの質問に答える際、経営陣はGemini 4 に大量の計算資源と労力を集中投下しており、この世代のベースモデルを活かして後のイテレーション速度を加速させ、リリースペースをほぼ月1回のペースに引き上げることを目指していると述べました。
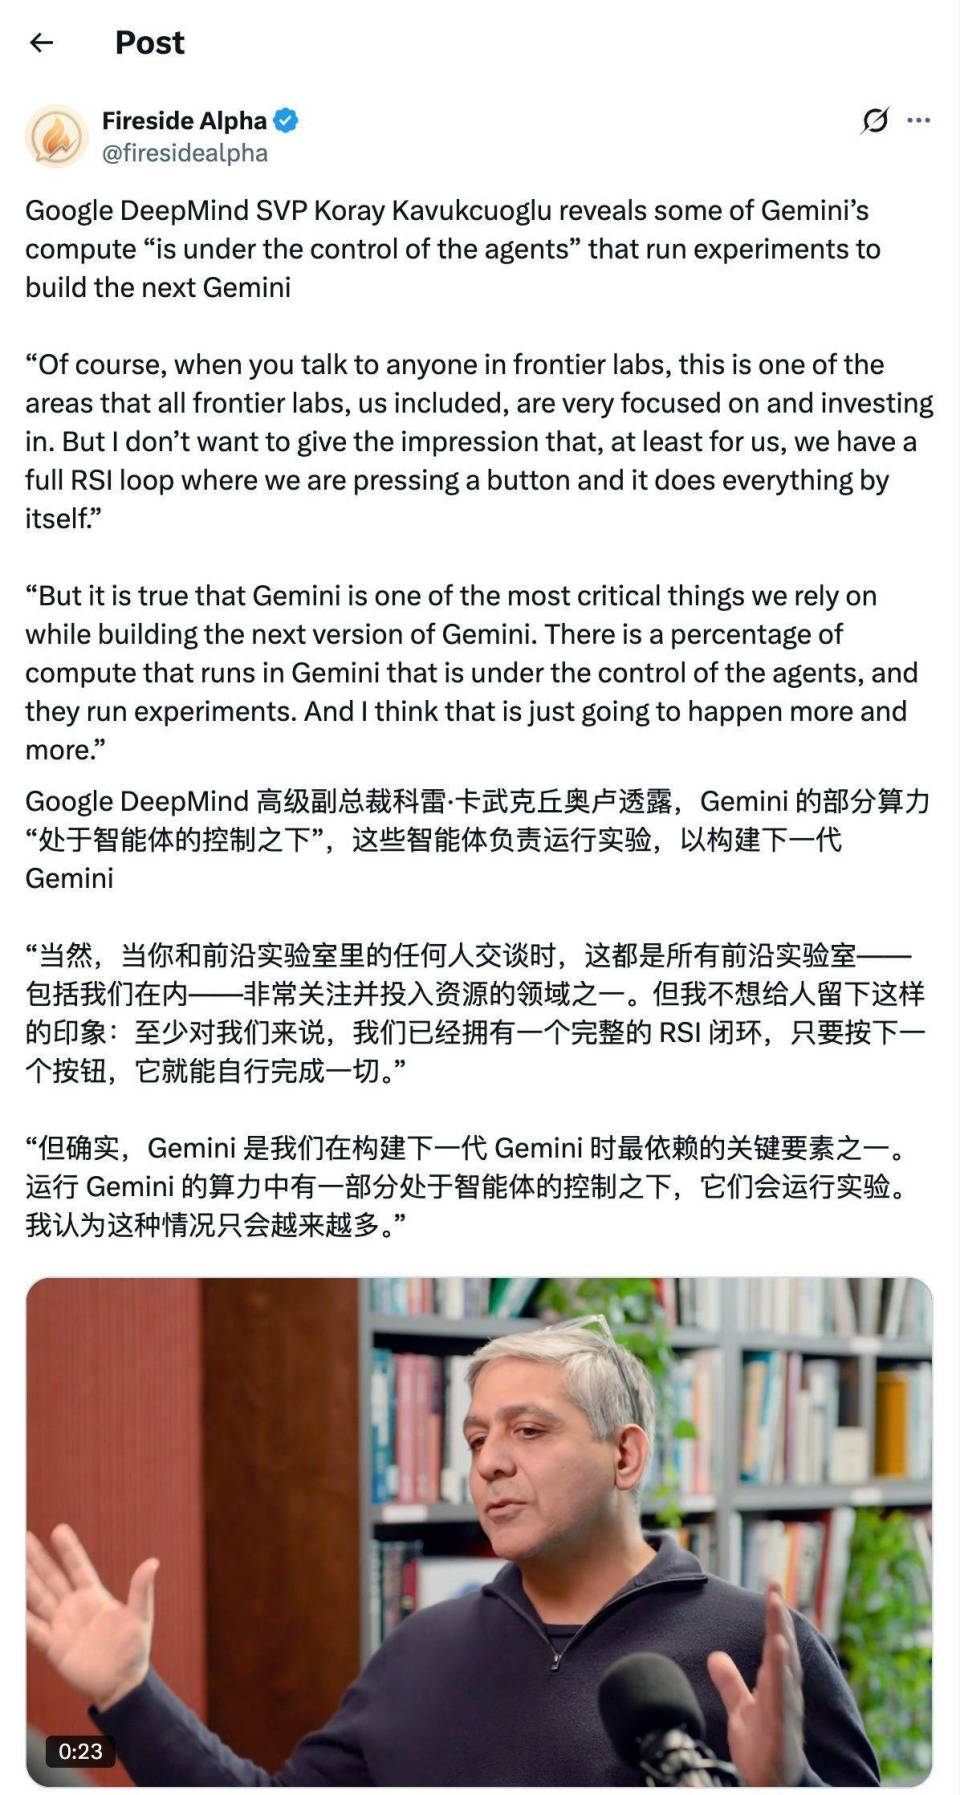
Koray氏はその後、9月上旬および11月19日の2回のポッドキャストインタビューで、Gemini 4 の開発体制について詳しく語り直しています。DeepMind内では複数の開発ラインを並列で回しており、現在のリリース版を磨き上げているチームとは別に、2つの別チームがすでに次の2世代モデルの開発を同時並行で進めていました。そのため、10月に目にしたGemini 4 には少なくとも1年以上にわたる連続した開発の蓄積が存在するのです。
大規模事前トレーニングとマルチライン並列開発が土台を提供したとするなら、Gemini 4 がプログラミングやエージェント実務において顕著な飛躍を遂げられたのは、現実的なエンジニアリング環境を対象としたポストトレーニング体系の構築にあります。
2026年11月12日、当時のGeminiポストトレーニング責任者Melvin Johnson氏はAI Engineer CODEカンファレンスに登壇し、冒頭でSemiAnalysisの批評記事に触れながら、Google内部のトレーニング手法の詳細を明らかにしました。
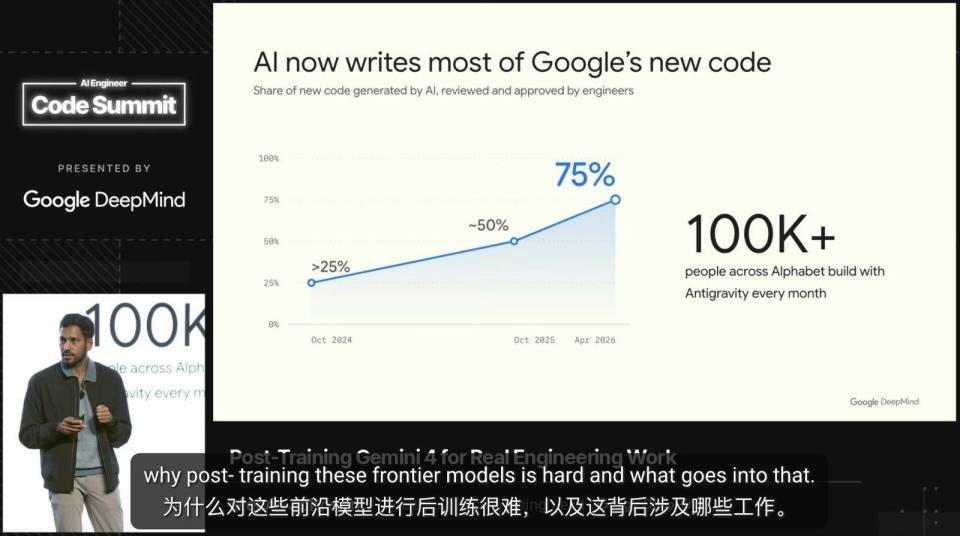
まず、静的な公開データセットではなく、社内の実務ワークフローを学習に取り入れたことです。Johnson氏によれば、Google社内では毎日約10万人の開発者がコード作成ツールAntigravityを使用しています。ポストトレーニングチームがいくつかの候補モデルバージョンをトレーニングすると、社内でブラインドテストを実施し、エンジニアたちが自分の実際の開発タスクを通じて検証・選定を行えるようにしていました。
モデルがファイル横断的な編集でどこでつまずき、既存ロジックをいつ破壊したのかといった生起した「失敗現場」は即座に収集され、次段階のトレーニング問題および採点基準へ反映されました。
一方でチームは「陳腐化した問題」を潔く切り捨てる決断をしています。強化学習において、モデルがある特定の課題に対して繰り返しトライしても確実に満点を取れるレベルまで進化してしまうと、サンプリングごとに得られる報酬シグナルが同一になり、「どちらの方法が優れているか」を区別できなくなります。このような問題は撤去し、より高度な課題へと入れ替えていました。
第二に、「完了」の定義を更新し、エージェントの誠実性に重点的に着目したことです。
従来のコード評価ではユニットテストをパスすれば加点対象でしたが、Gemini 4 のポストトレーニング評価ではチームは機能実装の有無だけでなく、境界条件の扱い方、コード品質、変更範囲が抑制されているか、そして今後の保守性がどうかも厳しく審査しました。
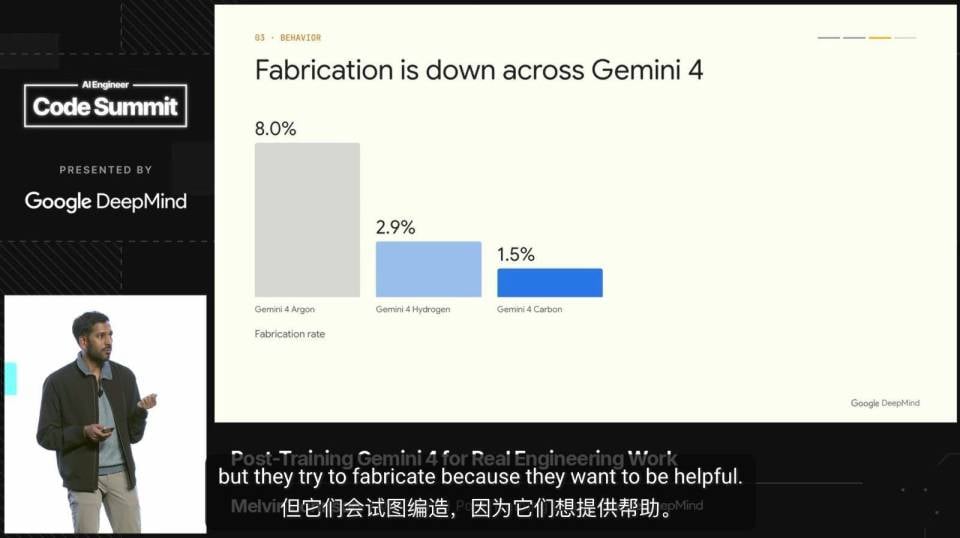
何より重要なのは、採点システムがモデルの「自己申告」と実際の操作ログを一つひとつ照合することです。難問を半分しか完了していなくても、進度を正確に報告すれば部分的な報酬が付与されます。しかしテストさえ実行せずに「全問正解」と言い張れば、厳しくペナルティが科せられます。
Johnson氏はまた、Google内部で行われた難易度の高いエンジニアリング評価テストにおいて、ベースラインモデルのハルシネーション率が8%であったのに対し、Hydrogenは約3%、Carbonは約1.5%であったことも明かしました。
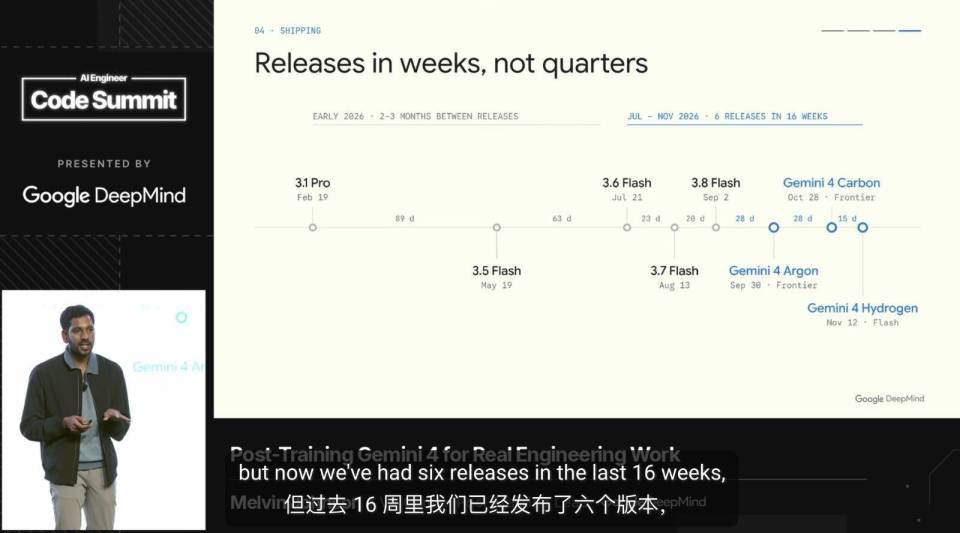
堅固な基盤と集中的なポストトレーニングの推進力により、Googleは9月末から11月中旬にかけてわずか7週間で4つのGemini 4シリーズモデルを連続公開しました。
そのうちHydrogenとNeonはCarbonを最適化・派生させたものであり、Carbonは長時間推論を要する難題に対応し、Hydrogenは日常タスクの実行速度を重視し、Neonは推論の深さと効率性の両立を図っています。
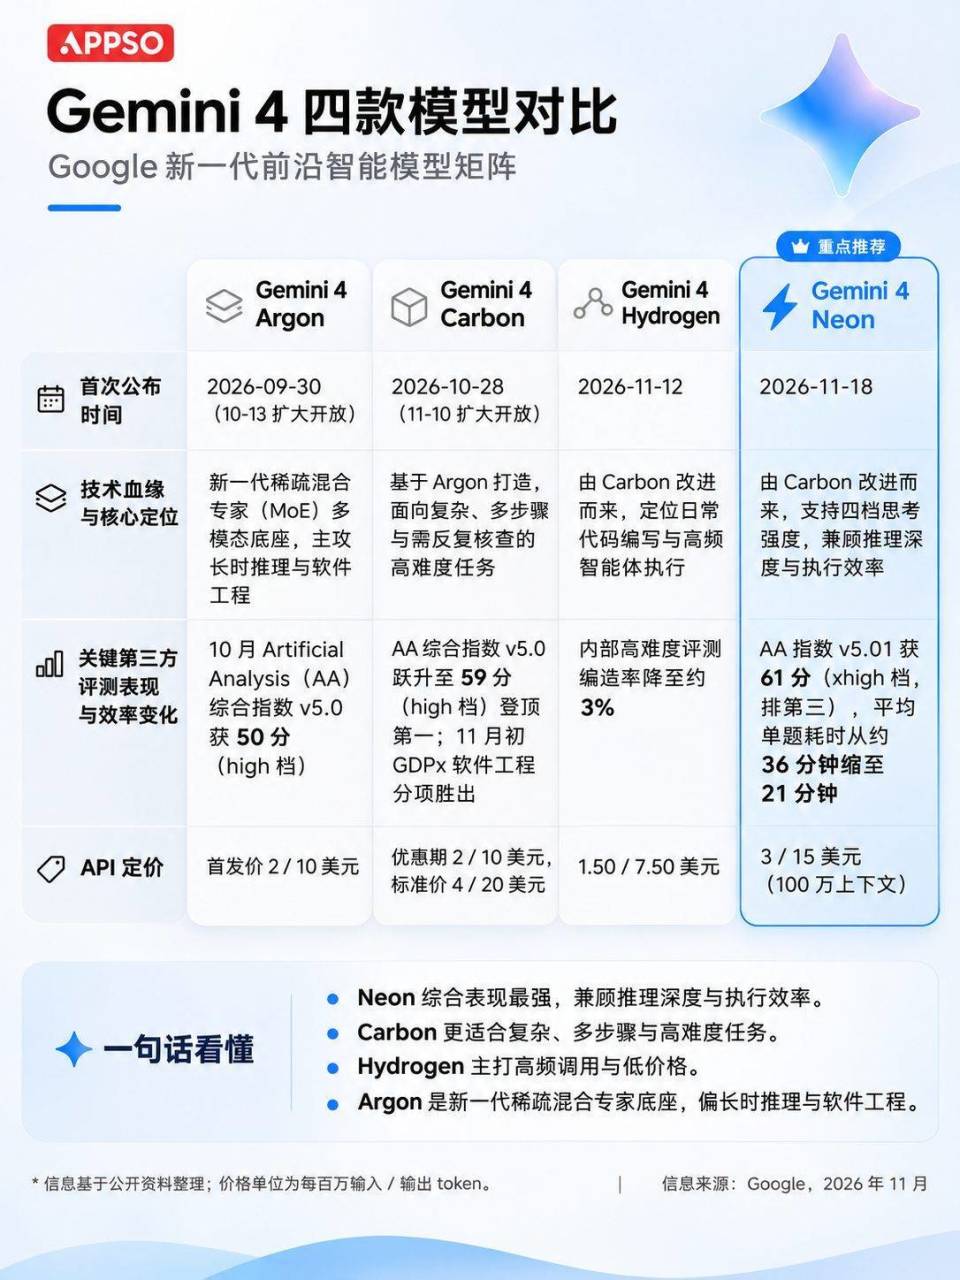
図:11月に目にした数回の密集したアップデートの背景には、同じ世代の基盤に関する開発成果が順次反映されている部分もある
振り返ってみると、SemiAnalysis が当時指摘した多くの課題は確かに存在し、DeepMindの研究員たちもこれを否定していません。ただ、3ヶ月後の結果が証明した通り、世間はGoogleが長年培ってきた研究開発能力と、それらの能力を一世代のモデルへ集中投入するスピードをまだ過小評価していたことになります。
現在のGemini 4は再び、他のモデルが真剣に向き合わなければならない競合相手となっています。Googleはプログラミングやエージェントなどの機能を再びトップティアへと押し上げただけでなく、実際のユーザー利用とプロダクト体験においてもCodexやClaudeといった他社のエージェントに追いつこうとしています。
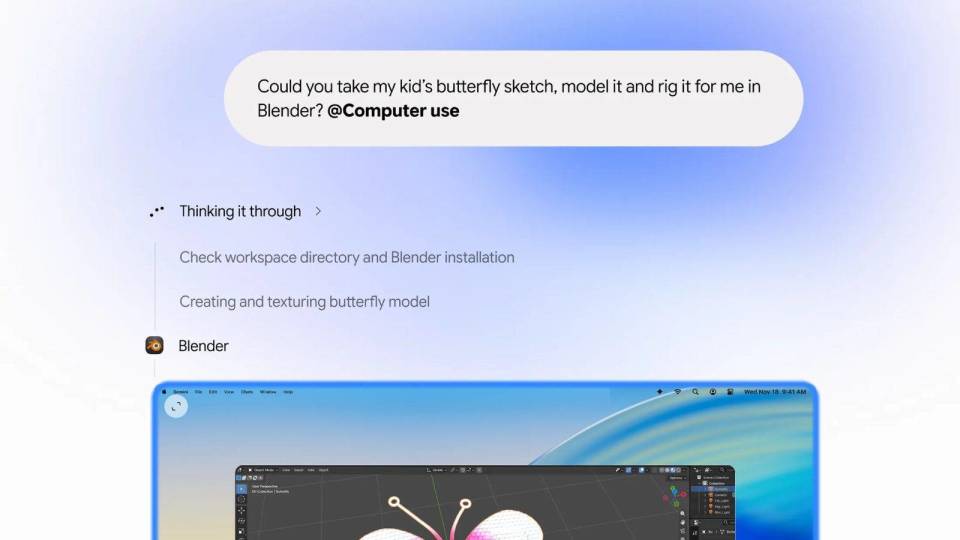
図:Geminiは今やバックエンドでMacアプリやWebサイトを操作し、複雑なタスクを遂行できる
私たちに取ってはこれは喜ばしいニュースです。主要3社が熾烈に争うほど、各メーカーは計算資源の投入やユーザー獲得に積極的に乗り出すため、私たちはより安価で信頼性が高く、アクセスしやすいAIを利用できる機会が増えます。(ハジミ、他の2社にならわないでくださいね)。
TechFlow公式コミュニティへようこそ
Telegram購読グループ:https://t.me/TechFlowDaily
Twitter公式アカウント:https://x.com/TechFlowPost
Twitter英語アカウント:https://x.com/BlockFlow_News
 @ifanr