Tout le monde se trompe, Stripe rachète OpenRouter pour la sécurité de l’IA : un investisseur seed d’a16z révèle la véritable raison
Il y a deux jours, Stripe a officiellement annoncé l'acquisition d'OpenRouter, avec des rumeurs évoquant un montant supérieur à 80 milliards de dollars. Pourquoi Stripe est-il prêt à payer une somme aussi élevée ?
L'une des personnes les mieux placées pour répondre à cette question est Anjney Midha. En effet, il n'est pas seulement l'un des premiers investisseurs clés d'OpenRouter, mais également membre de son conseil d'administration. Il a dirigé le tour de table seed d'a16z dans OpenRouter, avant de continuer à miser lourdement après avoir fondé AMP PBC.
Le parcours de Midha est extrêmement atypique. Il s'est initié au machine learning à Stanford, avant de rejoindre Kleiner Perkins où il a joué un rôle clé dans la création de KPCB Edge, sa brigade dédiée aux investissements technologiques de précoce. Il a ensuite entrepris une carrière d'entrepreneur en fondant Ubiquity6, une société spécialisée dans la vision par ordinateur et le spatial computing multi-utilisateurs, rachetée par Discord en 2021. Il est ensuite devenu vice-président de l'écosystème plateforme de Discord, a créé la première équipe dédiée aux plateformes développeurs de Discord et a personnellement supervisé le partenariat avec Midjourney.

En 2023, il a rejoint a16z pour y diriger les investissements en IA. En tant qu'investisseur, il a très tôt parié sur Anthropic, ElevenLabs, Luma AI, Ideogram, Mistral AI, Black Forest Labs, LMArena, Sesame AI, Periodic Labs et OpenRouter. La véritable force de cet homme ne réside pas seulement dans ses nombreux succès auprès de sociétés vedettes, mais surtout dans sa capacité constante à identifier une nouvelle catégorie avant même que le marché ne la comprenne vraiment.
Peu de temps après l'annonce officielle du deal entre Stripe et OpenRouter, Midha a publié un article sur le site web d'AMP proposant une synthèse particulièrement originale de cette acquisition.
Selon lui, la plupart des gens ont manqué la véritable raison pour laquelle Stripe acquiert OpenRouter.
Stripe n'achète pas simplement un « routeur de modèles », ni une nouvelle interface de facturation pour l'IA. Ce qu'il acquiert, c'est l'un des rares actifs réellement stratégiques en matière de sécurité et d'alignement inter-modèles au sein de tout l'écosystème IA actuel.
1. Introduction
OpenRouter a annoncé qu'elle rejoindrait Stripe. De nombreux capitalistes-risqueurs, commentateurs et analystes se sont exprimés sur le caractère parfaitement logique ou absolument absurde de cette fusion ; la validité du propos semble dépendre du jour de la semaine. Nous n'avons toutefois encore lu aucune analyse qui ait véritablement touché le but.
La réponse courte est simple : cela vise la sécurité et l'alignement de l'IA à l'échelle de tout l'écosystème.
Pas pour le routage, pas pour centraliser la facturation, et pas parce que les « tokens sont le nouveau dollar » (même si tel est le cas). Voici l'explication complète.
2. Stripe est une entreprise de sécurité
On considère généralement Stripe comme une entreprise de transfert de fonds. Pourtant, limiter son rôle à un simple mouvement d'argent revient à traiter cela comme une commodité standardisée ; les banques effectuent cette tâche depuis des siècles avec des marges infinitésimales.
Ce que Stripe a véritablement bâti est une machine de confiance en ligne capable de fonctionner à grande échelle. Chaque jour, Radar évalue les risques associés aux transactions adversariales à travers l'ensemble du réseau. Cette API louée par tous n'est fondamentalement qu'une expérience développeur calquée sur une infrastructure de sécurité ; elle repose en sous-jacent sur des modèles de détection de fraude, la gestion des chargebacks, l'authentification ainsi qu'une conformité couvrant toutes les juridictions mondiales.
Stripe s'impose car, face à un trafic malveillant à l'échelle d'internet, elle excelle plus que tout concurrent à assumer et gérer les risques.
3. La nature des données chez OpenRouter
Nous avions publié une étude analysant les 100 billions de tokens transitant par OpenRouter [1]. Contrairement à ce que beaucoup imaginent, la requête médiane typique ne provient pas d'un humain posant une question à un grand modèle de langage, mais d'une machine fonctionnant en boucle :
En l'espace d'un an, la part du trafic des modèles d'inférence est passée d'un niveau quasi négligeable à plus de la moitié du volume total (figure 1) ; la longueur moyenne des prompts a été multipliée par quatre (figure 2) ; une proportion significative de requêtes se termine enfin par un appel d'outil (figure 3).
La conclusion centrale de cette recherche est des plus directes :
Les plateformes d'inférence doivent désormais gérer à grande échelle des contextes et des états en évolution continue.
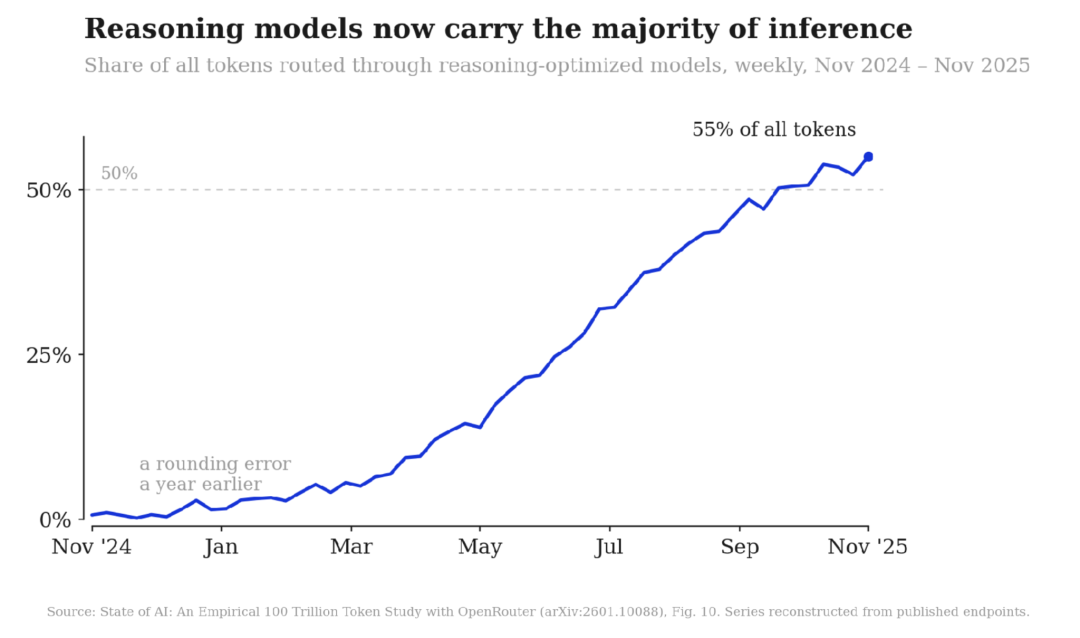
Figure 1 : Part des tokens pour les modèles d'inférence, hebdomadaire, novembre 2024 à novembre 2025.
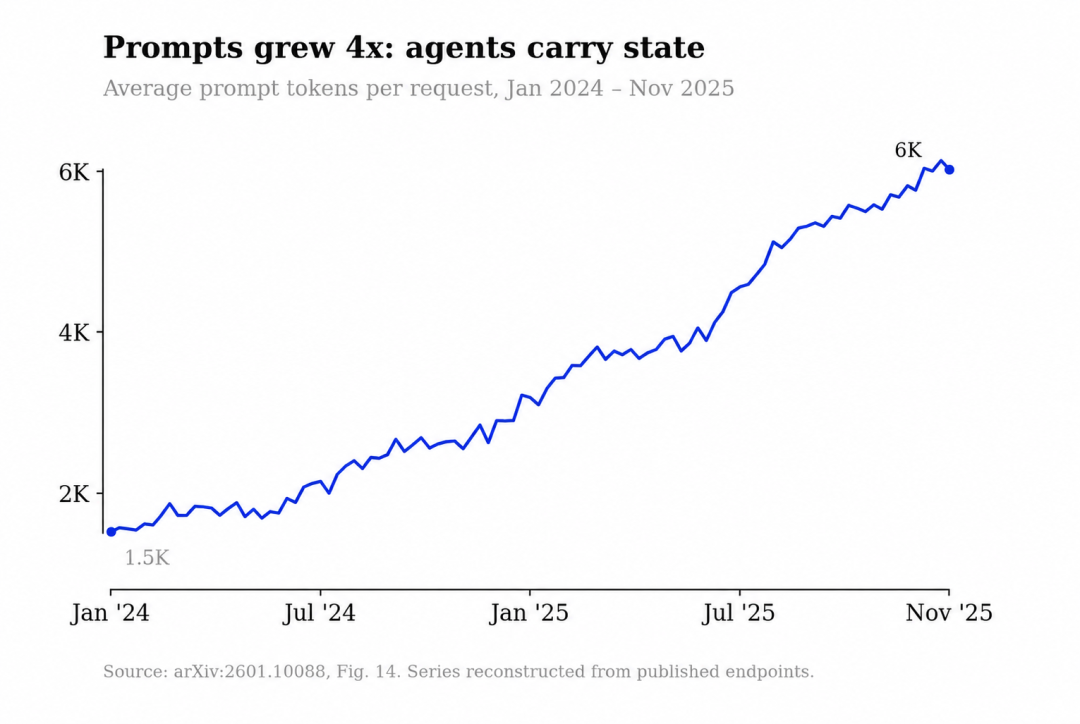
Figure 2 : Nombre moyen de tokens de prompt par requête, janvier 2024 à novembre 2025.
4. L'alignement est un problème de rétroaction contextuelle
Tout comme le paiement à grande échelle, la sécurité avancée de l'IA à grande ampleur constitue un problème continu de boucle de rétroaction contextuelle. La barrière défensive de Stripe Radar repose principalement là-dessus : depuis dix ans, elle s'entraîne quotidiennement sur des volumes massifs de données relatives aux transactions adversariales.
Impossible de reproduire ce modèle sans des corpus de données suffisamment frais ; et il est impossible d'obtenir de tels corpus sans être placé directement au cœur du flux transactionnel. Toutes les activités de sécurité viables à long terme partagent exactement la même architecture :
Le produit est le modèle, le fossé défensif est la donnée, et la donnée provient du trafic.
Si l'on examine à nouveau la section 3 sous un angle sécuritaire, on constate que les Agents détiennent des identifiants, invoquent des outils et initient des paiements. Un processus autonome disposant d'autorisations de dépense et évoluant dans un contexte de 20 000 tokens est en soi une contrepartie financière.
Ces contreparties matérielles adversariales peuvent être manipulées par des humains malveillants, c'est-à-dire subir un abus (misuse) ; poursuivre des objectifs non intentionnellement définis par leur opérateur mais déjà assimilés par le modèle, soit un désalignement (misalignment) ; ou encore être détournées via des instructions injectées durant leur exécution, constituant une compromission (compromise). Quel que soit le cas, elles sont susceptibles de perpétrer des fraudes à la vitesse de la machine, de voler et d'exfiltrer des données, ainsi que de drainer des budgets.
Lorsque ces contreparties adversariales s'appuient sur des modèles à poids ouverts, aucun laboratoire upstream ne peut les observer ni les annuler. Le seul endroit où des contraintes peuvent être appliquées est la couche où la transaction a réellement lieu. La manière de protéger les systèmes d'inférence sera similaire à celle de protéger les systèmes de paiement :
Entraîner des modèles sur des données transactionnelles à grande échelle.
Ainsi, cette acquisition se ramène finalement à une seule question : qui possède ces données ?
Ni les laboratoires de modèles. Chaque labo de modèles de pointe observe d'immenses flux de trafic, mais ne voit que celui portant sur ses propres modèles, à l'image d'une banque ne consultant que ses propres comptes. On ne peut pas entraîner le modèle de détection de fraude de Visa en se basant uniquement sur les écritures d'une seule banque ; et pour les modèles à poids ouverts, une telle « banque » n'existe tout simplement pas. Ni les fournisseurs cloud. Ils peuvent observer l'infrastructure, mais jamais l'intentionnalité des comportements.
Il convient d'abord de préciser quelques termes, car la sécurité de l'IA accorde une importance cruciale à la distinction entre ces concepts.
5. La pile technologique d'alignement de l'IA de pointe qui se construit
L'alignement est une propriété du comportement systémique. À l'heure actuelle, ce domaine étudie principalement la problématique de l'alignement sous deux angles.
Les méthodes au moment de l'entraînement (training-time methods) visent à façonner les intentions comportementales du modèle. Un nombre croissant d'études sur l'alignement au moment de l'inférence (inference-time alignment) tente, sans réentraîner le modèle, de contraindre son fonctionnement lors du déploiement pour qu'il agisse conformément aux attentes [5, 6]. Parallèlement, la recherche sur le contrôle de l'IA se concentre sur la manière de garantir la sécurité des systèmes déployés, même lorsque l'alignement initial a échoué [3, 4].
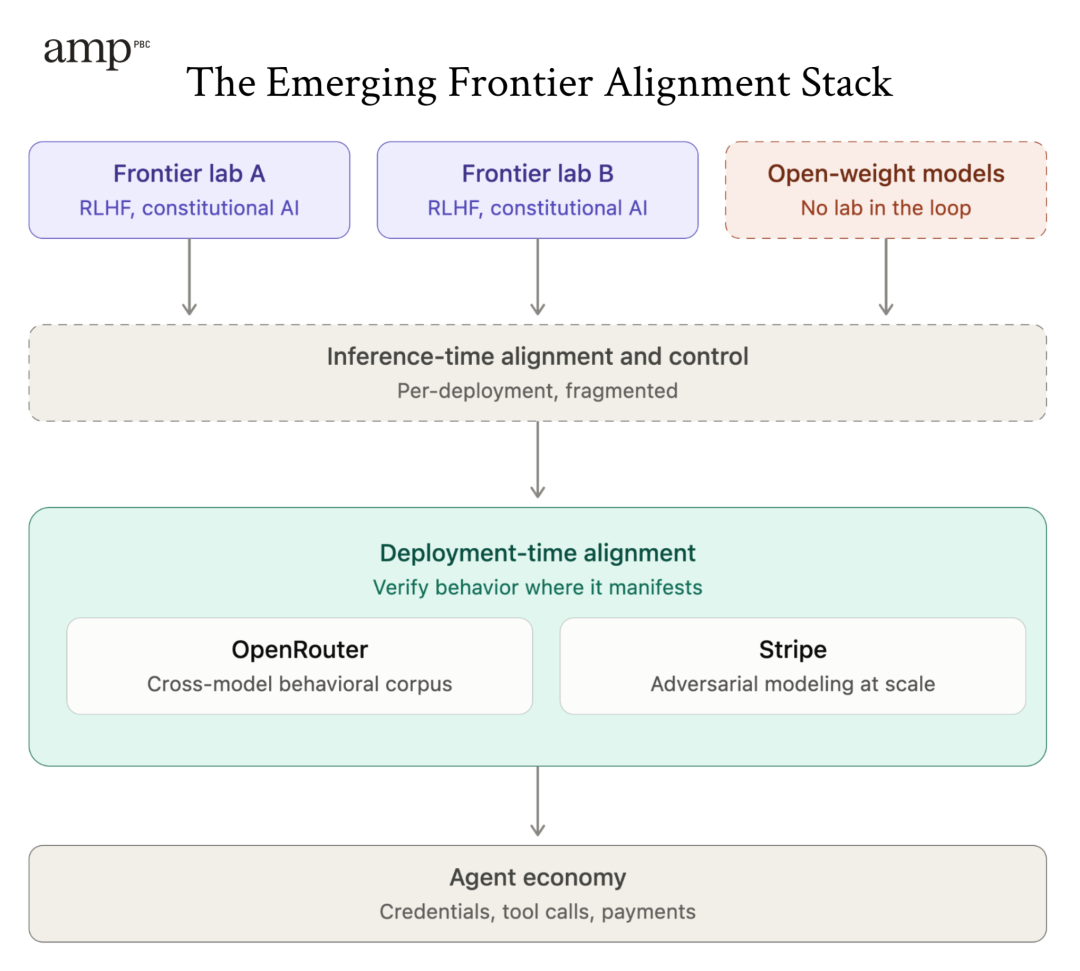
Figure 3 : La pile technologique d'alignement de l'IA de pointe qui se construit
Nous utilisons le terme « alignement au moment du déploiement » (deployment-time alignment) pour désigner cette problématique composite : il s'agit de vérifier et de faire respecter le comportement attendu des Agents déjà déployés dans des environnements de production réels, puisque c'est précisément ici que les échecs d'alignement se matérialisent concrètement.
La vérification nécessite de la surveillance, dont l'efficacité dépend de la qualité des données comportementales servant à entraîner les systèmes de monitoring [7]. Les données comportementales des Agents constituent une propriété réseau :
Il nous faut pouvoir les observer à travers chaque modèle et chaque fournisseur que contacte un même Agent. Car qu'il s'agisse d'abus, de désalignement ou de compromission, au moment où le comportement se déclenche, il apparaît toujours sous la même forme exacte : une transaction.
Par conséquent, la sécurité des Agents relève fondamentalement d'un problème d'alignement au déploiement ; et cet alignement au déploiement est, tout comme la détection de fraude traditionnelle, avant tout un problème de données.
À l'heure actuelle, un seul dataset de ce type existe.
OpenRouter traite quotidiennement plus de 10 billions de tokens, couvrant plus de 500 modèles provenant de dizaines de fournisseurs, incluant les traces d'exécution, les graphiques d'appels d'outils, les vitesses de dépense, les décisions de routage et les schémas d'échec.
Il s'agit actuellement de la plus vaste base de données transactionnelles d'inférence inter-modèles au monde. Pour les modèles à poids ouverts, c'est même l'unique. Ces modèles à poids ouvert portent désormais une charge de travail issue des Agents considérable et en forte croissance [1]. Une même checkpoint de modèle ouvert est servie par des dizaines de fournisseurs indépendants les uns des autres ; aucun n'est l'auteur du modèle, aucun n'assume une responsabilité totale sur le comportement du modèle, et aucun ne peut voir au-delà de son périmètre local. Ce n'est qu'au niveau de la couche de routage que ces comportements convergent réellement.
Il est impératif d'établir une distinction précise ici : il s'agit de métadonnées dotées d'une structure transactionnelle, et non du contenu des prompts. OpenRouter désactive par défaut la journalisation des prompts [2] ; les recherches empiriques associées reposent intégralement sur des métadonnées, sans accéder au moindre prompt ni au texte complété par le modèle [1].
De même, Stripe Radar ne lit pas le contenu précis des paniers d'achat. Les modèles de fraude s'appuient sur la forme des transactions, et OpenRouter dispose des formes de transactions inter-réseaux les plus riches disponibles sur le marché, surpassant toute autre entité concurrente.
L'objection la plus évidente concerne la centralisation des données : cette opération place l'unique corpus de données comportementales inter-modèles existant entre les mains d'une entreprise privée. Or, un dataset aussi unique et intimement lié à la sécurité constitue précisément l'actif que la communauté craint le plus de voir soumis à un contrôle centralisé.
Pourtant, les alternatives risquent d'être pires : des données resteraient fragmentées et dispersées chez des dizaines de fournisseurs, aucun ne pouvant saisir assez d'informations pour agir ; ou bien ces données finiront par être contrôlées par un laboratoire de pointe détenant des intérêts directs dans des modèles concurrents. Comparées à ces scénarios, le résultat actuel représente un avantage net rare (Net positive).
Stripe maintient une neutralité suffisante vis-à-vis des différents modèles : elle n'entraîne aucun modèle de pointe et ne rivalise avec aucun laboratoire. L'incitation commerciale de Stripe consiste à offrir des garanties de confiance à toutes les parties intervenant dans les transactions transitant par son système. Cette incitation va dans le sens des objectifs de sécurité de l'ensemble de l'écosystème.
En d'autres termes, Stripe n'achète pas un routeur, mais un actif stratégique de sécurité et d'alignement pour les systèmes d'IA de pointe.
Nous sommes convaincus que l'intégration de cet actif aux infrastructures existantes de Stripe renforcera la capacité de tout l'écosystème à mener ses propres travaux d'alignement ; exploit difficilement réalisable de manière autonome par un seul laboratoire de modèles. Par conséquent, cette acquisition constitue un avantage net pour le développement sain d'un écosystème d'IA de pointe indépendant.