Последнее выступление Дженсена Хуанга на CES 2026: три ключевые темы и один «чип-монстр»
Авторы: Ли Хайлунь, Сю Ян
По пекинскому времени 6 января генеральный директор NVIDIA Дженсен Хуанг вновь вышел на главную сцену CES 2026 в своей фирменной кожаной куртке.
На CES 2025 NVIDIA продемонстрировала массовые чипы Blackwell и полный стек физического ИИ. На конференции Дженсен Хуанг подчеркнул, что открывается «эра физического ИИ». Он нарисовал фантастическую картину будущего: беспилотные автомобили обладают способностью к рассуждению, роботы способны понимать и размышлять, а ИИ-агенты (AI Agent) могут обрабатывать задачи с длинным контекстом в миллионы токенов.
Прошел всего год, и отрасль ИИ претерпела грандиозные изменения и эволюцию. Подводя итоги года на презентации, Дженсен Хуанг уделил особое внимание моделям с открытым исходным кодом.
Он отметил, что такие модели для вывода с открытым исходным кодом, как DeepSeek R1, заставили всю отрасль осознать: когда начинается истинное открытое глобальное сотрудничество, скорость распространения ИИ становится невероятно высокой. Хотя в целом мощности таких моделей все еще отстают от самых передовых примерно на полгода, каждые шесть месяцев они сокращают этот разрыв, а количество загрузок и пользователей уже растет взрывными темпами.
В отличие от CES 2025, где преобладали демонстрация видения и возможностей, в этот раз NVIDIA приступила к системному решению вопроса «как это реализовать» вокруг ИИ для рассуждений: восполнена инфраструктура вычислений, сетей и хранилищ, необходимых для долгосрочной работы, значительно снижены затраты на вывод, а эти возможности напрямую интегрированы в реальные сценарии, такие как беспилотный транспорт и робототехника.
Выступление Дженсена Хуанга на CES в этом году строилось вокруг трех основных направлений:
● На уровне систем и инфраструктуры NVIDIA переосмыслила архитектуру вычислений, сетей и хранилищ в соответствии с потребностями долгосрочного вывода. В основе обновлений — платформа Rubin, NVLink 6, сеть Ethernet Spectrum-X и платформа хранения контекстной памяти при выводе. Эти обновления направлены на преодоление узких мест, таких как высокая стоимость вывода, сложность поддержания контекста и ограничения масштабируемости, решая задачу экономичного «дополнительного размышления», доступных расчетов и долгой работы ИИ.
● На уровне моделей NVIDIA поставила ИИ для рассуждений (Reasoning / Agentic AI) в центр внимания. Используя модели и инструменты Alpamayo, Nemotron, Cosmos Reason и другие, компания продвигает ИИ от простого «генерирования контента» к непрерывному размышлению, переводя его от «моделей одноразового ответа» к «агентам, способным работать длительное время».
● На уровне приложений и внедрения эти возможности напрямую интегрируются в сценарии физического ИИ, такие как автономное вождение и робототехника. Будь то система автономного вождения на базе Alpamayo или экосистема роботов на базе GR00T и Jetson, партнерство с облачными провайдерами и корпоративными платформами способствует их масштабному развертыванию.
01 От дорожной карты к массовому производству: Rubin впервые раскрывает полные данные о производительности
На этой CES NVIDIA в первый раз полностью раскрыла технические детали архитектуры Rubin.
В выступлении Дженсен Хуанг начал с концепции Test-time Scaling (масштабирование во время вывода), которую можно понять так: чтобы ИИ стал умнее, достаточно не просто заставить его «больше учиться», а позволить ему «немножко больше подумать, когда возникает проблема».
Ранее рост возможностей ИИ достигался в основном за счет дополнительных вычислений на этапе обучения и наращивания размера моделей; теперь ситуация изменилась: даже если модель больше не увеличивается в размерах, предоставление ей дополнительного времени и вычислительных ресурсов для размышлений при каждом использовании дает явное улучшение результатов.
Как сделать «дополнительное размышление ИИ» экономически целесообразным? Новое поколение вычислительных платформ для ИИ на базе архитектуры Rubin создано именно для решения этой задачи.
Дженсен Хуанг пояснил, что представляет собой полноценную вычислительную систему следующего поколения, созданную благодаря слаженной работе компонентов Vera CPU, Rubin GPU, NVLink 6, ConnectX-9, BlueField-4 и Spectrum-6, что обеспечивает революционное снижение стоимости вывода.
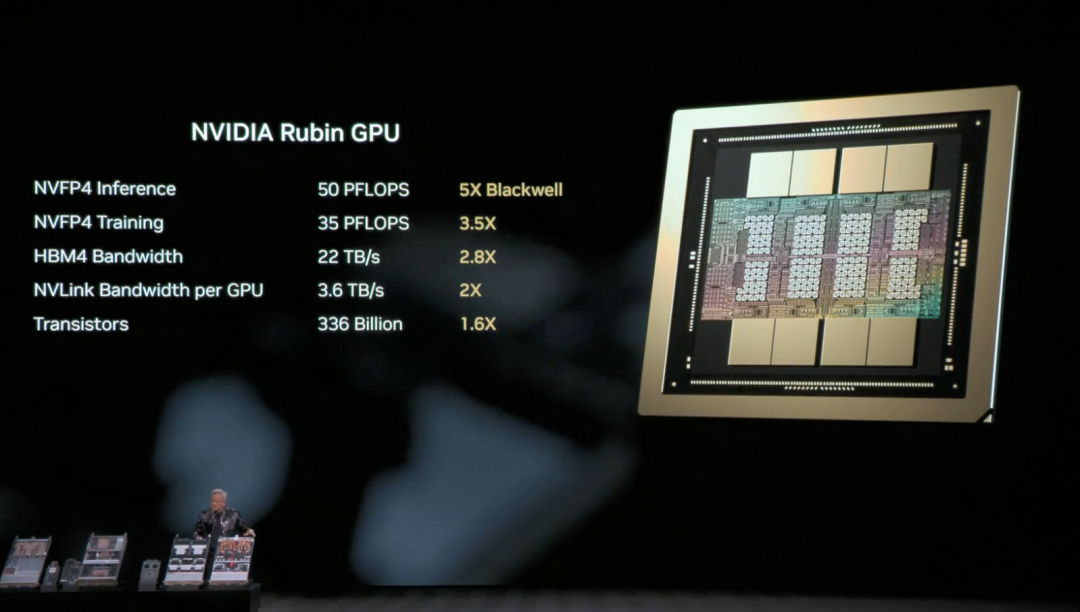
GPU Rubin компании NVIDIA является ключевым чипом в архитектуре Rubin, отвечающим за вычисления ИИ, и направлена на значительное снижение удельных затрат на вывод и обучение.
Говоря простыми словами, главная задача Rubin GPU — «заставить ИИ работать дешевле и умнее».
Ключевая возможность Rubin GPU заключается в следующем: одна видеокарта может выполнять больше задач. Она способна обрабатывать больше задач вывода одновременно, запоминать более длинные контексты и быстрее обмениваться данными с другими GPU. Это означает, что многие сценарии, которые раньше требовали жесткого наращивания количества карт, теперь можно реализовать с меньшим числом GPU.
В результате вывод происходит не только быстрее, но и заметно дешевле.
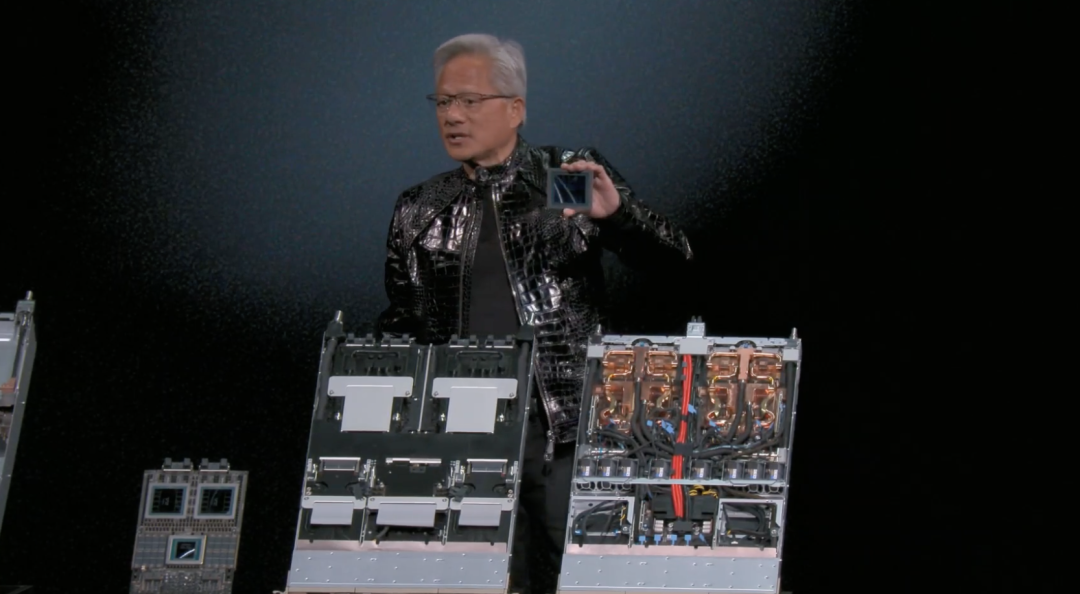
Дженсен Хуанг на сцене напомнил присутствующим о параметрах оборудования архитектуры Rubin для конфигурации NVL72: содержит 220 триллионов транзисторов, пропускная способность составляет 260 ТБ/с. Это первая в индустрии платформа, поддерживающая конфиденциальные вычисления в масштабе стойки.
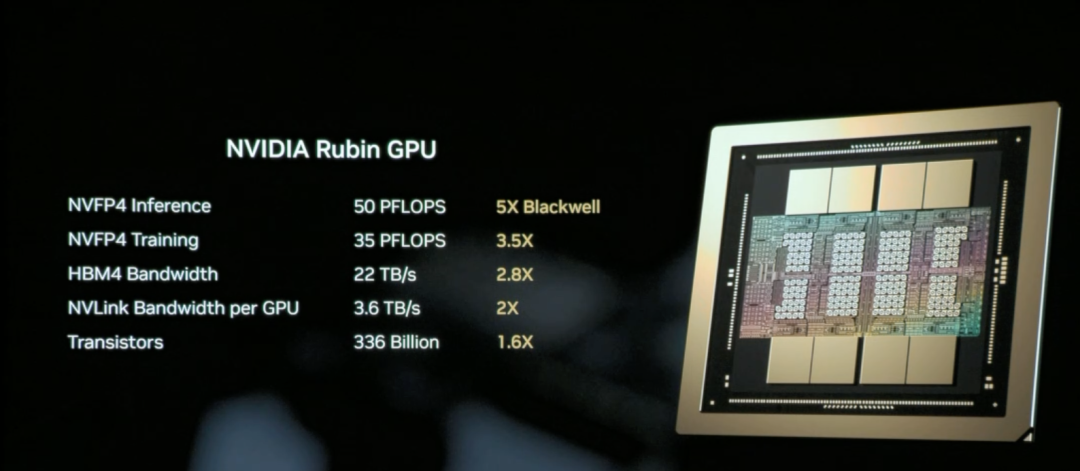
В целом по сравнению с Blackwell, Rubin GPU демонстрирует межпоколенческий скачок по ключевым показателям: производительность вывода в формате NVFP4 выросла до 50 PFLOPS (в 5 раз), производительность обучения увеличилась до 35 PFLOPS (в 3,5 раза), пропускная способность памяти HBM4 поднялась до 22 ТБ/с (в 2,8 раза), а полоса пропускания NVLink между отдельными GPU удвоилась, составив 3,6 ТБ/с.
Эти улучшения вместе позволяют одному GPU обрабатывать больше задач вывода и более длинные контексты, что фундаментально снижает зависимость от количества видеокарт.
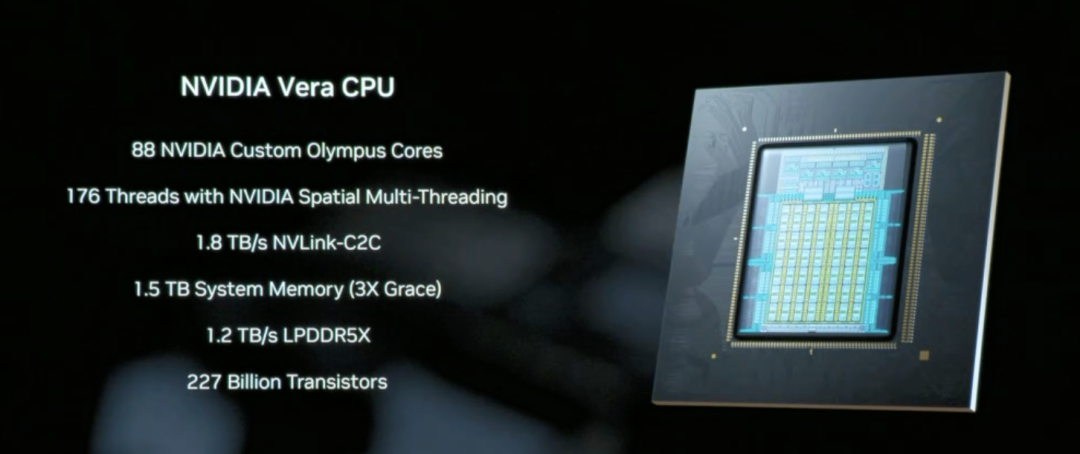
Vera CPU — это базовый компонент, специально разработанный для перемещения данных и обработки агентов, оснащенный 88 фирменными ядрами Olympus компании NVIDIA, 1,5 ТБ системной памяти (в 3 раза больше, чем у предыдущего поколения Grace CPU) и обеспечивающий согласованный доступ к памяти между CPU и GPU посредством технологии NVLink-C2C со скоростью 1,8 ТБ/с.
В отличие от традиционных универсальных процессоров, Vera специализируется на управлении потоками данных в задачах вывода ИИ и обработке многошаговой логики рассуждений, выполняя роль системного координатора, который эффективно обеспечивает «дополнительное размышление ИИ».
Благодаря пропускной способности 3,6 ТБ/с и вычислительным возможностям внутри сети, NVLink 6 позволяет 72 GPU в архитектуре Rubin работать согласованно как единый супер-GPU, что является критической инфраструктурой для снижения затрат на вывод.
Таким образом, данные и промежуточные результаты, необходимые ИИ при выводе, могут мгновенно перемещаться между GPU без необходимости повторного ожидания, копирования или пересчета.
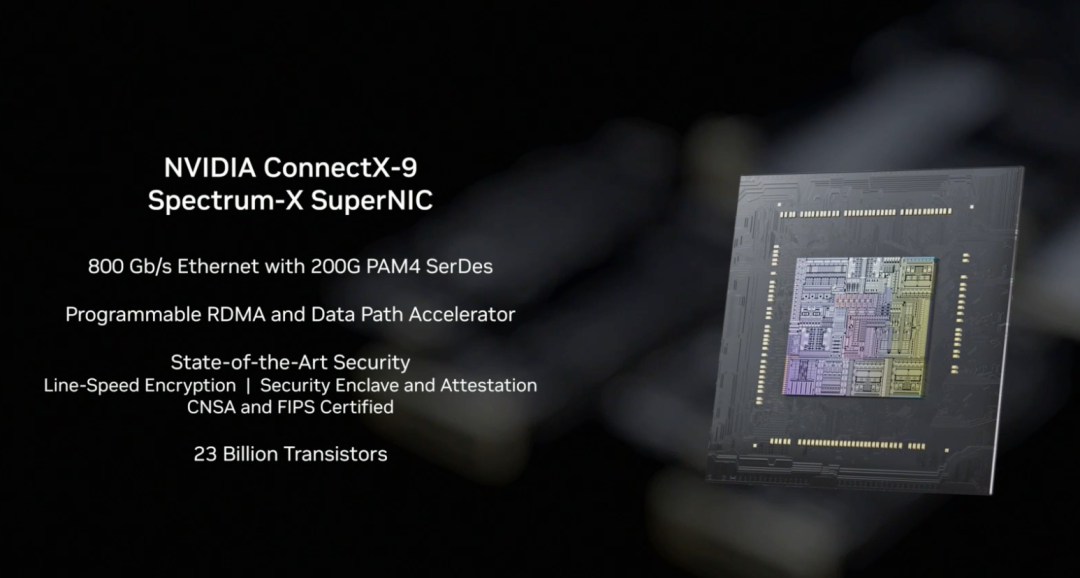
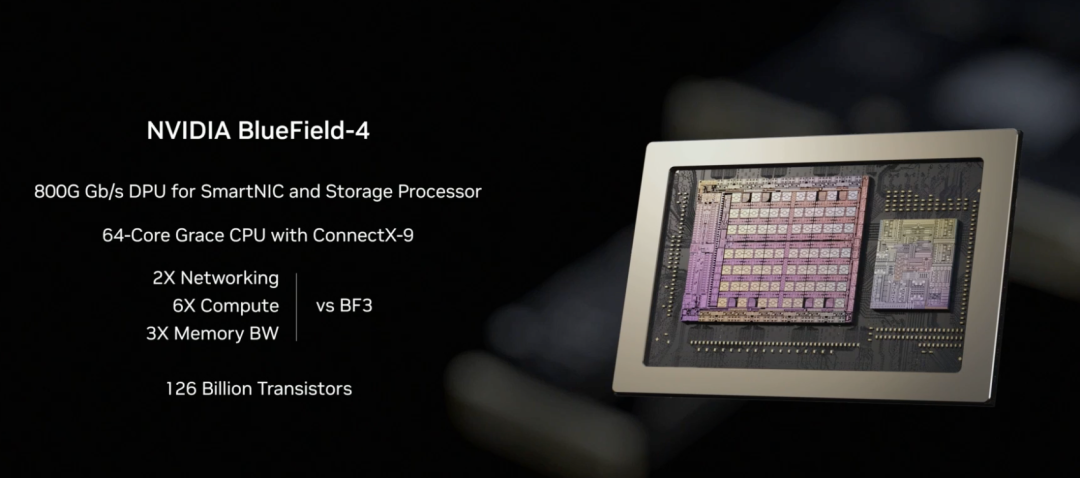
В архитектуре Rubin функция синхронизированных вычислений между GPU возложена на NVLink-6, управление контекстом и планированием данных выполняет BlueField-4, а высокоскоростное сетевое соединение системы с внешним миром обеспечивает ConnectX-9. Это гарантирует эффективное взаимодействие системы Rubin с другими стойками, центрами обработки данных и облачными платформами, являясь необходимым условием успешного выполнения крупномасштабных задач обучения и вывода.
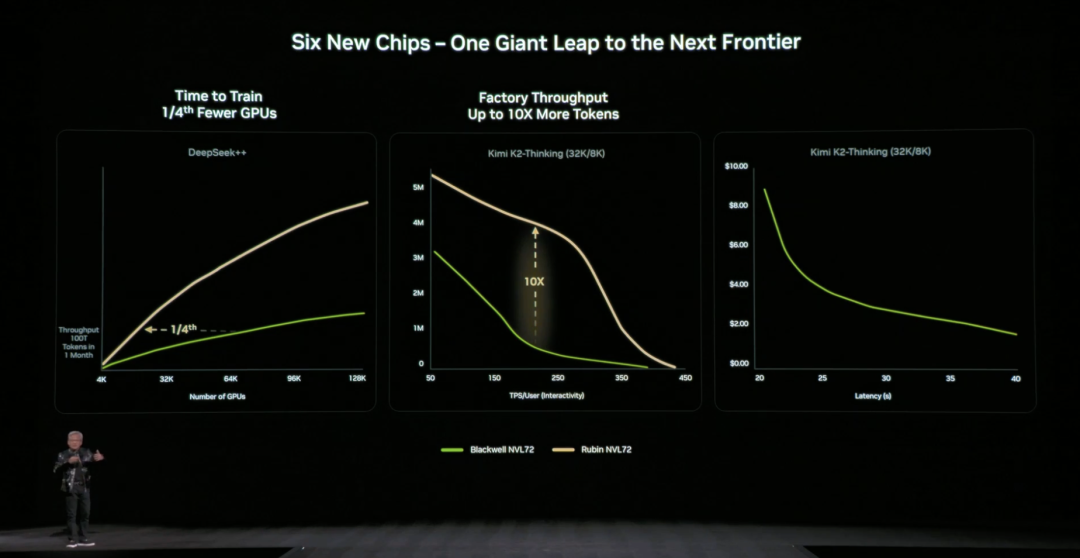
По сравнению с архитектурой предыдущего поколения NVIDIA представила конкретные данные: по сравнению с платформой NVIDIA Blackwell себестоимость одного токена на этапе вывода может быть снижена максимум в 10 раз, а количество GPU, необходимых для обучения смешанных экспертных моделей (MoE), сокращается до четверти от прежнего уровня.
По официальным данным NVIDIA, Microsoft уже обязалась развернуть сотни тысяч чипов Vera Rubin на базе новой сверхфабрики искусственного интеллекта Fairwater, а облачные провайдеры, такие как CoreWeave, предоставят экземпляры Rubin во второй половине 2026 года. Эта инфраструктура, позволяющая «ИИ задуматься лишний раз», переходит от технологических демонстраций к масштабному коммерческому использованию.
02 Как решить «проблему с хранилищем»?
Реализация «дополнительного размышления ИИ» сталкивается с одним ключевым техническим вызовом: где хранить данные контекста?
При обработке сложных задач, требующих многораундовых диалогов и многошагового вывода, генерируется огромный объем контекстных данных (KV Cache). Традиционные архитектуры либо помещают их в дорогую память GPU с ограниченным объемом, либо в обычное хранилище (где доступ слишком медленный). Без устранения этого «узкого места в хранении» даже самые мощные GPU будут постоянно простаивать.
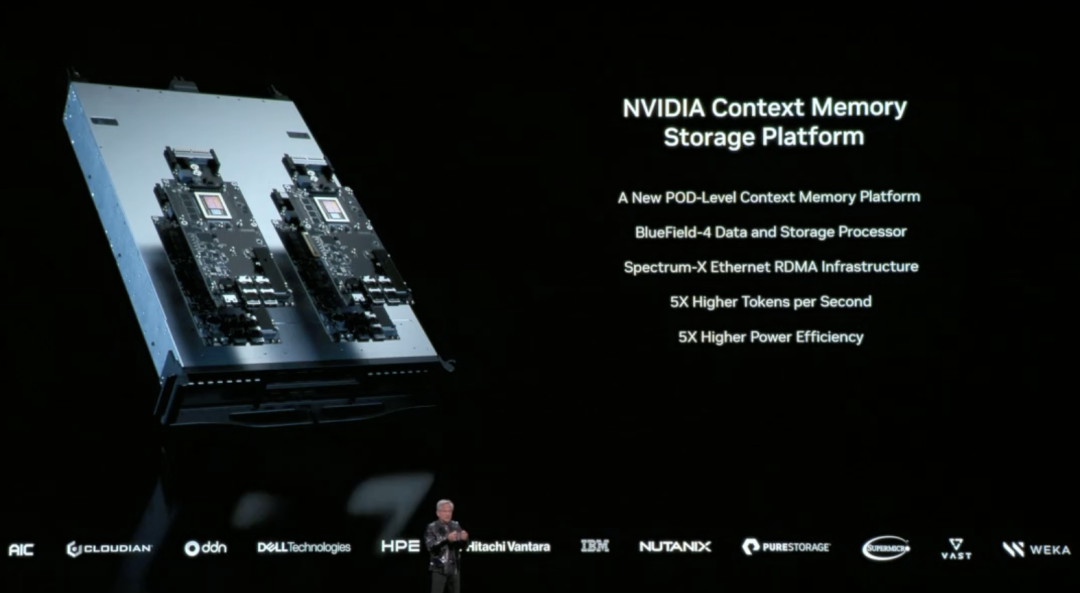
Для решения этой проблемы на текущей CES NVIDIA впервые полностью раскрыла платформу хранения контекстной памяти при выводе (Inference Context Memory Storage Platform), работающую на базе BlueField-4. Ее основная цель — создать «третий уровень» между памятью GPU и традиционными хранилищами. Этот уровень обладает достаточной скоростью и емкостью, а также поддерживает длительную работу ИИ.
С технической точки зрения该平台 работает не за счет одного компонента, а является результатом слаженной совместной работы нескольких элементов:
- BlueField-4 отвечает за аппаратное ускорение управления и доступа к контекстным данным, сокращая перемещение данных и системные накладные расходы;
- Ethernet Spectrum-X обеспечивает высокопроизводительную сеть с поддержкой высокоскоростного обмена данными на базе протокола RDMA;
- Программные компоненты, такие как DOCA, NIXL и Dynamo, оптимизируют планирование на системном уровне, снижают задержки и повышают общую пропускную способность.
Можно сказать, что подход данной платформы заключается в расширении контекстных данных, ранее хранившихся исключительно в памяти GPU, до независимого, высокоскоростного и общего «слоя памяти». С одной стороны, это снимает нагрузку с GPU, а с другой — позволяет быстро обмениваться контекстной информацией между несколькими узлами и множеством ИИ-агентов.
Что касается практических результатов, согласно официальным данным NVIDIA, в определенных сценариях данный подход способен повысить производительность в обработанных токенах в секунду до 5 раз, обеспечивая сопоставимое повышение энергоэффективности.
Дженсен Хуанг неоднократно подчеркивал в своем выступлении, что ИИ эволюционирует из «чатботов для одноразовых диалогов» в настоящие интеллектуальные коллаборативные системы: им необходимо понимать реальный мир, постоянно размышлять, использовать инструменты для выполнения задач и одновременно сохранять краткосрочную и долгосрочную память. Именно это является ключевой характеристикой Agentic AI. Платформа хранения контекстной памяти при выводе специально создана для такого формата ИИ, рассчитанного на долгую работу и повторяющиеся размышления. За счет увеличения емкости контекста и ускорения обмена между узлами она делает многораундовые диалоги и взаимодействие множества агентов более стабильными, устраняя проблему «замедления по мере работы».
03 Новое поколение DGX SuperPOD: объединение 576 GPU в единую систему
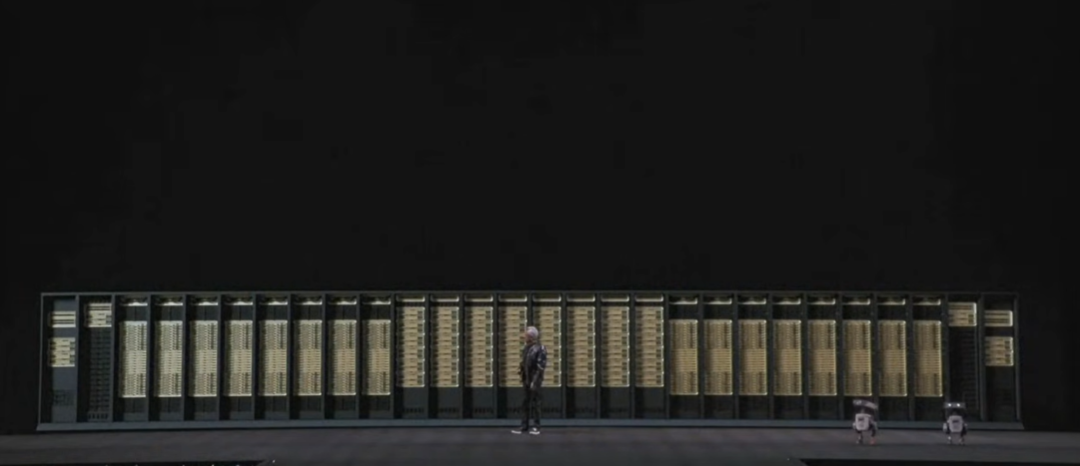
На текущей CES NVIDIA объявила о выпуске нового поколения DGX SuperPOD (суперноды) на базе архитектуры Rubin, расширяющего решения Rubin от одной серверной стойки до комплексного проекта для всего центра обработки данных.
Что такое DGX SuperPOD?
Если конфигурация Rubin NVL72 — это «суперстойка» с 72 GPU, то DGX SuperPOD соединяет несколько таких стоек в более крупный кластер вычислений ИИ. Новая версия состоит из 8 стоек Vera Rubin NVL72, что эквивалентно совместной работе 576 GPU.
Когда масштабы задач ИИ продолжают расти, 576 GPU в одной стойке могут оказаться недостаточными. Например, при обучении сверхкрупных моделей, одновременном обслуживании тысяч ИИ-агентов или обработке сложных задач с контекстом в несколько миллионов токенов. Для таких сценариев требуется согласованная работа нескольких стоек, и DGX SuperPOD представляет собой стандартизированное решение именно для них.
Для предприятий и облачных провайдеров DGX SuperPOD предлагает готовое решение инфраструктурной архитектуры ИИ «под ключ». Им не придется самостоятельно разбираться в подключении сотен GPU, настройке сетей или управлении хранилищами.
Пять ключевых компонентов нового поколения DGX SuperPOD:
○ 8 стоек Vera Rubin NVL72 — основа вычислительной мощности: в каждой стойке по 72 GPU, всего 576 GPU;
○ Расширенная сеть NVLink 6 — обеспечивает согласованную работу 576 GPU в этих 8 стойках как единого огромного GPU;
○ Расширенная сеть Ethernet Spectrum-X — соединяет различные SuperPOD между собой, а также связывает систему с хранилищами и внешней сетью;
○ Платформа хранения контекстной памяти при выводе — предоставляет общее хранилище контекстных данных для продолжительных задач вывода;
○ Программное обеспечение NVIDIA Mission Control — осуществляет планирование, мониторинг и оптимизацию всей системы.
Нынешнее обновление базируется на системе уровня стойки DGX Vera Rubin NVL72. Каждый модуль NVL72 сам по себе представляет полноценный ИИ-суперкомпьютер: внутри 72 GPU Rubin соединены через NVLink 6, что позволяет выполнять крупномасштабные задачи вывода и обучения в пределах одной стойки. Новый DGX SuperPOD формируется из нескольких таких блоков NVL72, создавая системный кластер, рассчитанный на длительную эксплуатацию.
При переходе объема вычислений от «одной стойки» к «нескольким стойкам» возникает новая узкая проблема: как стабильно и эффективно передавать огромные массивы данных между разными стойками. Решая эту задачу, NVIDIA в рамках текущей CES представила коммутаторы нового поколения на базе чипа Spectrum-6 и впервые внедрила технологию «совместной упаковки оптики» (CPO).
Проще говоря, вместо съемных оптических модулей они напрямую размещаются непосредственно рядом с чипом коммутатора, сокращая расстояние передачи сигнала с метров до миллиметров. Это существенно снижает энергопотребление и задержки, а также повышает общую надежность системы.
04 Открытый ИИ-«конверт» от NVIDIA: от данных до кода под рукой
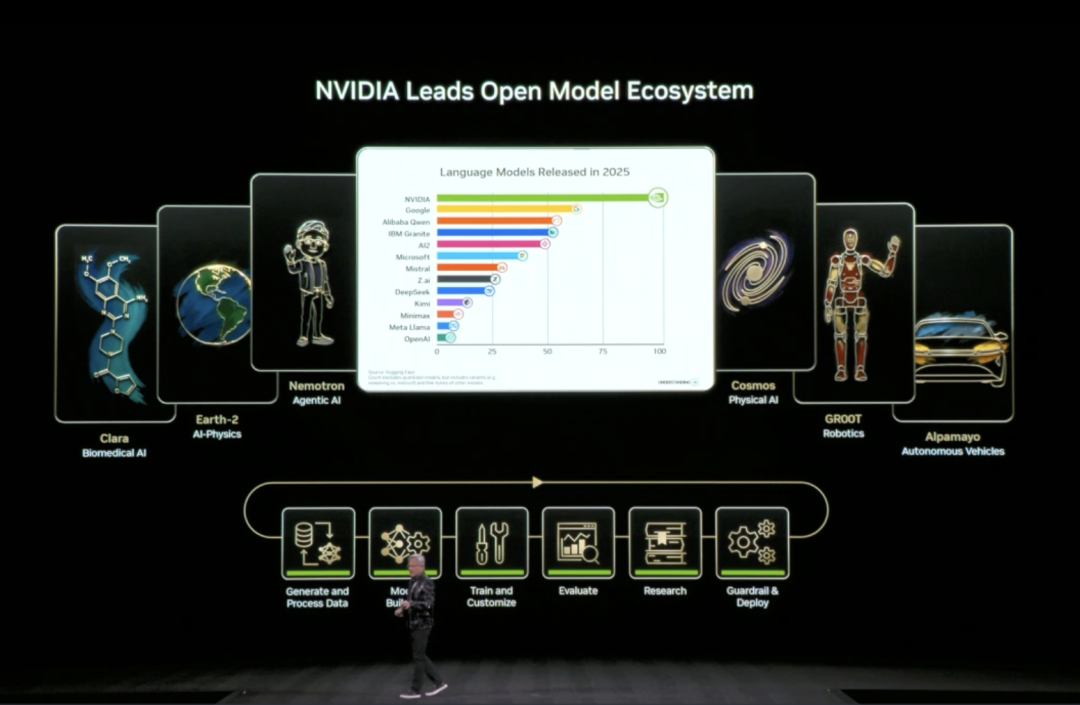
На нынешней CES Дженсен Хуанг объявил о расширении экосистемы открытых моделей (Open Model Universe), добавив и обновив ряд моделей, наборов данных, репозиториев кода и инструментов. Данная экосистема охватывает шесть ключевых областей: медицинский ИИ (Clara), физическое моделирование ИИ (Earth-2), Агентный ИИ (Nemotron), физический ИИ (Cosmos), робототехнику (GR00T) и автономное вождение (Alpamayo).
Для обучения модели ИИ требуются не только вычислительные ресурсы, но и целый комплекс инфраструктуры: качественные наборы данных, предварительно обученные модели, код для тренировок и инструменты оценки. Большинству компаний и научных институтов создание такой базы с нуля заняло бы слишком много времени.
Конкретно NVIDIA сделала общедоступной инфраструктуру из шести уровней: вычислительные платформы (DGX, HGX и др.), тренировочные наборы данных для разных областей, предварительно обученные базовые модели, библиотеки кода для вывода и обучения, готовые скрипты полного процесса тренировки, а также шаблоны сквозных решений.
Обновлением серии Nemotron стало главным фокусом данной презентации, которая охватывает четыре направления применения.
В направлении вывода представлены миниатюрные модели для анализа, такие как Nemotron 3 Nano и Nemotron 2 Nano VL, а также инструменты обучения с подкреплением NeMo RL и NeMo Gym. В сфере RAG (поисково-генеративный синтез) предложены векторная модель Nemotron Embed VL, модель переранжирования Nemotron Rerank VL, соответствующие наборы данных и библиотека поиска NeMo Retriever Library. В аспекте безопасности доступны модель обеспечения безопасности контента Nemotron Content Safety со связанными наборами данных и библиотека защиты NeMo Guardrails.
В области обработки речи представлена автоматическая распознавательная система Nemotron ASR, голосовой набор данных Granary Dataset и библиотека обработки речи NeMo Library. Таким образом, предприятиям, желающим создать клиентскую систему поддержки с RAG, не потребуется обучать собственные модели встраивания и переранжирования — можно напрямую задействовать заранее подготовленные и опубликованные компанией NVIDIA коде.
05 Физический ИИ выходит на стадию коммерческого внедрения
Не остался без обновлений и сектор физического ИИ: появились модели Cosmos (для понимания и генерации видео физического мира), универсальная базовая модель робототехники Isaac GR00T и визуально-языковая модель принятия решений Alpamayo для автономного вождения.
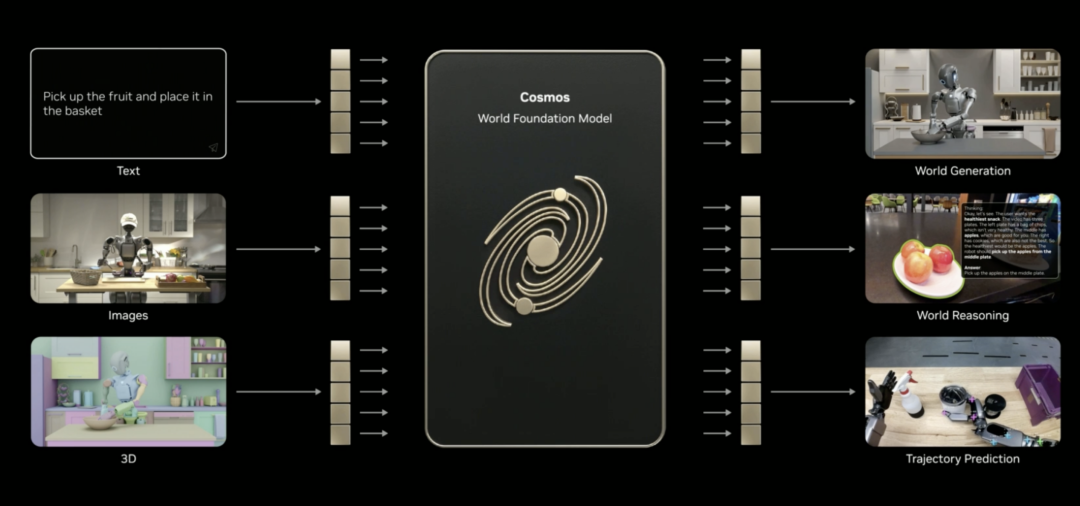
Дженсен Хуанг заявил на CES, что «эпоха ChatGPT для физического ИИ» уже близко, однако существует немало вызовов: физический мир крайне сложен и изменчив, а сбор реальных данных занимает много времени и денег, причем их всегда катастрофически не хватает.
Что делать? Одним из путей стала генерация синтетических данных. Так на свет появилась модель Cosmos.
Это базовая модель физического ИИ с открытым исходным кодом, предварительно обученная на колоссальных объемах видео, данных реального вождения и робототехники, а также в среде 3D-моделирования. Она понимает принципы функционирования окружающего мира и связывает текст, изображения, 3D-пространство и движения.
Дженсен Хуанг отметил, что Cosmos способен выполнять множество навыков физического ИИ, включая генерацию контента, логический вывод и предсказание траекторий (даже имея на руках лишь одну фотографию). Модель способна создавать реалистичные видеоролики на основе 3D-сцен, генерировать физику движения согласно данным вождения, а также формировать панорамные видео из симуляторов, изображений с множества камер или текстовых описаний. Даже редкие ситуации она сможет достоверно смоделировать.
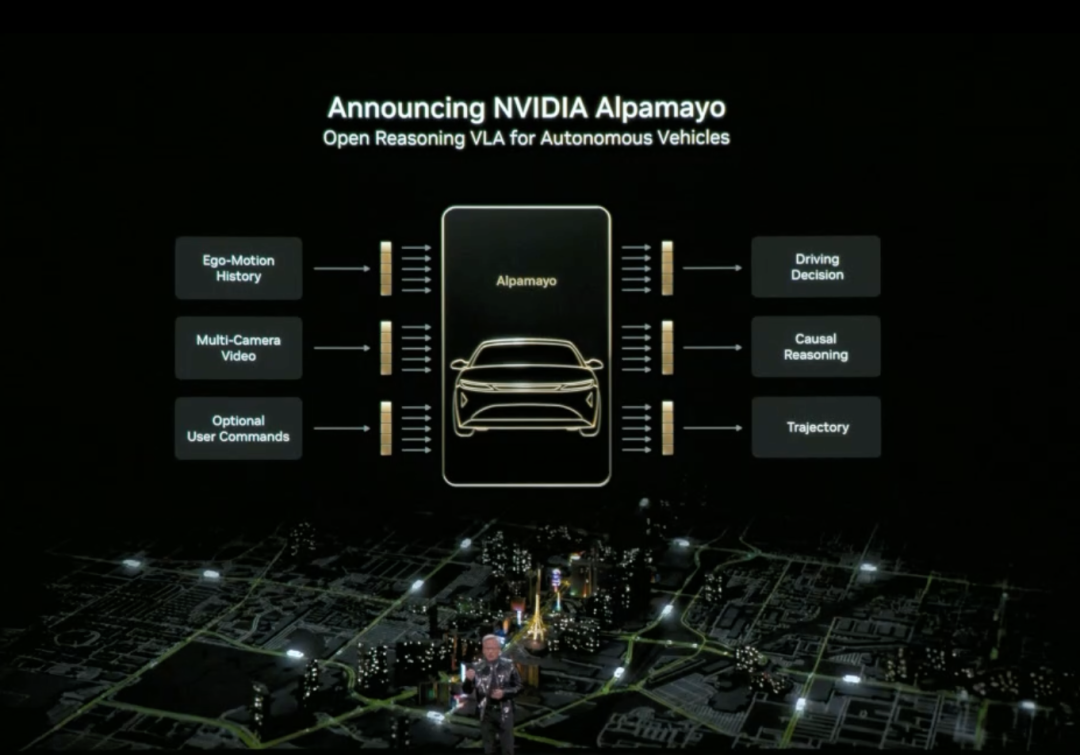
Кроме того, Дженсен Хуанг официально представил Alpamayo. Это открытый инструмент для разработки систем автономного вождения и первая публично доступная модель визуального языкового принятия решений (VLA). В отличие от прошлых публикаций, где открывался лишь программный код, сейчас NVIDIA публикует полный комплект ресурсов для разработки — от набора данных до этапа развертывания.
Главный прорыв Alpamayo заключается в том, что это модель автономного вождения класса «вывод». В традиционных системах применяется конвейерная архитектура «восприятие–планирование–управление», где машина просто реагирует на красные сигналы торможением или снижает скорость перед пешеходами согласно заранее заложенным алгоритмам. Alpamayo же интегрирует способность к логическому анализу: он понимает причинно-следственные связи в сложных ситуациях, прогнозирует намерения других участников дорожного движения и способен принимать решения, требующие последовательного обдумывания.
Например, на перекрестке система не просто фиксирует «транспорт впереди», а проводит анализ: «возможно, та машина собирается повернуть налево, значит, мне следует подождать». Такие навыки переводят автономное вождение с уровня строгого следования правилам на стадию человекоподобного мышления.
Дженсен Хуанг объявил о переходе платформы NVIDIA DRIVE в фазу серийного производства. Первым ее носителем станет новый Mercedes-Benz CLA, выход которого на дороги США запланирован на 2026 год. Автомобиль получит систему автономного вождения уровня L2++ и построена на гибридной архитектуре «сквозная ИИ-модель + классический конвейер».
Заметные сдвиги наблюдаются и в сфере робототехники.
По словам Дженсена Хуанга, ведущие мировые производители робототехники, включая Boston Dynamics, Franka Robotics, LEM Surgical, LG Electronics, Neura Robotics и XRlabs, уже создают продукты на базе платформы NVIDIA Isaac и базовой модели GR00T. Ассортимент охватывает множество сегментов: от промышленных манипуляторов и хирургических аппаратов до гуманоидных роботов и потребительских устройств.
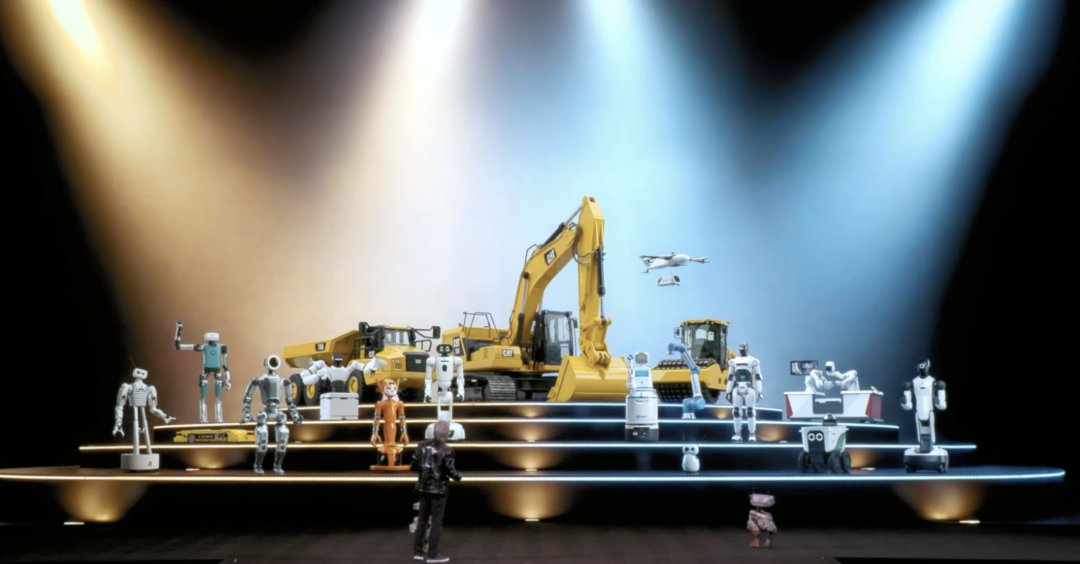
На сцене презентации за спиной Дженсена Хуанга разместилась экспозиция роботов различных форматов и назначений: от гуманоидов и двуногих, и колесных сервисных машин до промышленных манипуляторов, строительной техники, беспилотников и вспомогательного медицинского оборудования. Эта коллекция формирует целостную «экосистемную картину робототехники».
От решений в сфере физического ИИ до вычислительной платформы Rubin AI, от платформы хранения контекстной памяти при выводе до комплекса открытых ИИ-решений.
Все представленные на CES мероприятия компании сформировали целостную концепцию инфраструктурной базы ИИ эпохи логического вывода. Как неоднократно подчеркивал Дженсен Хуанг, когда физический ИИ будет обязан непрерывно мыслить, долго работать и прочно войдет в реальную жизнь, ключевым вопросом станет не столько наличие достаточных вычислительных мощностей, сколько умение построить и запустить эту систему целиком.
На CES 2026 NVIDIA уже представила свое решение.