Серия «Трагедия общин в крипто»: проблема индексации данных в Polymarket
Автор: shew
Резюме
Добро пожаловать в цикл «Трагедия общего ресурса» колонки GCC Research.
В этом цикле мы сосредоточимся на «общественных благах», которые играют ключевую роль в криптоэкосистеме, но постепенно теряют свои стандарты или выходят из строя. Они являются базовой инфраструктурой всей экосистемы, однако часто сталкиваются с недостатком стимулов, дисбалансом в управлении и даже процессом централизации. Идеалы, которых стремится достичь криптография, и необходимая для реальности избыточная стабильность проходят здесь жестокое испытание.
В этом выпуске мы сосредоточимся на одном из самых известных за пределами криптокругов приложений экосистемы Ethereum: Polymarket и инструментах индексации данных. Особенно с начала года вокруг таких событий, как победа Трампа, манипуляции оракулов по сделкам с редкоземельными металлами Украины, политические ставки на цвет костюма Зеленского, Polymarket несколько раз оказывался в центре общественного внимания. Масштабы привлеченного капитала и рыночное влияние, которые оно несет, делают эти споры совершенно неотъемлемыми.
Однако удалось ли действительно децентрализовать ключевой базовый модуль продукта, представляющего собой «децентрализованный рынок прогнозирования», — индексацию данных? Почему такие публичные инфраструктуры, как The Graph, не смогли выполнить возложенную на них роль? Каков должен быть облик по-настоящему работоспособной и устойчивой общественной блага для индексации данных?
1. Цепная реакция сбоя централизованной платформы данных
В июле 2024 года платформа Goldsky пережила сбой продолжительностью шесть часов (Goldsky — это платформа блокчейн-инфраструктуры реального времени для разработчиков Web3, предоставляющая услуги индексации, субграфов и потоковых данных, помогающая быстро строить децентрализованные приложения на основе данных), что привело к параличу значительной части проектов в экосистеме Ethereum. Например, фронтенды DeFi перестали отображать позиции и балансы пользователей, Polymarket не показывала корректные данные, а бесчисленное количество проектов казалось полностью неработоспособными для пользователей фронтенда.
Этого не должно было произойти в мире децентрализованных приложений. В конце концов, разве первоначальной целью создания технологии блокчейн не было устранение единых точек отказа?Инцидент с Goldsky обнажил тревожный факт: хотя сам блокчейн максимально децентрализован, инфраструктура, используемая приложениями, построенными поверх него, зачастую содержит множество централизованных сервисов.
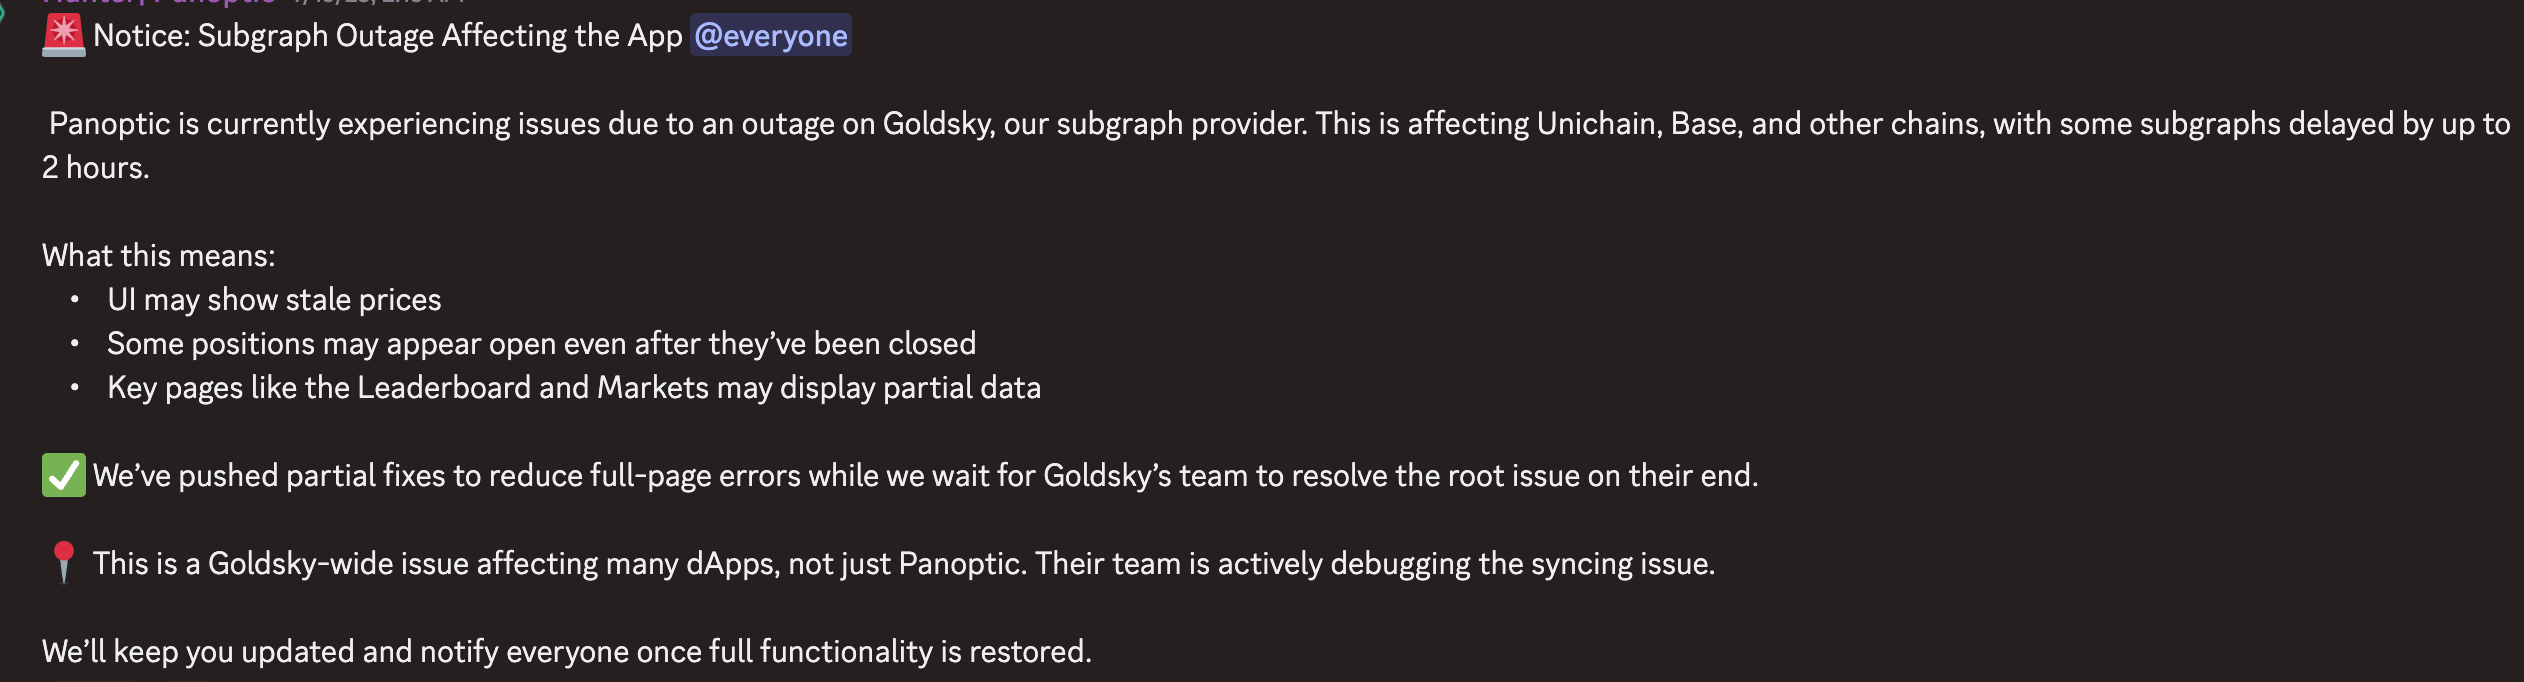
Причиной этого является то, что индексация и поиск блокчейн-данных относятся к цифровым общественным благам «неконкурентного и неисключительного» типа. Пользователи зачастую ожидают бесплатного доступа или крайне низких тарифов, но за этим стоят постоянные высокие затраты на оборудование, хранилище, пропускную способность и персонал для эксплуатации. Без устойчивой модели монетизации формируется концентрация рынка по принципу «победитель получает всё»: достаточно одному поставщику услуг получить опережающее преимущество в скорости и капитале, чтобы разработчики начали направлять весь трафик запросов к нему, вновь создавая единую точку зависимости. Проекты вроде Gitcoin неоднократно подчеркивали, что «open source инфраструктура создает ценность в миллиарды долларов, но авторы часто не могут покрыть ею ипотеку».
Это предупреждает нас: децентрализованному миру остро необходимо повысить разнообразие Web3-инфраструктуры через финансирование общественных благ, механизмы перераспределения или инициативы, движимые сообществом, иначе проблема централизации усугубится. Мы призываем разработчиков DApp создавать продукты с приоритетом локальности (local-first), а также просим техническое сообщество учитывать возможность отказа служб поиска данных при проектировании DApp, чтобы пользователи могли взаимодействовать с проектами даже при отсутствии инфраструктуры поиска данных.
2. Откуда берутся данные, которые вы видите в DApp?
Чтобы понять причины подобных инцидентов, как со сбоем Goldsky, нам необходимо глубже разобраться в механике работы DApp «за кулисами». Для обычного пользователя DApp обычно состоит всего из двух частей: смарт-контрактов в блокчейне и фронтенд-страниц. Большинство пользователей уже привыкли использовать такие инструменты, как Etherscan, для отслеживания статуса транзакций в блокчейне, получать необходимую информацию на фронтенде и инициировать транзакции во взаимодействии с контрактами именно через него.Но откуда же на самом деле берется та информация, которая отображается для пользователя на фронтенде?
Незаменимая служба поиска данных
Предположим, вы разрабатываете протокол кредитования, который должен отображать позиции пользователей, а также состояние маржи и задолженности по каждой позиции. Примитивная идея заключается в том, чтобы фронтенд напрямую считывал эти данные из блокчейна. Однако на практике контракты протоколов кредитования не позволяют адресам пользователей напрямую запрашивать данные о позициях; вместо этого они предоставляют функции для получения конкретных данных позиции по её ID. Поэтому, если мы хотим отобразить положение пользователя на фронтенде, нам необходимо сканировать все позиции в системе, чтобы найти те, которые принадлежат данному пользователю. Это похоже на требование вручную искать определенную информацию среди миллионов страниц бухгалтерских книг — технически возможно, но крайне медленно и неэффективно. Фронтенду практически невозможно выполнить этот процесс поиска; даже для крупных DeFi-проектов выполнение задач по сбору данных непосредственно на сервере с помощью локального узла может занимать часы.
Следовательно, нам необходимо внедрить инфраструктуру для ускорения доступа к данным. Именно такие услуги индексации данных предоставляют компании, такие как Goldsky. На рисунке ниже показано, какие типы данных могут обеспечивать службы индексации приложений.
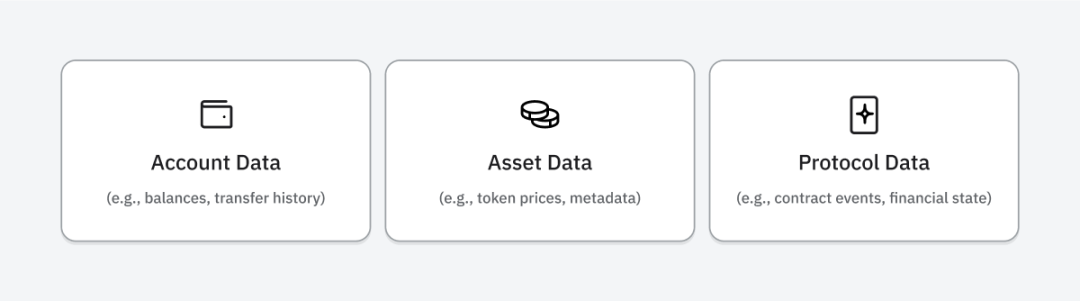
Здесь у некоторых читателей может возникнуть вопрос: почему в экосистеме Ethereum, кажется, существует децентрализованная платформа поиска данных The Graph, как она связана с Goldsky и почему многие проекты DeFi используют Goldsky в качестве провайдера данных, несмотря на более высокую децентрализацию The Graph?
Взаимосвязь между The Graph/Goldsky и Subgraphs
Чтобы ответить на эти вопросы, сначала следует ознакомиться с некоторыми техническими концепциями.
-
Subgraph представляет собой фреймворк для разработки. Разработчики могут использовать его для написания кода, который считывает и агрегирует данные из блокчейна, а затем предоставляет методы для вывода этих данных на фронтенд.
-
The Graph — одна из ранних децентрализованных платформ поиска данных. Она разработала фреймворк Subgraphs, написанный на AssemblyScript. Разработчики могут использовать этот фреймворк для записи программ, которые фиксируют события контрактов и записывают их в базу данных, после чего пользователи могут считывать эти данные с помощью методов GraphQL или напрямую через SQL-код.
-
Обычно провайдеров услуг, запускающих Subgraphs, называют операторами Subgraphs. И The Graph, и Goldsky фактически являются управляющими платформами для Subgraphs. Поскольку Subgraph — это лишь фреймворк, написанное на нем приложение должно выполняться на сервере. Как видно в документации Goldsky:
У некоторых читателей может возникнуть вопрос: почему для одного Subgraph существует множество операторов?
Дело в том, что фреймворк Subgraph лишь определяет, как именно данные должны считываться из блоков и записываться в базу данных.
Он не регламентирует, как данные поступают в программу Subgraph и в какую именно базу данных будут записаны конечные результаты; эту часть реализации каждый оператор Subgraph выполняет самостоятельно.
Как правило, операторы Subgraph модифицируют узлы для достижения большей скорости, а различные операторы (например, The Graph и Goldsky) применяют разные стратегии и технические решения.
The Graph в настоящее время использует технологическое решение Firehouse. Благодаря ему скорость поиска данных стала значительно выше по сравнению с прошлым. Goldsky, напротив, не раскрывает исходный код своей основной программы, необходимой для выполнения Subgraphs.
Как упоминалось выше, The Graph представляет собой децентрализованную платформу поиска данных. Возьмем в пример подграф Uniswap v3 subgraph: можно увидеть множество операторов, обеспечивающих поиск данных для Uniswap v3. Таким образом, The Graph можно рассматривать как интегрированную платформу операторов Subgraphs. Пользователь может отправить свой написанный код Subgraph на платформу The Graph, где внутренние операторы помогут выполнить поиск данных.
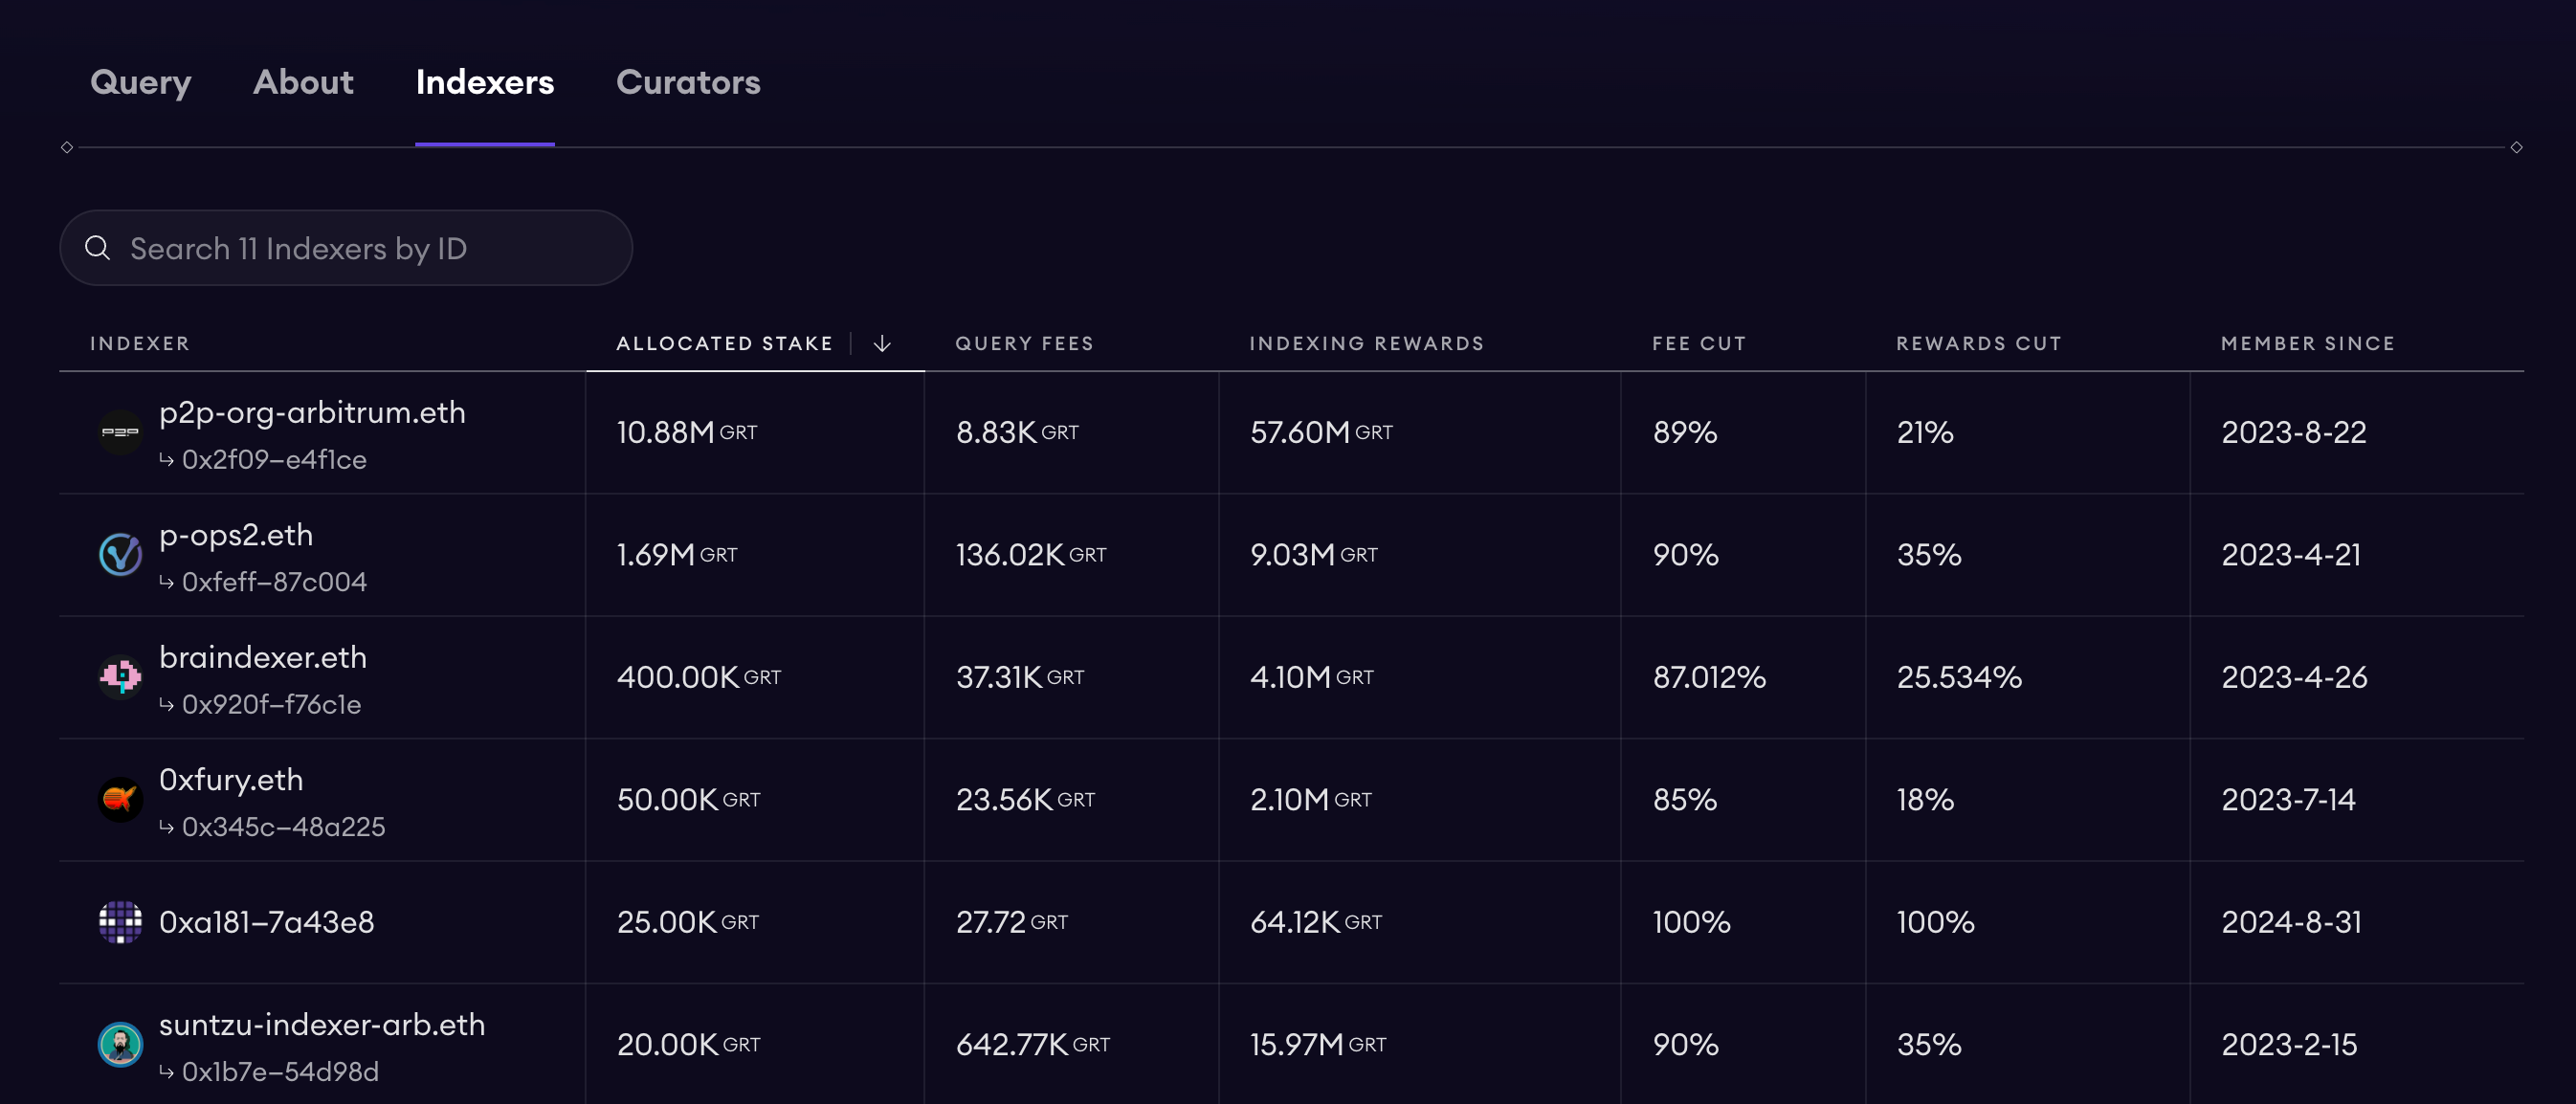
Модель ценообразования Goldsky
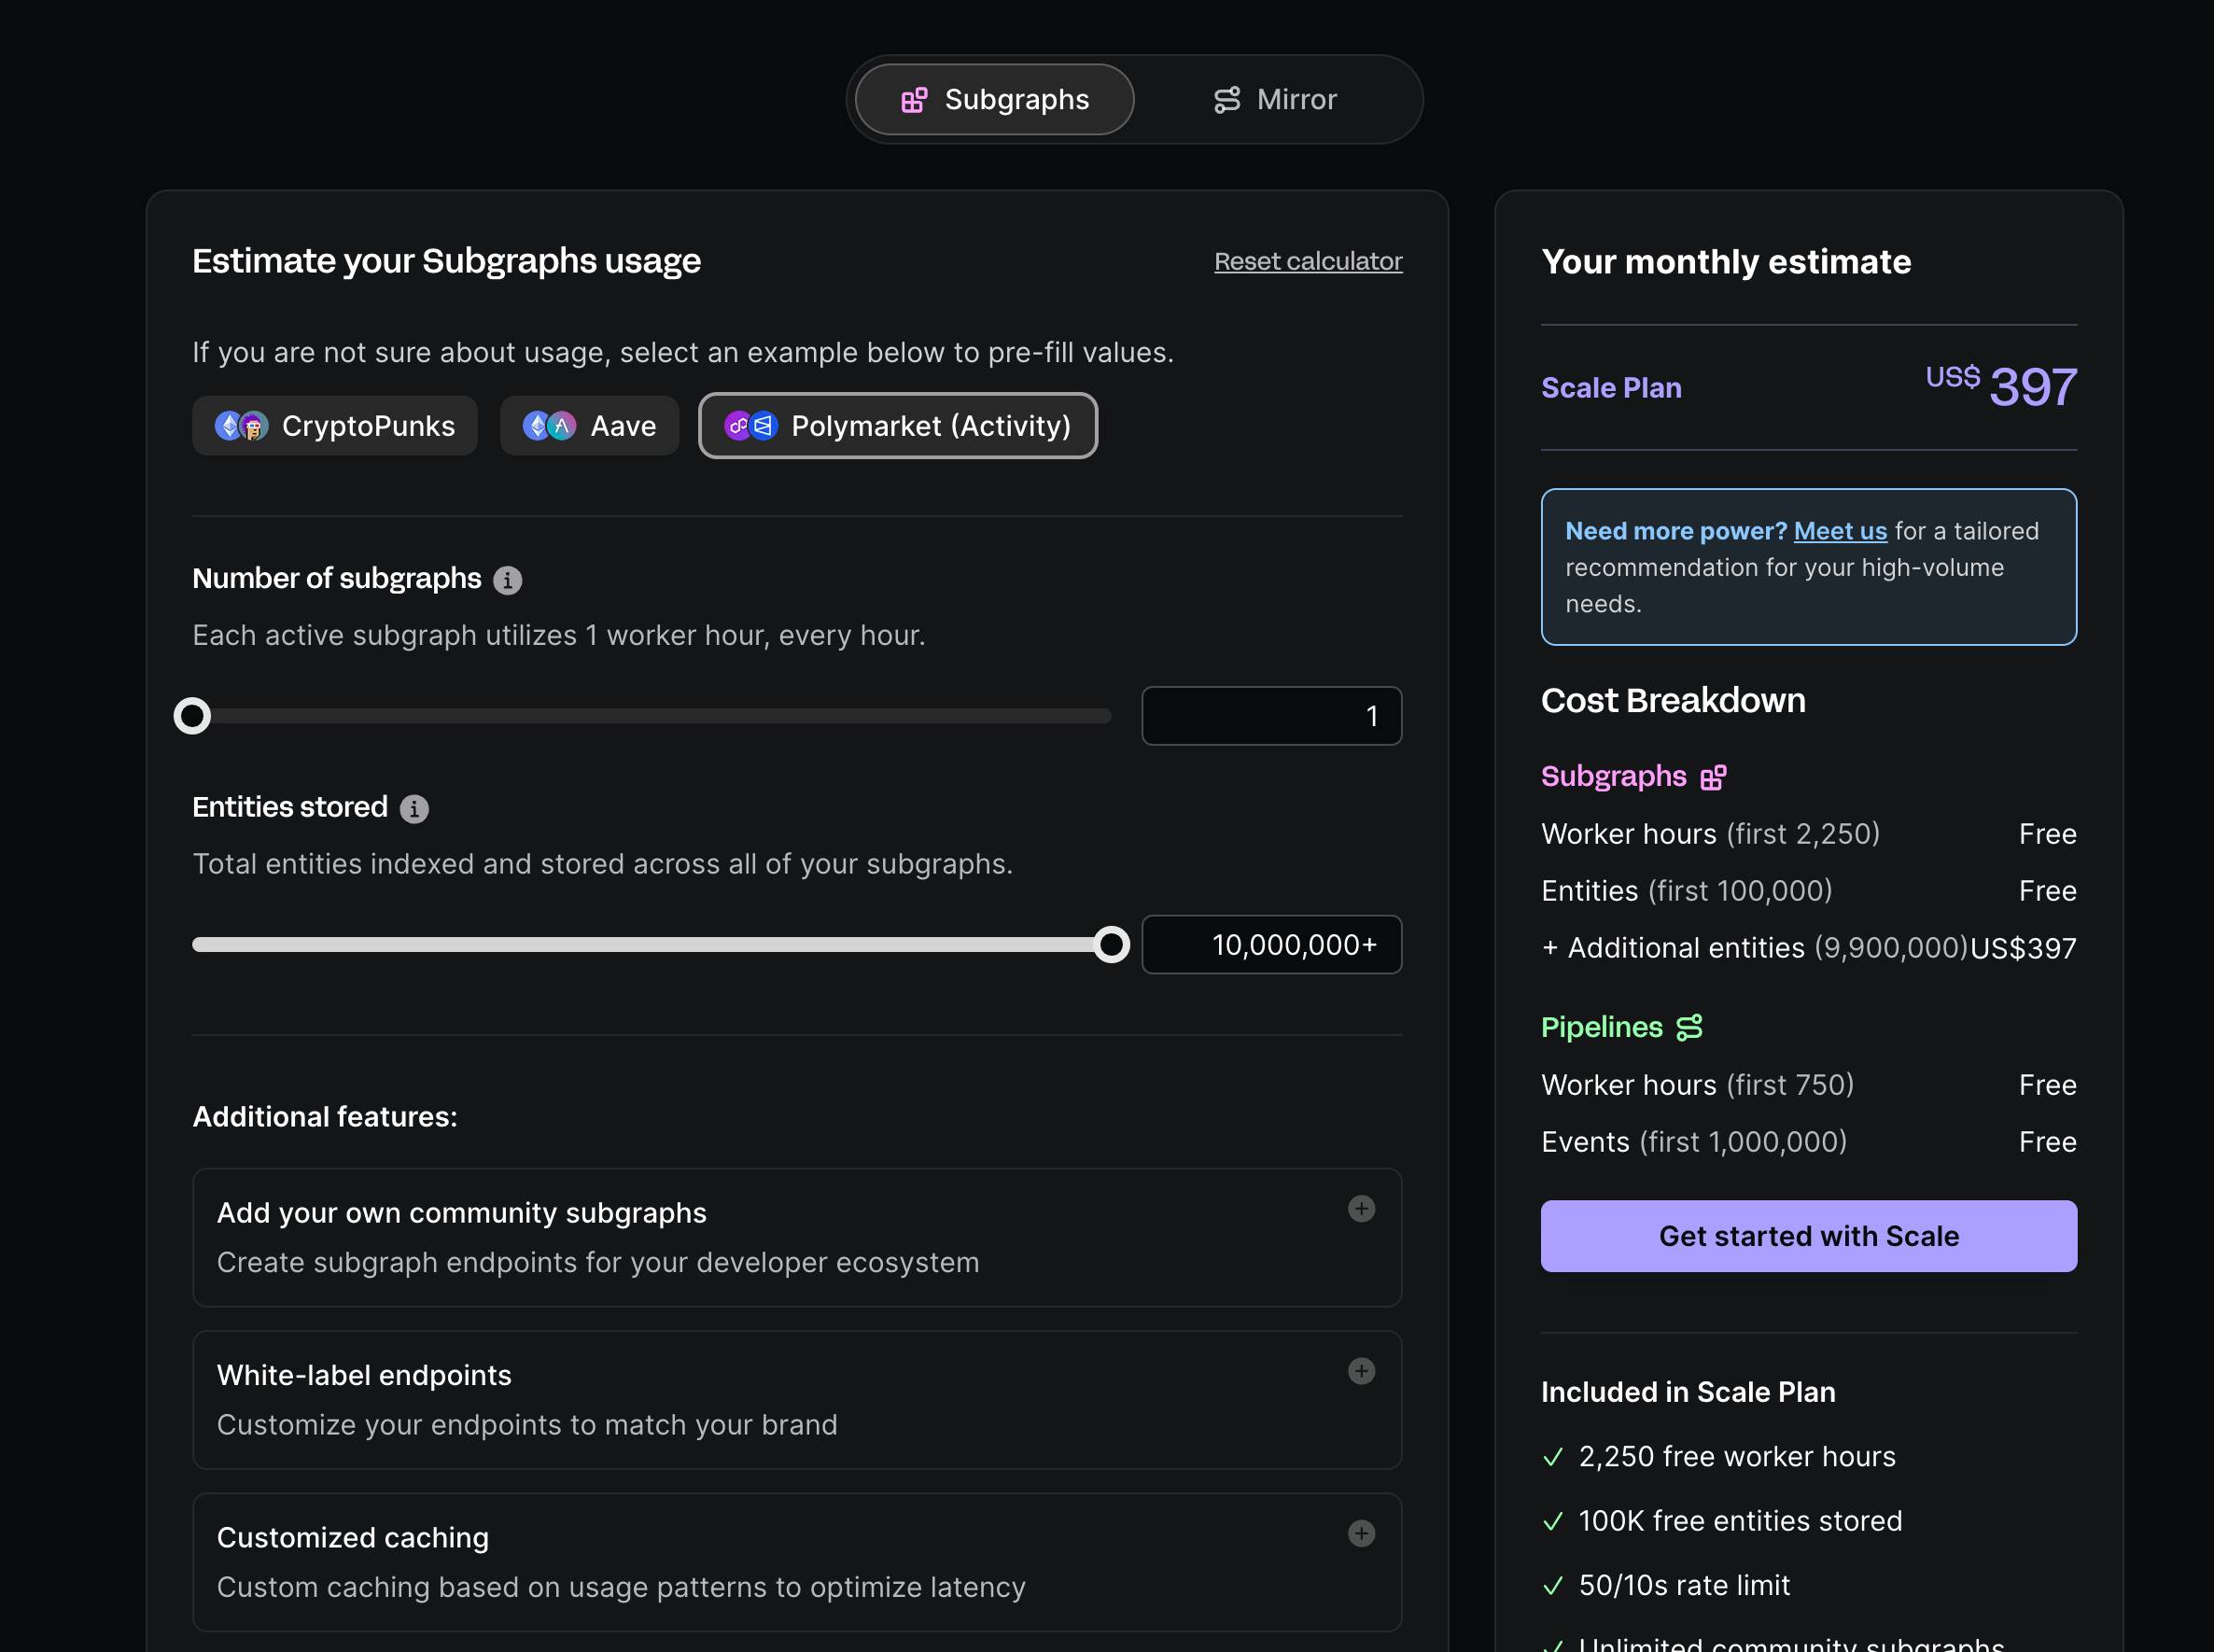
Для централизованной платформы, такой как Goldsky, используется простая модель тарификации на основе потребляемых ресурсов. Это наиболее распространенный способ ценообразования на интернет-платформах класса SaaS, знакомый большинству технических специалистов. Калькулятор цен Goldsky показан на рисунке ниже:
Модель ценообразования The Graph
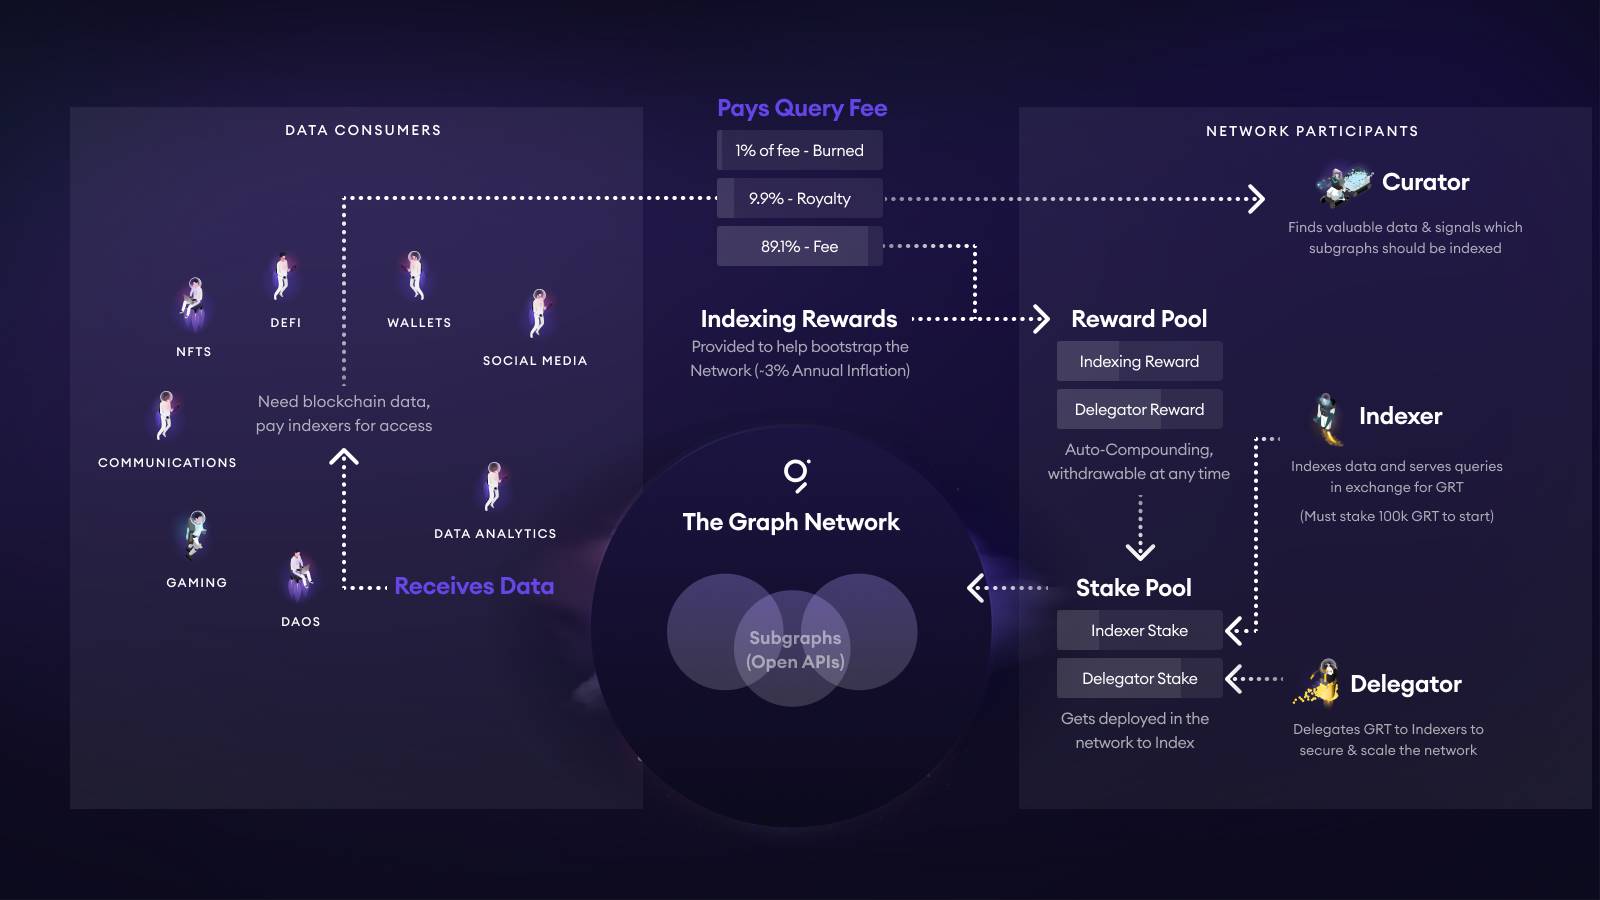
The Graph предлагает совершенно иную систему платежей, отличающуюся от обычных моделей тарификации. Она тесно связана с токеномикой GRT. Общая токеномика GRT представлена на рисунке ниже:
-
Каждый раз, когда DApp или кошелек отправляет запрос к какому-либо подграфу, плата за запрос автоматически распределяется: 1% сжигается, около 10% поступает в крьюторский фонд данного подграфа (крьютору/разработчику), а остальные ≈ 89% выплачиваются индексерам и делегаторам, предоставляющим вычислительные мощности, в соответствии с механизмом экспоненциальных выплат.
-
Индизеры должны сначала залостить ≥ 100 тыс. GRT, чтобы запуститься; в случае возврата некорректных данных они подвергаются штрафу (слишингу). Делегаторы направляют свои GRT индексерам и пропорционально получают основную долю этих 89%.
-
Крьюторы (обычно разработчики) залостируют GRT с помощью сигнала на кривой своего Subgraph. Чем выше значение сигнала, тем больше вероятность привлечения индексеров для выделения ресурсов. По опыту сообщества, самостоятельное выделение 5 k–10 k GRT гарантирует выполнение заказа несколькими индексерами. Одновременно кураторы получают те самые 10% роялти.
Плата за запросы по запросу в The Graph:
Регистрация ключа API во внутреннем интерфейсе The Graph и использование этого ключа для запроса данных, обрабатываемых операторами внутри The Graph. Эти запросы оплачиваются по количеству вызовов. Разработчикам необходимо предварительно внести определенное количество токенов GRT на платформу в качестве оплаты за API-запросы.
Плата за заложенный сигнал (Signal) в The Graph:
Для тех, кто развертывает Subgraph, требуется помощь операторов платформы The Graph в поиске данных. В соответствии с упомянутой схемой распределения доходов, им нужно сообщить остальным участникам, что их сервис запросов лучше и обеспечит больше прибыли, для чего необходимо залостить GRT. Это похоже на рекламу и обеспечение собственной надежности, чтобы привлечь других участников.
Во время тестирования разработчик может бесплатно развернуть Subgraph на платформе The Graph, при этом официальная команда The Graph поможет с некоторыми запросами данных, предоставив бесплатный лимит для тестирования, который нельзя использовать в продакшене. Если разработчик считает, что Subgraph хорошо работает в тестовой среде официальной платформы The Graph, он может опубликовать его в публичной сети для ожидания участия других операторов в поиске. Разработчик не может просто так заплатить конкретному оператору за гарантированный поиск; вместо этого он заставляет несколько операторов конкурировать за предоставление услуг, избегая образования единой точки отказа. Этот процесс требует проведения операций по кюрированию (Curating), также называемых операциями Signal, с использованием токенов GRT для собственного развернутого Subgraph, то есть разработчик залестирует определенное количество GRT в свой Subgraph. Однако только когда объем залогированных GRT достигнет определенного уровня (по предыдущим консультациям это 10 000 GRT) операторы начнут участвовать в поиске данных по этому Subgraph.
Ужасный опыт тарификации ставит в тупик разработчиков и традиционных бухгалтеров
Для большинства разработчиков проектов использование The Graph на самом деле довольно хлопотно. Покупка токена GRT для проекта Web3 относительно проста, но этап кюрирования (Curating) развернутого Subgraph и ожидание подключения операторов является очень неэффективным环节. Этот этап, как минимум, имеет две проблемы:
-
Неопределенность объема залога GRT и времени, необходимого для привлечения операторов. Когда я ранее развертывал Subgraph, я напрямую консультировал амбассадора The Graph для определения суммы залога, однако для большинства разработчиков получить эти данные непросто. Кроме того, даже после размещения достаточного количества GRT операторам требуется некоторое время для начала поиска.
-
Сложность учета расходов и бухгалтерской отчетности. Поскольку The Graph использует механизм токеномики для определения структуры тарифов, это делает расчет затрат сложным для большинства разработчиков. Более практическая проблема заключается в том, что если компания захочет провести бухгалтерский учет этих расходов, бухгалтеры, вероятно, тоже не поймут структуру данной статьи расходов.
«Хорошо, но централизация все же удобнее?»
Очевидно, что для большинства разработчиков прямой выбор Goldsky является более простым решением: модель тарификации понятна всем, а оплата обычно означает немедленную готовность сервиса, что значительно снижает неопределенность. Это также приводит к ситуации зависимости от единого продукта в сфере индексации и поиска блокчейн-данных.
Очевидно, сложная токеномика GRT влияет на широкое распространение The Graph. Токеномика может быть сложной, но очевидно, что эта сложность не должна выставляться напоказ пользователям. Например, механизм залога для кюрирования GRT не должен быть виден обычным пользователям; гораздо лучшим решением для The Graph было бы предоставление простого упрощенного интерфейса оплаты.
Приведенная выше критика The Graph не является исключительно моей точкой зрения. Известный инженер смарт-контрактов и основатель проекта Sablier Пол Разван Берг также выражал схожую позицию в твите. В публикации отмечается, что пользовательский опыт публикации Subgraphs и тарификации GRT является крайне неудачным.
3. Существующие альтернативные решения
Вопрос устранения единой точки отказа для поиска данных частично был затронут ранее: разработчикам стоит рассмотреть возможность использования сервиса The Graph, хотя процесс будет довольно сложным, требуя покупки токенов GRT для кюрирования залога и оплаты API-запросов.
В настоящее время в экосистеме EVM существует множество инструментов для поиска данных. Подробнее можно ознакомиться в статье Dune «The State of EVM Indexing» или в сводке «EVM 数据检索软件汇总» от rindexer. Еще одно свежее обсуждение можно найти в данном твите 此推文.
В этой статье мы не будем подробно обсуждать точные причины сбоя Goldsky. Согласно официальному отчету, сама компания знает причину, но планирует раскрыть детали только корпоративным клиентам. Это означает, что третьи лица пока не могут знать, какой именно сбой произошел. Судя по содержанию отчета, вероятно, возникли проблемы при записи обработанных данных в базу данных. В кратком отчете Goldsky указывает на невозможность доступа к базе данных до восстановления сотрудничества с AWS.
В данном разделе мы преимущественно представим другие альтернативные решения:
-
Ponder — это простой инструмент поиска данных с хорошим UX и легкой настройкой. Разработчики могут самостоятельно арендовать сервер и развернуть его.
-
Local-first (приоритет локальности) — интересная концепция разработки, призывающая разработчиков обеспечивать хороший пользовательский опыт даже при отсутствии сетевого соединения. При наличии блокчейна мы можем немного смягчить ограничения local-first, гарантируя отличный пользовательский опыт всякий раз, когда появляется подключение к блокчейну.
Ponder
Почему в данном тексте рекомендуется использовать ponder вместо другого ПО? Конкретные причины заключаются в следующем:
-
Отсутствие зависимости от вендора. Initially ponder был создан независимым разработчиком, поэтому по сравнению с другими коммерческими инструментами поиска данных ponder требует от пользователя лишь указания URL Ethereum RPC и ссылки на базу данных postgres.
-
Отличный опыт разработки. Я неоднократно использовал ponder в своих проектах. Поскольку ponder написан на TypeScript, а основная библиотека опирается на viem, процесс разработки чрезвычайно удобен.
-
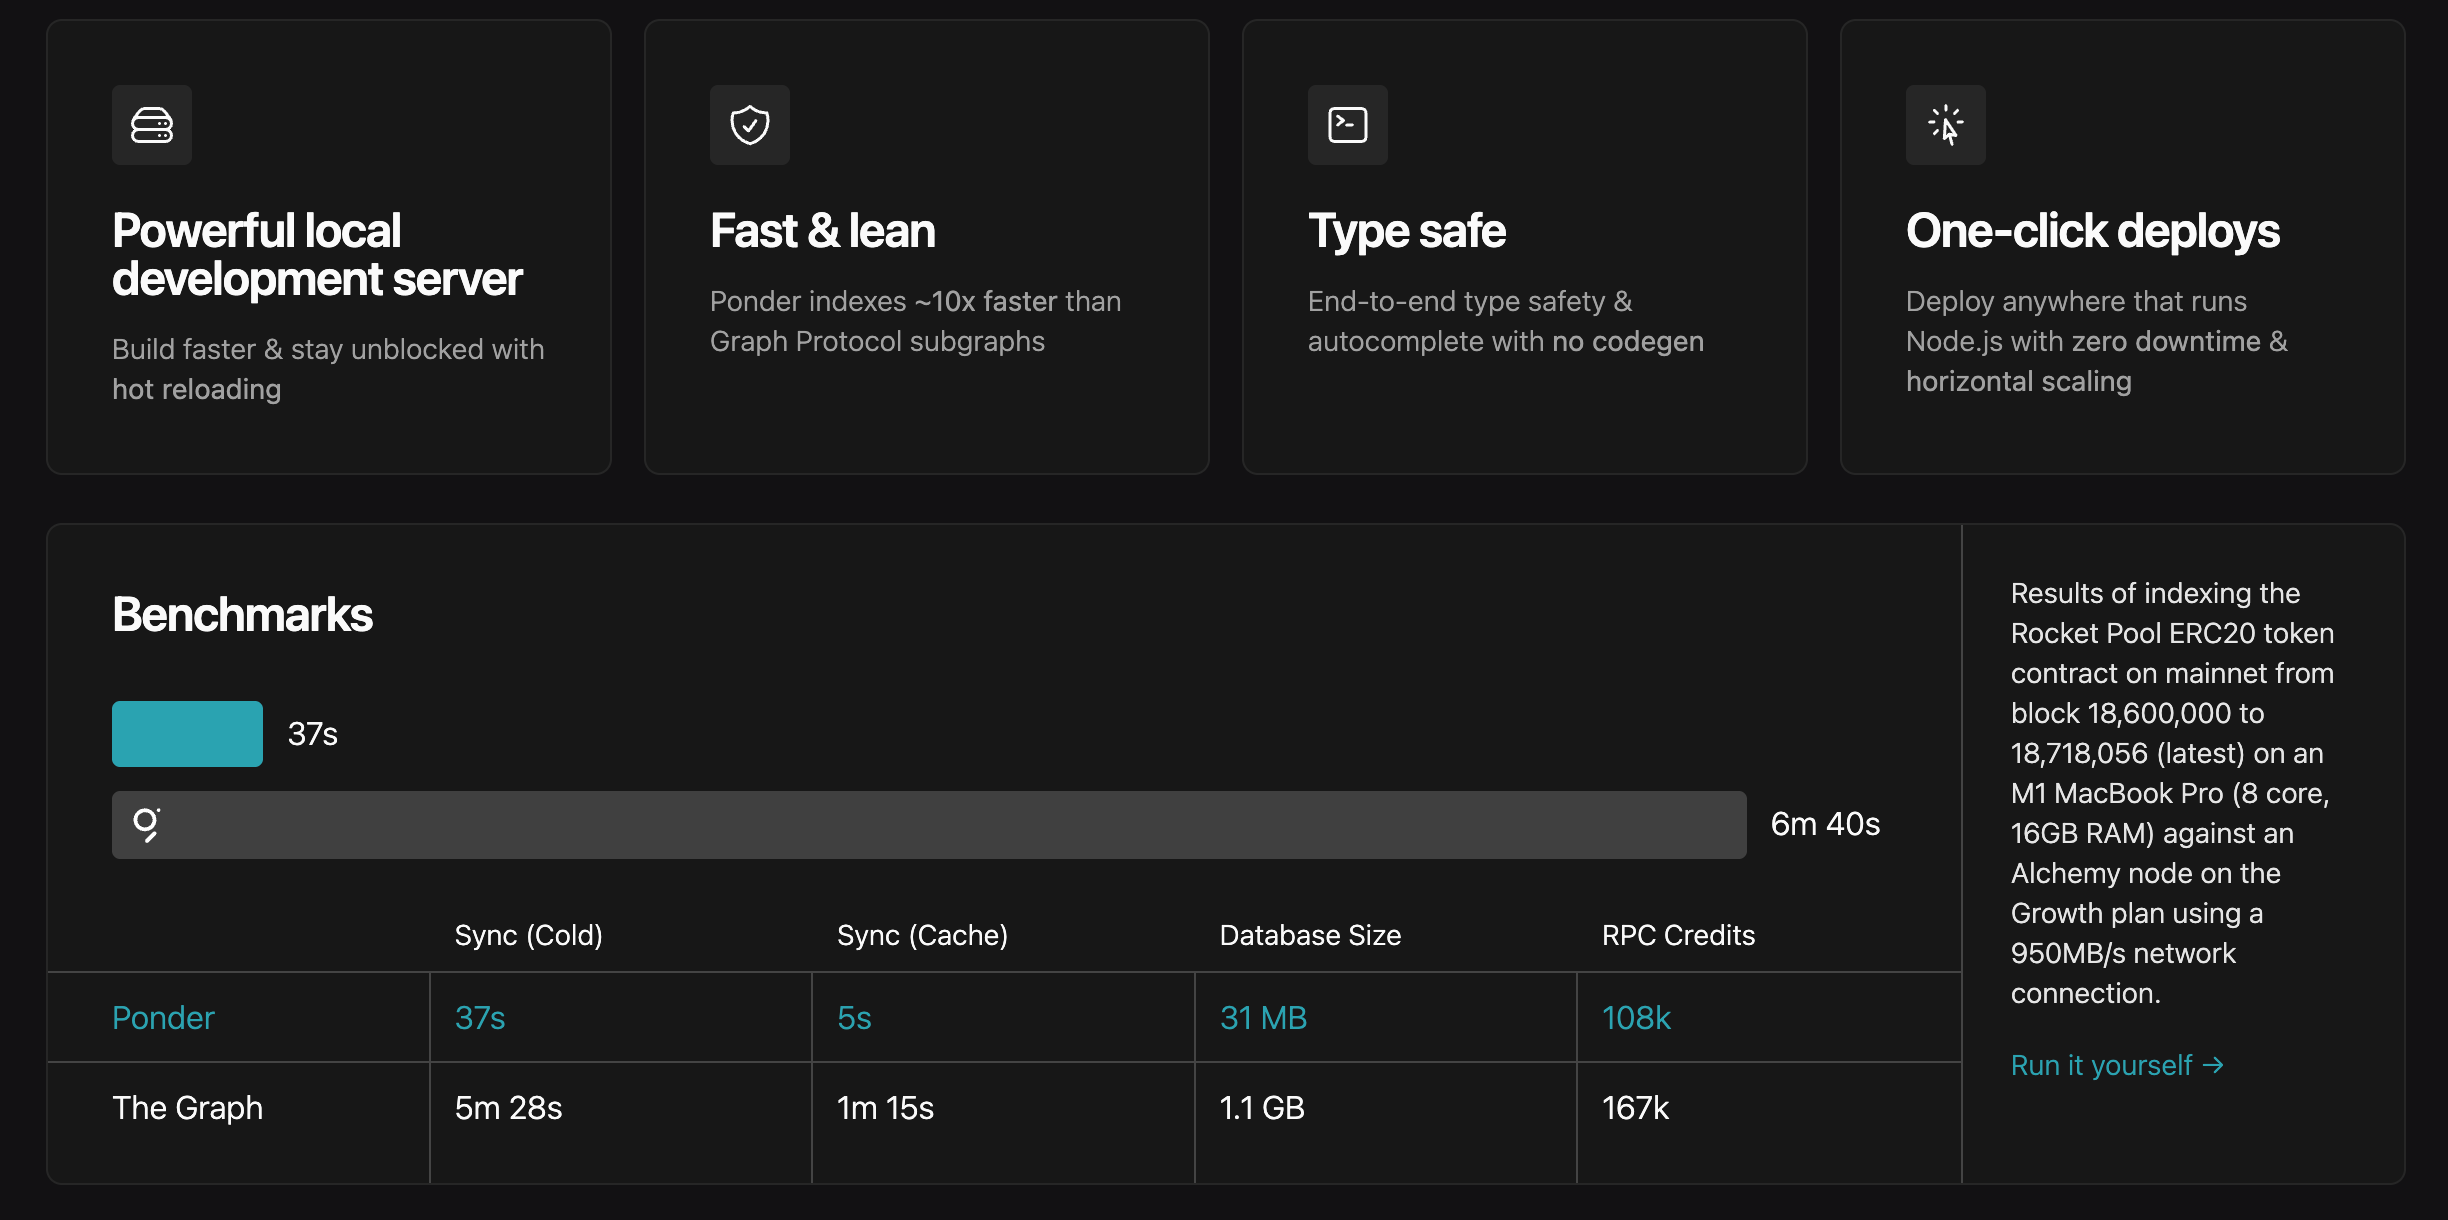
Более высокая производительность.
Разумеется, существуют и определенные недостатки. Платформа ponder сейчас находится в стадии активной разработки, и разработчики могут столкнуться с ситуациями, когда крупное обновление ломает обратную совместимость и останавливает работу предыдущих проектов. Учитывая, что эта статья не является техническим руководством, детали разработки ponder мы затрагивать не будем. Технически подкованные читатели могут самостоятельно ознакомиться с документацией.
Более интересная деталь заключается в том, что ponder начинает частичную коммерциализацию, и путь этой коммерциализации отлично согласуется с теорией «сегментации» (изоляции), обсуждавшейся в предыдущей статье.
Здесь мы кратко представим «теорию сегментации». Мы считаем, что общественный характер общественных благ позволяет обслуживать неограниченное количество пользователей, поэтому любая плата за пользование ими приведет к отказу части пользователей, что не максимизирует общественную пользу (в экономических терминах это означает выход из состояния «парето-оптимума»). Теоретически можно устанавливать различную цену для каждого, но затраты на такое дифференцированное ценообразование с высокой вероятностью превысят полученную дополнительную прибыль. Именно поэтому общественные блага предоставляются бесплатно: не потому, что они изначально бесплатны, а потому, что любые фиксированные сборы наносят ущерб общественному благу, а дешевый метод индивидуального ценообразования на сегодняшний день отсутствует. Теория сегментации предлагает метод ценообразования внутри общественных благ путем изоляции группы гомогенных пользователей для взимания с них платы. Таким образом, теория не запрещает свободный доступ ко всем, но предлагает метод извлечения дохода с конкретной группы.
Ponder использует похожий подход, основанный на теории сегментации:
-
Для развертывания ponder по-прежнему требуются определенные знания: в процессе установки разработчику необходимо предоставить внешние зависимости, такие как RPC, база данных и т. д.
-
После завершения развертывания разработчик должен постоянно поддерживать работу приложения ponder, например, используя систему proxy для балансировки нагрузки, чтобы избежать влияния запросов данных на процессы фонового извлечения данных из блокчейна. Все это может показаться слегка сложным для обычных разработчиков.
-
В настоящее время ponder проходит закрытое тестирование полностью автоматизированной услуги развертывания marble. Пользователям достаточно передать код на платформу для автоматического развертывания.
Очевидно, это применение теории сегментации: разработчики, нежелающие самостоятельно поддерживать сервис ponder, оказываются в отдельной группе, которой можно предложить упрощенное развертывание за плату. Внедрение платформы marble никак не мешает остальным разработчикам бесплатно использовать фреймворк ponder и развертывать его самостоятельно.
Кто является целевой аудиторией ponder и Goldsky?
-
Общественное благо без зависимости от вендора, такое как ponder, более популярно при разработке небольших проектов по сравнению с услугами поиска данных, зависящими от поставщиков.
-
Разработчики, ведущие крупные проекты, не всегда выбирают фреймворк ponder, поскольку масштабные проекты часто требуют высокой производительности сервисов поиска данных, которую провайдеры вроде Goldsky обеспечивают гарантированной доступностью.
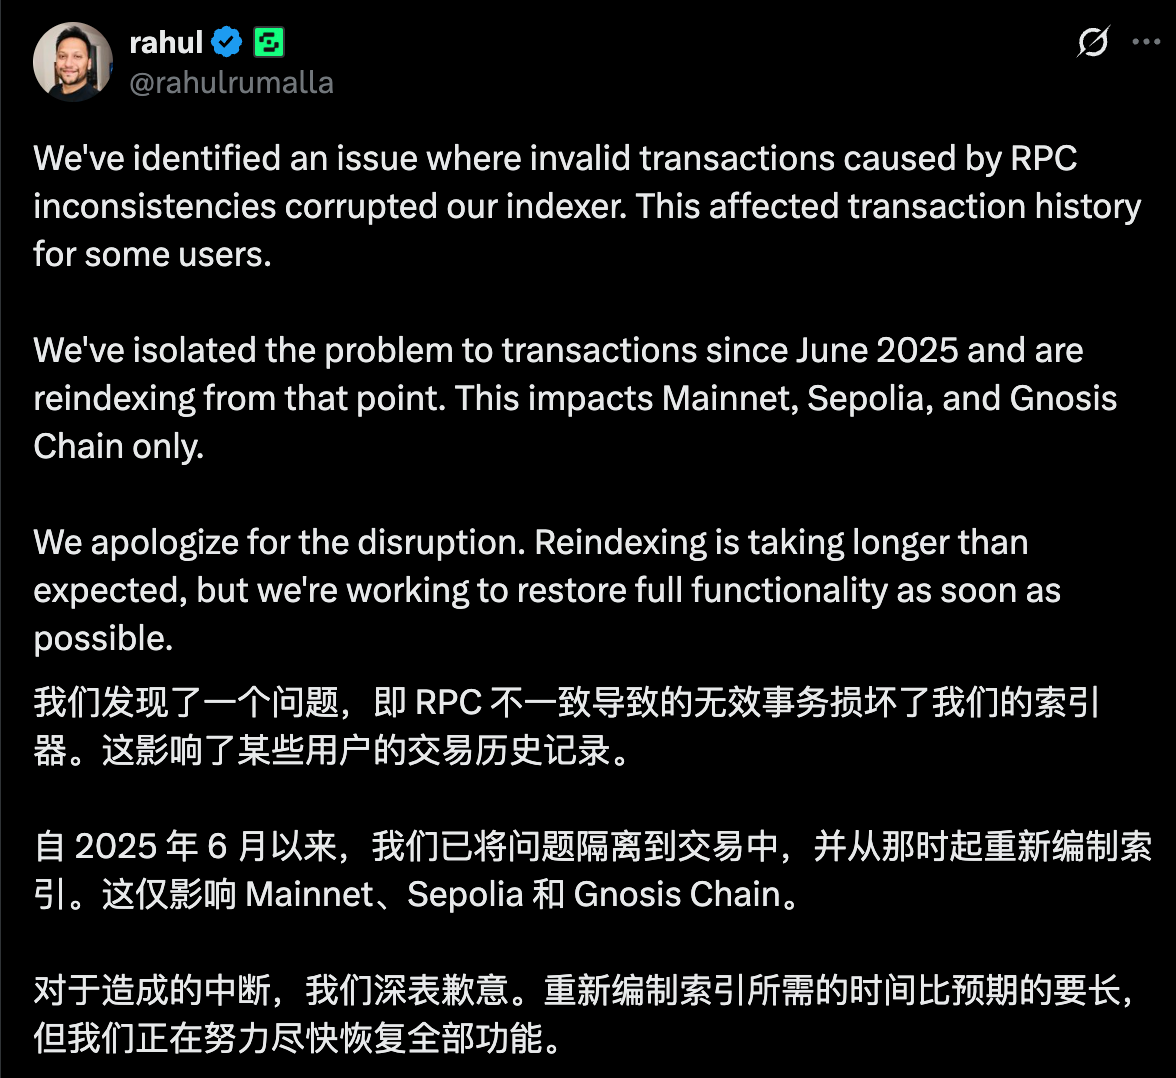
Оба варианта имеют свои риски. Исходя из недавнего инцидента с Goldsky, разработчикам лучше поддерживать собственный сервис ponder для оперативного реагирования на возможные сбои сторонних сервисов. Также при использовании ponder следует учитывать проблему достоверности данных, возвращаемых RPC. Недавно Safe сообщил о случае сбоя индексатора из-за некорректных данных от RPC. Хотя прямых доказательств связи инцидента с Goldsky с ошибочным возвратом данных от RPC нет, автор подозревает, что Goldsky мог столкнуться с аналогичной проблемой.
Концепция разработки Local-first
Local-first (приоритет локальности) — тема, активно обсуждавшаяся последние годы. Проще говоря, концепция local-first требует от программного обеспечения следующих возможностей:
-
Работа офлайн
-
Синхронизация между клиентами
В настоящее время большинство технических дискуссий о local-first связаны с технологией CRDT (Conflict-free Replicated Data Type). CRDT представляет собой формат данных без конфликтов, позволяющий автоматически объединять конфликты при многопользовательском редактировании для сохранения целостности данных. Грубо говоря, CRDT можно рассматривать как тип данных со встроенным простым консенсус-механизмом, который в распределенной среде гарантирует целостность и согласованность данных.
Однако в разработке блокчейнов мы можем смягчить указанные выше требования local-first к программному обеспечению. Нам достаточно потребовать, чтобы пользователи сохраняли минимально допустимую функциональность на фронтенде даже при отсутствии предоставленных разработчиками проекта данных бэкенд-индекса. При этом требование local-first к синхронизации между клиентами фактически уже решено самой блокчейн-технологией.
В контексте DApp концепция local-first реализуется следующим образом:
-
Кэширование важных данных: фронтенд должен кэшировать важные данные пользователя, такие как баланс, информация о позициях и т. д. Даже если служба поиска недоступна, пользователь сможет видеть последнее известное состояние.
-
Дизайн функций резервирования (graceful degradation): когда сервис поиска бэкенда недоступен, DApp может предоставлять базовые функции. Например, при отказе службы поиска данных некоторые данные можно считывать напрямую через RPC, чтобы пользователь видел актуальную информацию имеющихся данных.
Такой подход к разработке DApp по принципу local-first значительно повышает устойчивость приложений, предотвращая полную неработоспособность после сбоя сервиса поиска данных. Если не обращать внимания на удобство, лучшей реализацией local-first будет запуск узла пользователем локально с последующим поиском данных через подобные инструменты, как trueblocks. Некоторые обсуждения децентрализованного или локального поиска данных можно найти в твите Literally no one cares about decentralized frontends and indexers.
4. Заключение
Шестичасовой сбой Goldsky послужил серьезным предупреждением для всей экосистемы. Хотя сам блокчейн обладает свойствами децентрализации и устойчивости к единым точкам отказа, экосистема приложений, построенная на его основе, по-прежнему сильно зависит от централизованных инфраструктурных сервисов. Такая зависимость создает системные риски для всей экосистемы.
В данной статье кратко объяснено, почему широко известный сервис поиска данных The Graph в настоящее время не получил массового распространения, с особым акцентом на сложности, порождаемые токеномикой GRT. В завершение рассматриваются способы построения более надежной инфраструктуры поиска данных. Автор призывает разработчиков использовать самодостаточный фреймворк для индексации ponder в качестве варианта быстрого реагирования, а также представляет успешный путь его коммерциализации. Наконец, обсуждается концепция разработки local-first, побуждая создателей приложений, способных функционировать даже при отсутствии служб поиска данных.
На данный момент многие разработчики Web3 осознали проблему единой точки отказа в сервисах поиска данных. GCC надеется, что большее число создателей обратят внимание на данную инфраструктуру и попробуют построить децентрализованные службы поиска или разработать архитектуру, при которой фронтенд DApp сможет функционировать даже без поддержки сервисов поиска данных.