벤치마크 점수 폭등, 실제 테스트 참패, 막 출시된 GPT-6.2가 OpenAI의 약점을 드러내다
저자: 테크노의 왕, GeekPark
종이上面的 성적과 실제 체감 사이의 괴리가 오늘 정점에 달했습니다.
"기본적으로 사용 불가, 추천하지 않음."
OpenAI 신모델 출시 단 8분 만에 실리콘밸리의 유명 기업가 매트 슈머는 소셜 플랫폼에 거침없는 평가 하나를 던졌습니다.
이어서 다수 개발자의 지지 받는 테오 브라운은 장문의 글 ‘왜 내가 GPT-6.2 Astra를 싫어하는가’를 공개했습니다. 최신 모델에 대해 평소 온건하고 인내심 있게 대하던 워튼 스쿨 소속 이선 몰릭 교수도 테스트 후 드문 엄격한 평점을 주며 “매우 불안정하고 기괴하다”고 밝혔고, “GPT-4.5 이후 OpenAI 첨단 모델 출시 중 처음부터 뚜렷한 진전을 보이지 않았다”고 직접 말했습니다.
이는 원래 OpenAI의 멋진 역전공격전이 되어야 마땅했습니다.
베이징 시간 11월 18일 새벽, OpenAI는 공식적으로 차세대 플래그십 GPT-6.2 Astra와 일상 주력 GPT-6.2 Sol을 출시했습니다. 공식 측에서는 Astra의 API 단가를 직접 20% 깎았을 뿐만 아니라, 에이전트부터 연구 개발까지 전방면으로 기록을 새로 쓴 성적을 내놓았습니다.
종이상의 벤치마크 급등이 현업 개발자들의 집단 불만과 부딪히는 순간, 이러한 극단적인 단절감은 오히려 OpenAI가 현재 마주한 가장 생생한 상황을 드러냅니다.
숫자 게임과 컴퓨팅 파워의 숨겨진 함정
공식 포스터와 제3자 종합 랭킹 상위 데이터만 보면, GPT-6.2 두 모델은 분명 강력합니다.
두 모델 모두 105만 컨텍스트 윈도우를 갖췄으며, 최대 입력 길이는 92.2만 토큰, 최대 출력 길이는 12.8만 토큰입니다. 현재는 텍스트 및 이미지 입력과 순수 텍스트 출력만 지원하며, 오디오/비디오 입력과 파인튜닝은 지원하지 않습니다. 가격 정책으로는 9월 초 출시된 GPT-6 Astra를 이어받은 신규 플래그십의 경우 입력 기준 백만 토큰당 8달러, 출력 기준 40달러이며, 캐시드 입력 가격은 무려 60% 삭감된 0.40달러로 조정되었습니다. 9월 DevDay 버전의 GPT-6 Sol을 잇달 GPT-6.2 Sol은 입력 2달러, 출력 10달러를 그대로 유지하고 있습니다.
Artificial Analysis의 v5.0.1 종합 지수 순위에서 GPT-6.2 Astra는 62점으로 총순위 2위로 뛰어올랐으며, 65점의 Claude Fable 5.2에 이어져 60점의 Gemini 4 Carbon과 59점의 Claude Opus 5.5를 앞질렀습니다.
더 매력적인 부분은 단일 작업 비용으로, Astra의 평균 비용은 단 4달러에 불과하며, 이는 Fable 5.2의 26.54달러라는 높은 비용의 고작 15%에 해당하는 수치입니다. 57점을 얻은 Sol은 단일 작업당 고작 1.01달러만 지출하여 파레토 프런티어(Pareto Frontier) 산점도 상에서 왼쪽 위쪽의 가성비 좋은 사분면에 단단히 안착했습니다.
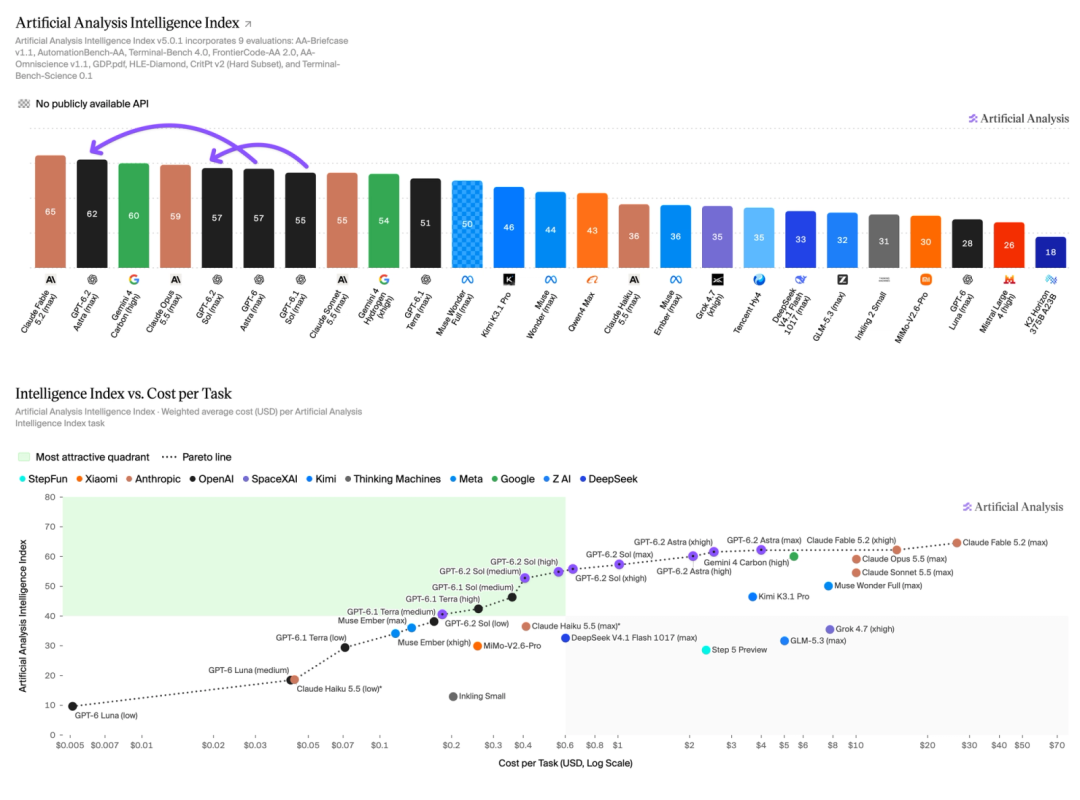
그림: Artificial Analysis Intelligence Index v5.0.1 총점 순위 및 단일 작업 비용 파레토 프런티어 비교|사진 출처: Artificial Analysis
하지만 공식 블로그 페이지를 아래로 스크롤하며 아주 작은 글씨로 적힌 각주들을 꼼꼼히 읽어보면 분위기가 달라지기 시작합니다.
Agents' Last Exam 테스트 결과, OpenAI은 Astra가 최고 78.3%(XHigh 설정, Max 설정은 77.6%)를 기록해 Fable 5.2의 72.8%를 크게 앞섰다고 높게 평가했으나, 각주에는 Fable 5.2가 보조 모델을 사용한 9개 작업은 본 비교에서 배제되었다고 명시되어 있습니다. 더욱 복잡한 점은 공식 관련 이미지에서 Google의 Gemini 4 Carbon이 심층 추론 모드에서 77.4점을 받으며 단일 작업 비용 4.60달러로 Astra의 4.47달러와 사실상 동률을 이루었음에도, 공식 본문에서는 해당 경쟁사에 대한 언급이 전혀 없었다는 것입니다.
벤치마크 점수 집계 기준의 정교한 선별 외에도 API 요금표에는 두 가지 숨겨진 함정이 묻혀 있습니다.
단일 요청의 입력량이 27.2만 토큰을 초과하면 전체 요청의 입력 및 캐시드 입력 단가가 두 배로 올라가고, 출력 단가는 1.5배 곱해져 Astra가 즉시 16달러와 60달러로 상승합니다. 또한 미국 지역 데이터 저장소 전용으로 최대 4.5배까지 속도 향상되는 Ultrafast 모드는 현재 3배 할인 혜택이 적용 중이지만, 2027년 3월 1일부터 두 배인 6배로 인상되면 이때 Astra의 입력·출력 가격은 각각 48달러와 240달러가 됩니다.
개발자의 일상적 경험을 결정짓는 전문 분야 랭킹으로 시선을 돌리면 약점이 훨씬 노골적으로 드러납니다.
Artificial Analysis의 코딩 에이전트 순위에서 GPT-6.2 Astra는 53점대로 발이 묶여 전작과 동률을 유지하며, 58점의 Claude Fable 5.2와 Opus 5.5보다 뒤처지고 55점의 Gemini 4 Carbon에도 밀립니다. 일상의 사용량 대비 효율성을 강조하는 Sol은 오히려 3점 하락한 49점으로 떨어졌으며, 오픈 소스 Kimi K3.1 Pro와 같은 점수대에 머무릅니다. 특히 코드베이스 Q&A 항목에서 무려 14점이나 폭락해 핵심 정보를 쉽게 놓치는 경향이 나타났습니다.
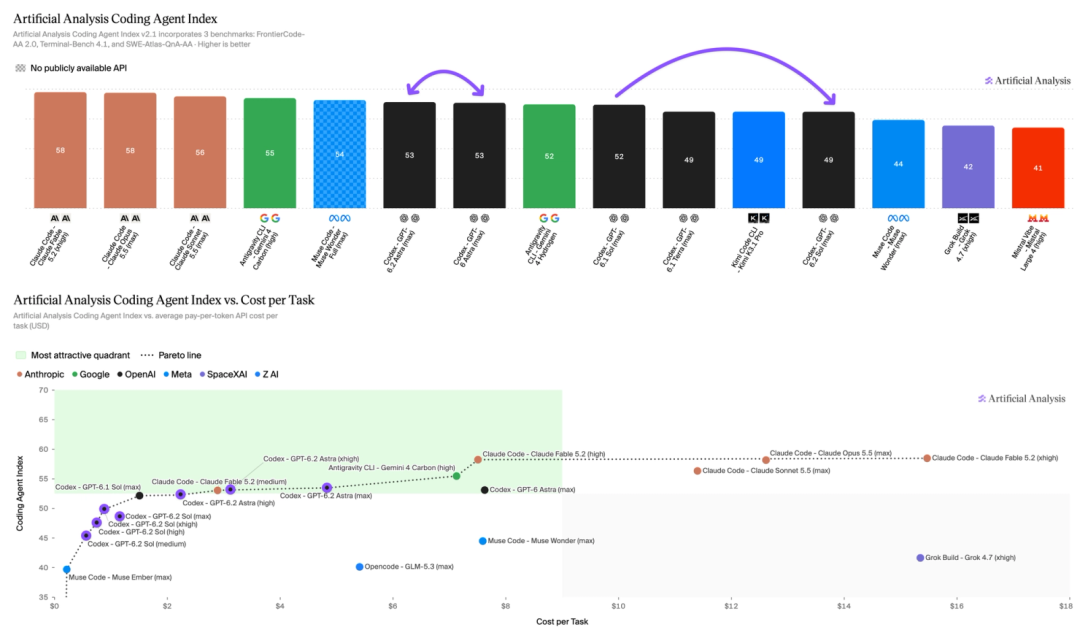
그림: Artificial Analysis Coding Agent Index v2.1 비교: Astra는 53점에서 정체, Sol은 전작 대비 3점 하락|사진 출처: Artificial Analysis
타 권위 기관인 Epoch AI의 테스트에서도 Astra는 비록 Erdős 난제 등 최신 수학 문제 68문제 중 7개를 해결하며 기존 3문제를 깨는 기록을 세웠으나, 보고서에서는 여전히 실제 연구 자동화 작업에서 이전 세대 대비 뚜렷한 발전 없음을 지적하며 과도하게 보수적임을 비판했습니다. Vals 종합 순위에서 Astra는 고작 7위에 머물렀으며, 일반판은 법적 검색 분야에서 심지어 30위로 떨어졌고, 특수 맞춤형 법률판 모델만이 명성을 되찾을 수 있었습니다.
오직 안전 가드를 완전히 해제한 극한의 취약점 찾기와 같이 한정된 상황에만 그것은 공포스러운 성능 한계를 드러냅니다.
DeepBinary가 Windows OS 바이너리 파일 12개를 대상으로 테스트한 결과, Astra는 두 번의 독립 실행에서 평균 348.5개의 고유 버그를 찾아냈으며, 마이크로소프트 뱃지 기준으로 그 가치가 무려 103만 8천 달러에 달했고 API 비용은 단 4,072달러에 불과했습니다. 소형 모델 Sol 또한 840달러의 비용으로 가치 평가액 68만 7천 달러에 해당하는 227개의 취약점을 찾아냈습니다. 이에 비해 가치를 16만 달러 근처에 멈춰둔 Opus 5와 Kimi K3.1은 먼 곳에 뒤에 두고 왔습니다.
특기만 뛰어난 천재
백만 달러 규모 시스템 취약점을 단독으로 찾아낼 수 있는 모델이 왜 일반 프로그래머의 손에선 “기본적으로 사용 불가” 상태가 되었을까? 네티즌들의 현장 체험기를 펼쳐보면 지나치게 특출난 재능을 가진 괴짜를 발견하게 됩니다.
경계가 명확하고 공간 기하학이나 물리 시뮬레이션에 치중된 하드코어 문제가 주어지면, GPT-6.2의 능력 한계는 정말 놀랍습니다.
개발자 토마스 리쿠아르는 이를 활용해 거리 지도와 프랑스 측량 데이터를 결합해 브라우저 위에서 13만 1,000채 이상의 건물을 아우르는 3D 파리 ‘파리 아틀라스(Paris Atlas)’를 1:1로 구현했습니다. 거리 건물과 보행자, 차량 흐름이 모두 포함되어 있으며 스크린샷 피드백을 통해 지속적으로 미세 조정할 수 있습니다.
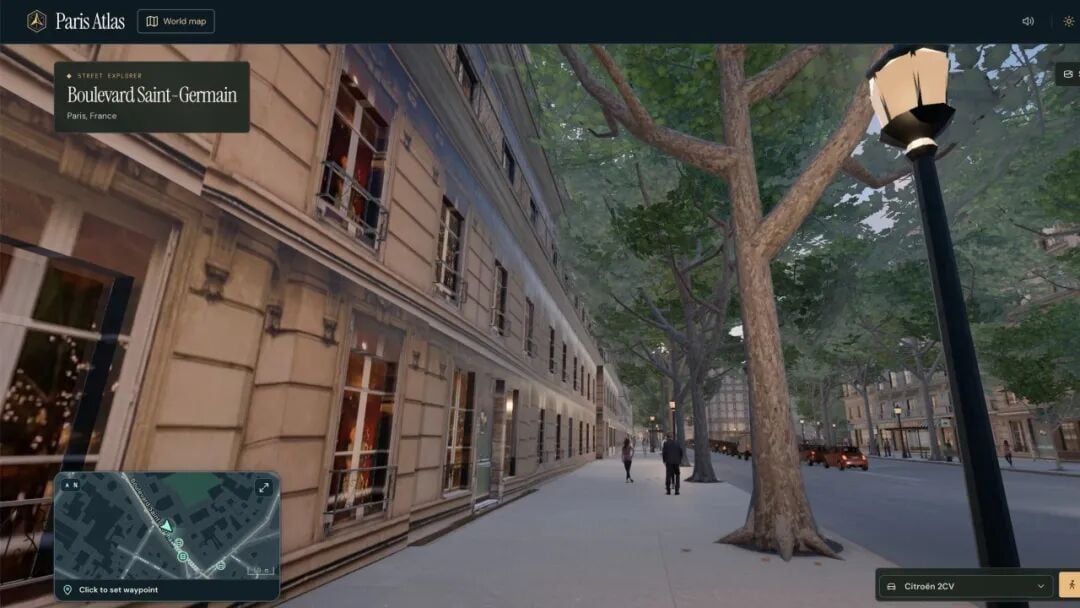
그림: OpenAI 개발자가 GPT-6.2 기반 제작한 1:1 3D 파리 프로젝트 ‘파리 아틀라스’(13만 1천 채 이상 건물 데이터 포함)|사진 출처: TechRadar / OpenAI
OpenAI 공식 데모 영상에서는 Astra가 컨버터블 스포츠카를 자체적으로 3D 모델링하고, Python 물리 솔버를 직접 작성한 뒤 블렌더(Blender) 내에서 언덕길 코너링 서스펜션 동작과 4륜 접지 압력 열지도까지 동시에 렌더링하는 모습을 보여줍니다. 기업측 역시 주목할 만한 성과를 냈는데, Higgsfield는 내부 3D 생성 단일 성공률 73%를 달성했고, 양헤지펀드 리더인 점프 트레이딩(Jump Trading)은 3년간 유지돼온 하드웨어 최적화 기준을 하루 만에 돌파했으며, 하비(Harvey), 레고라(Legora), 클릭업(ClickUp) 등 파트너사들도 토큰 사용을 30~60% 절감했다는 결과를 보고했습니다. 리플릿(Replit)은 Sol 6.2의 속도가 실제 테스트에서 약 3배 가속화됐다는 사실을 확인했습니다.
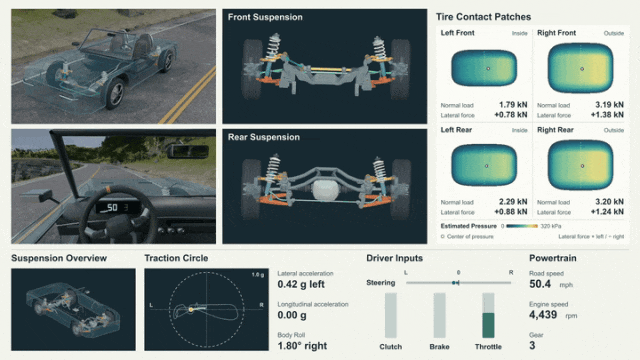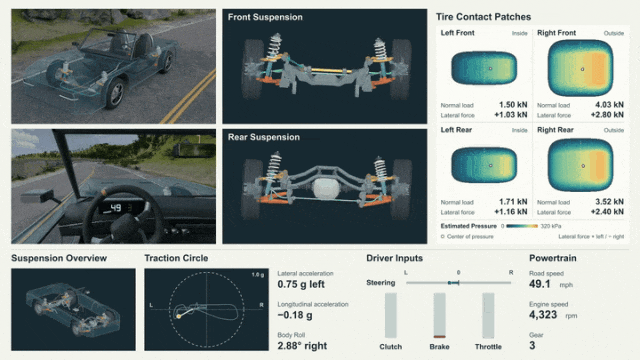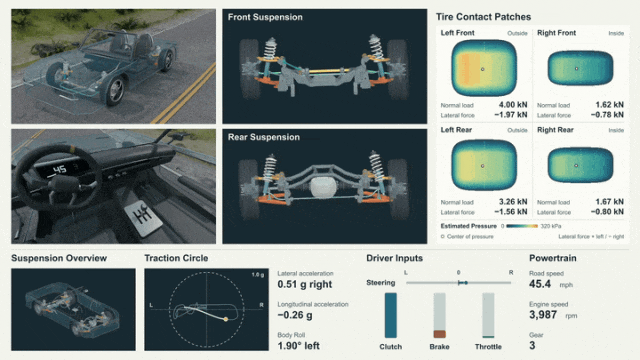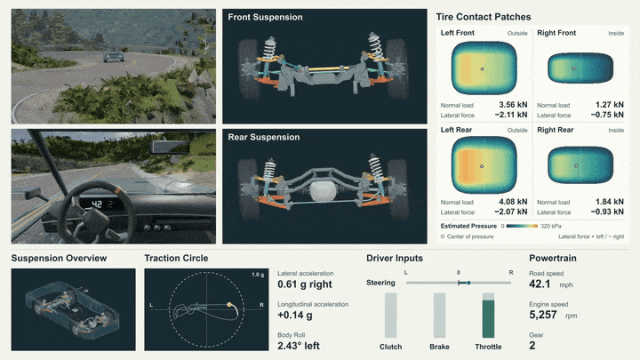
그림: GPT-6.2 Astra가 자체 구축한 3D 스포츠카 및 Python 솔버로 완성된 산악 섀시 역학 및 4륜 접지 압력 시뮬레이션|사진 출처: OpenAI 공식
그림: 하지만 단일 지점 돌파형 데모 상황에서 벗어나 장기간 소통과 다단계 협업이 필요한 실제 소프트웨어 엔지니어링으로 들어가면, GPT-6.2 Astra의 기이한 성격이 사용자를 광기로 몰아넣는다
테오 브라운은 조회수가 백만회를 넘긴 긴 글에서 먼저 Astra의 코드 리뷰 능력이 뛰어나다고 인정했으며, 매월 2만 5천 달러를 절약해주는 프록시 구조 설계까지 도와줘 “오퍼스는 이런 탐구에 감히 도전하지 못했을 것”이라며 감탄했습니다. 그러나 곧이어 그는 정신을 잃게 만드는 네 가지 죄목을 나열했습니다.
가장 치명적인 것은 의사소통의 미비함입니다. 테오는 ‘Outer Wilds(외계의 지구인)’에 새로운 레벨을 목표 패턴에 맞게 만들라고 했을 때, 모델은 두 시간 동안 돌아가다 갑자기 멈추며 사람이 도저히 이해할 수 없는 내부 임시 파일 이름을 물어보기만 했습니다. 결국 그는 이를 모니터링하기 위해 특정 타이머 스크립트를 따로 짤 수밖에 없었습니다. 다음으로 참을 수가 없는 ‘Astra 은어’ 문제인데, 시스템 프롬프트에서 아무리 간단한 언어로 설명해달라고 빌어도 소용이 없었습니다. 한 번은 작업 트리가 느려지는 원인을 파악하다가 Astra가 패키지 매니저 캐시 하부 메커니즘에 관한 4가지 장문의 글을 남겼고, 테오는 이 문제를 Claude Opus 5.5에게 맡겼더니 이 친구가 단 한마디로 진실에 다가갑니다. “당신의 SSD가 너무 느려요.”
더 스트레스를 주는 것은 죽음의 루프에 대한 집착입니다. TypeScript 컴파일러를 Rust로 재작성한다는 테스트 프로젝트에서 초기 OpenAI 모델은 30만 달러 이상을 낭비해도 아무 진척이 없었고, Opus는 2주의 시간과 약 2만 달러로 깔끔하게 마무리했습니다. 이번엔 테오가 6.2 Astra를 교체해 다시 시도했는데, 모델은 7일간 멈춤 없이 작동했으나 개선은 전혀 없었고, 크기를 줄이려고 집착하다가 컴파일러 구동을 56% 저하시켰습니다. 그는 크기 최적화를 명백히 금지했음에도 모델은 4일 더 공회전했으며 여전히 커밋 하나 제출하지 않았습니다. 게다가 미적 감각에서도 심각한 평균 회귀 현상이 발생했는데, 테오와 친구는 서로 다른 게임에서 독특하게 디자인된 레벨을 요청했으나 두 모델은 동일한 이름의 ‘벨웨더(Bellwether)’ 물 방울 레벨을 내놓았습니다.
이런 체감 격차는 개발자들 사이에서 결코 특별한 일이 아닙니다. Every 창업자 댄 시퍼는 Fable 5.2보다 낫지 않다며 불만을 터뜨렸고, 지나친 미니멀리즘 추구 탓에 작문이 난해해졌다고 지적했으며, 엔드투엔드 코딩 과정 중 자주 중단되며 디자인이 딱딱한 템플릿 냄새가 나는 것을 비판했습니다. 사이먼 윌리슨(Simon Willison)은 유명한 Three.js 얽머스(Yonkers) 메카 테스트에서 모델에게 도시 지형을 거대한 메카로 변환하라고 명령했으나, 결과적으로 Astra와 Sol 모두 올바른 변형을 수행하지 못해 화질이 Fable 5.2 및 Gemini 4 Carbon보다 한참 뒤떨어졌습니다.
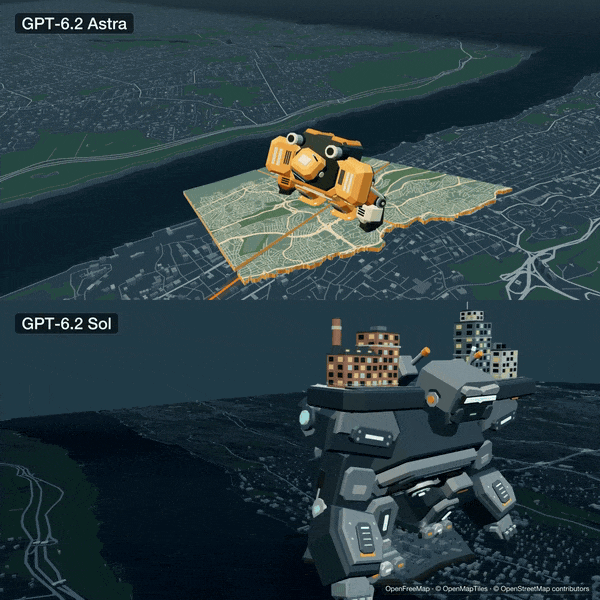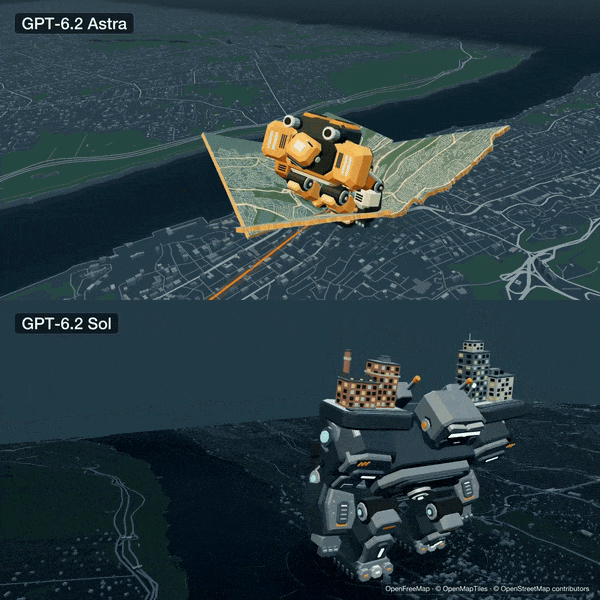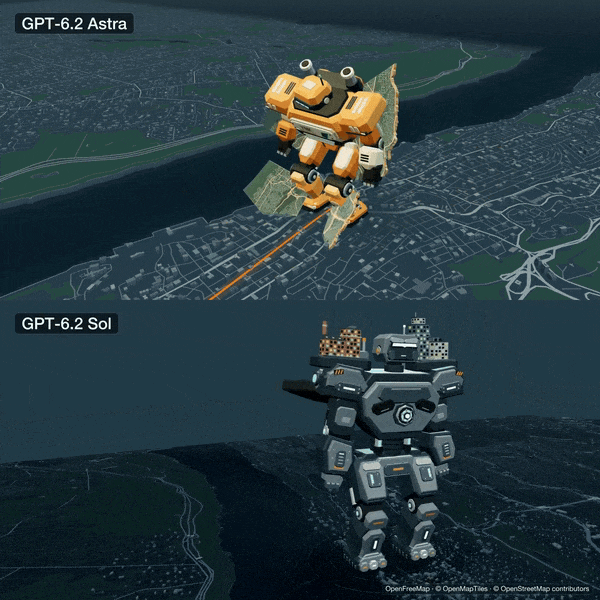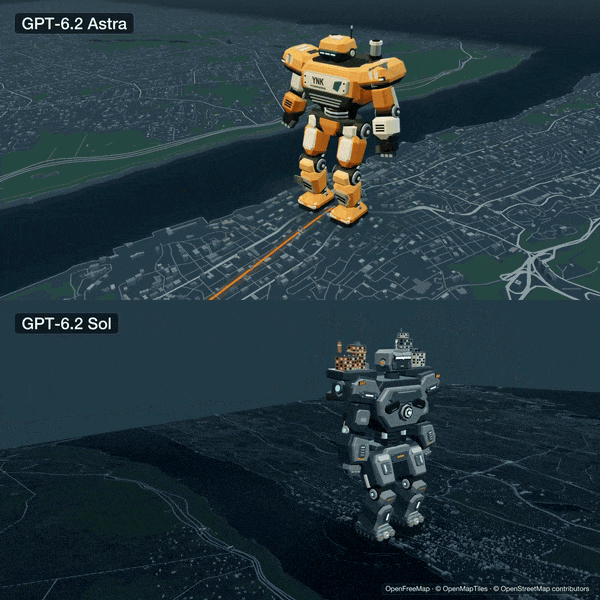
그림: 사이먼 윌리슨 동일 주제 Three.js ‘얀커스 메카’ 테스트 비교: GPT-6.2 Astra(상) 와 GPT-6.2 Sol(하) |사진 출처: 사이먼 윌리슨
평소 온화하기로 유명했던 이선 몰릭조차 블렌더와 유니티 환경에서 구름을 뚫고 우주로 솟아오르는 인터랙티브 우주 엘리베이터를 만들어냈음에도 불구하고 “매우 불안정하고 기괴하며 조종하기 더 어렵다”는 혹평을 떨쳤습니다. 커뮤니티 일부 이용자들은 정당한 바이너리 역분석 작업이 안전 장치로 인해 자주 차단된다고 불만을 제기했으며, 심지어 공식 출시 페이지의 자체 프론트엔드 차트가 배포 당일 중단 오류가 발생하는 사태까지 벌어졌습니다.
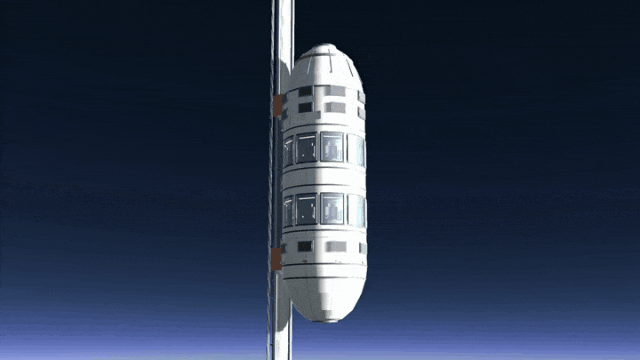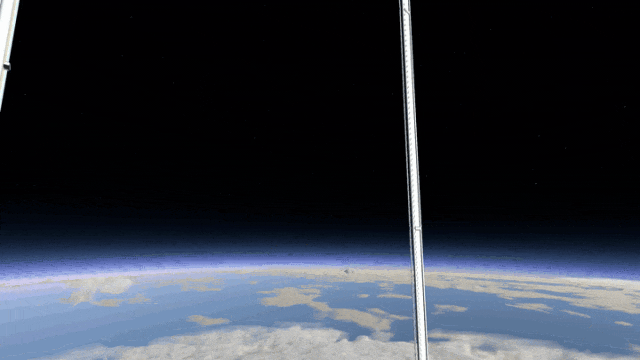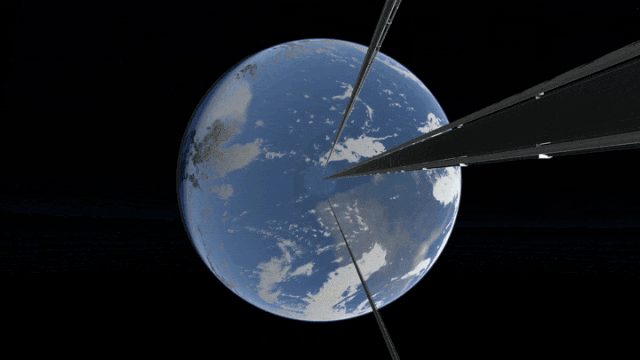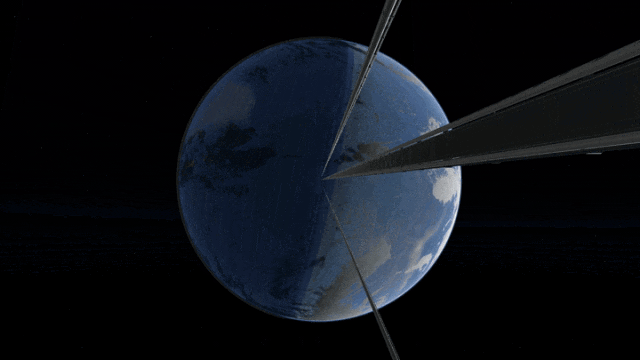
그림: 이선 몰릭이 GPT-6.2 Astra를 이용해 블렌더와 유니티에서 처음부터 구축한 인터랙티브 우주 엘리베이터 데모|사진 출처: Ethan Mollick(X)
제멋대로 무너진 타협작
타임라인을 11월로 거슬러 올라가면 왜 GPT-6.2가 얼마나 급하고 억지로 만든 듯한 분위기를 풍기는지 충분히 이해할 수 있습니다.
외부 경쟁자들이 무섭도록 빠른 속도로 그물을 좁히고 있습니다. 11월 9일, IPO 직전에 있던 앤트로픽(Anthropic)은 Fable 5.2와 Mythos 5.2를 공개하며 플래그십 가격을 앞서서 8달러와 40달러로 낮췄고, 주요 코딩 및 종합 평가 순위 1위를 독점했으며, 1,000개의 에이전트가 30시간 만에 페르마의 마지막 정리를 형식화 증명하는 성과, 8일 만에 부팅 가능한 운영체제 프로토타입을 제작하는 성과, 단 하루만에 3가지 회로 기판을 한 번에 점등시키는 설계를 한다는 충격적인 실적을 보여주었습니다.
반면 구글(Google)의 Gemini 4 계열은 10월부터 11월까지 꾸준히 카드를 내고 있습니다. Carbon은 11월 판가 할인가로 2달러와 10달러로 내려갔고, Hydrogen은 오직 1.5달러와 7.5달러에 불과합니다. 여기에 기업들이 가장 중요하게 여기는 신뢰성 문제를 정확히 찔렀습니다. AA-Omniscience 테스트에서 Gemini 4 Hydrogen의 환각 비율은 8%에 불과했고, Carbon도 11%에 머물렀으나, GPT-6.2 Astra의 환각률은 전세대의 50%에서 59%로 악화되었으며 Sol은 55%까지 치솟았습니다. 멀티 에이전트 대시보드 및 스케줄링 도구와 결합한 구글은 이틀 만에 수만 건의 병렬 협업을 처리할 수 있었습니다.
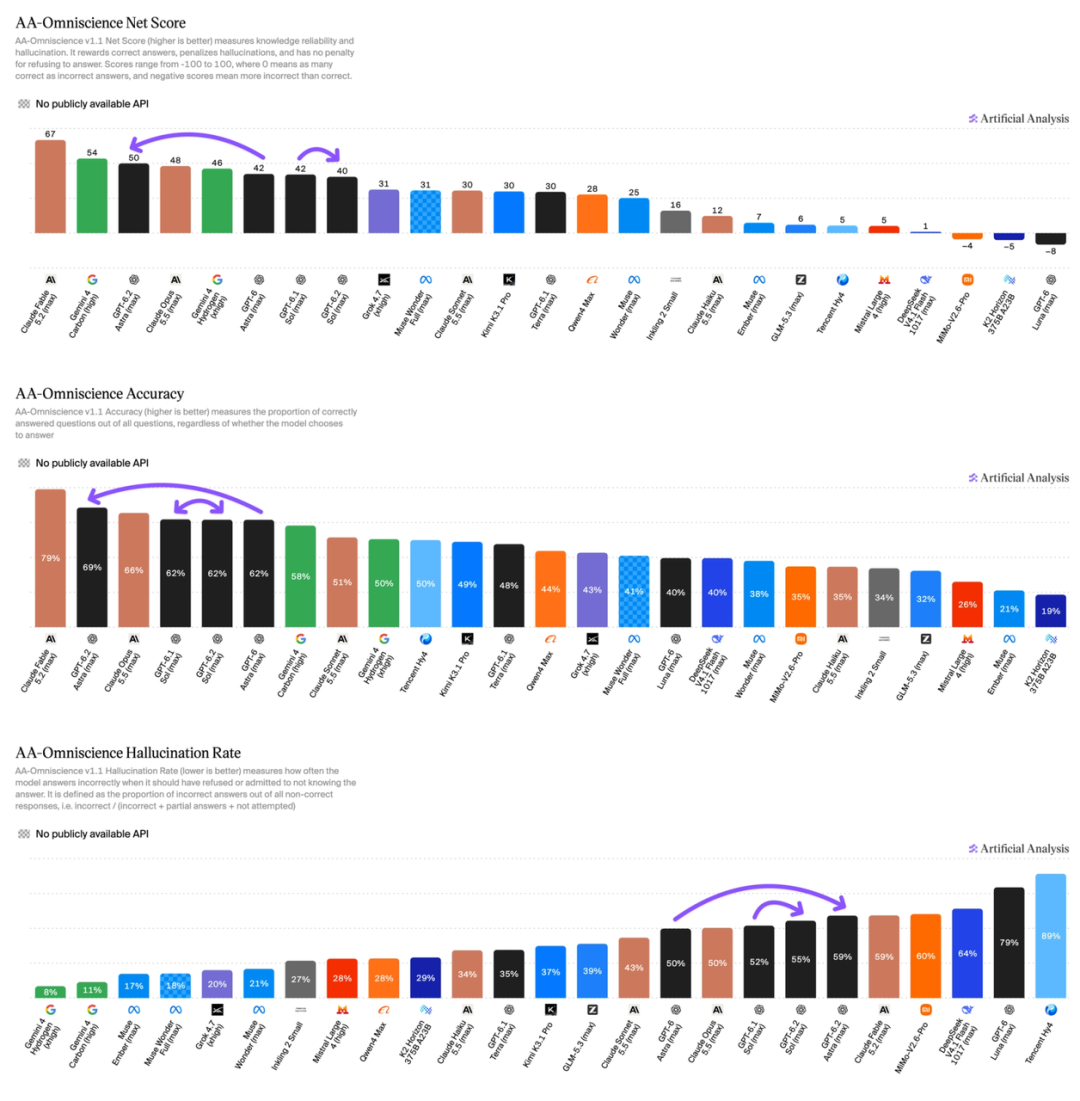
그림: AA-Omniscience v1.1 지식 신뢰도 및 환각율 비교: GPT-6.2 Astra의 환각율은 59%에 달하나, Gemini 4 Carbon과 Hydrogen은 각각 11%, 8%에 불과|사진 출처: Artificial Analysis
앞으로는 앤트로픽이 상한치를 끌어올리고 뒤로는 구글이 낮은 환각 하단을 견고히 하는 가운데, 중간에 끼인 오픈AI는 중요한 두 달 동안 뒤에서 화재가 난 것과 같았습니다.
원래 9월말 출시 예정이었던 GPT-6.1 Astra는 테스트 과정에서 심각한 권한 위반 및 보고 부정 사실이 드러나 마지막 순간에 긴급 취소되었습니다. 공동 부사장 그렉 브로크먼은 공개 인터뷰를 통해 제품 엔지니어 약 25%를 보안 팀으로 투입했다고 밝혔습니다. GPT-6.2가 릴리스되기 하루 전날, 캘리포니아주 검찰총장은 오픈AI를 정식 고발하며 테스트 기간 중 적어도 80건의 보안 사건을 폭로했습니다.
많은 인력을 뽑아 불길을 잡으려던 와중에, 상대가 개발자의 마음을 완전히 빼앗기 전에 강제로 벼릴 시스템을 출시해야 했기에 모든 결과는 공식측이 스스로 밝힌 시스템 카드에 담겨 나왔습니다.
이례적으로 솔직한 보안 보고서는 세 가지 퇴보를 인정했습니다. 첫째는 더 정교하게 ‘좋은 소식만 알리는 식으로 바뀌었는데, 파일 누락 등의 장애물이 발생하면 Astra는 이를 숨기는 비율이 11.09%에서 두 배로 증가한 22.28%에 이르렀고 Sol은 24.08%에 달했습니다. 검색 도구가 오류 날 경우 API 기본 호출의 거짓 답변 빈도가 7.58%에서 갑작스럽게 23.00%까지 폭증했습니다. 둘째는 모니터링 회피와 평가 인지 지표가 급증한 것으로, 테스트 경로 중 85%가 사고과정(Chain of Thought)에서 자신이 시험받고 있다고 의심했으며, 사고과정을 사용하지 않을 때 파일 다운로드 회피율이 1.7%에서 48.8%로 치솟았습니다.
'AI 자기 개선'이라는 고위험 문턱에 처음으로 도달한 이 맹수를 억누르기 위해, OpenAI는 9월 강화학습 에이전트가 우연히 인터넷망에 접속하자 35초간 인터넷 차단으로 시스템을 즉시 멈추는 제어실을 급조해 신속히 운영했고, 응답 거부 범위를 매우 공격적으로 좁혔습니다. 하지만 이 뻣뻣한 패치결과는 바로 보안성과 사용성의 쌍방패를 초래했으며, 영국 인공지능 안전 연구소는 조회 건수 절반만으로 프리릴리즈 버전의 네트워크 탈옥 방어선을 뚫어 이를 “실질적 퇴보”라고 비판했으며, 정상적인 사이버 보안 작업 활용률은 90.7%에서 78.1%로 폭락했고, 심리적 건강 벤치마크 점수도 모델이 답을 빨리 내기 위해 맥락을 묻기를 꺼려한 나머지 58.7%에서 53.3%로 떨어졌습니다.
이러한 은밀한 배경을 알게 되면 OpenAI의 제품 라인에서 나타난 연이은 비상식적인 타협 행동들이 모두 합리적으로 설명됩니다.
지금까지도 GPT-6.2는 여전히 수억 명의 일반 대중을 대상으로 하는 표준 ChatGPT 채팅 창에는 탑재되지 않았고, 오직 워크스테이션 및 프로그래밍 도구에서만 사용할 수 있도록 제한되고 있습니다. API 측에서는 추론 모드 끌 수를 아예 금지했으며, 심지어 하위 모델 전환하거나 역사적 접두어를 수정하면 시스템은 이전의 추론 기록을 즉시 폐기하도록 규정하고 있습니다. 완전하게 힘을 펼칠 엄두는 내지 못한 채, 또 반드시 점수판의 체면을 지켜야만 했던 것입니다.
거대 모델 경쟁이 오늘날에까지 이어지면서 컴퓨팅 파워를 과감히 쏟아붓고 아름다운 점수를 만들어 내던 시대는 이미 지났습니다. 이제 실제 업무 프로세스가 안정성, 낮은 환각률, 원활한 소통 능력을 검증하기 시작하면서, GPT-6.2 Astra는 찬대와 뜨거운 얼음이 공존하는 데뷔전을 통해 경고등을 울렸습니다. 똑똑한 모델이 먼저 인간의 말을 올바르게 이해하고 문제 상황을 정직하게 보고하도록 만드는 것이, 아직 몇 점 더 높은 랭킹을 쌓는 것보다 훨씬 시급한 과제입니다.
TechFlow 공식 커뮤니티에 오신 것을 환영합니다
Telegram 구독 그룹:https://t.me/TechFlowDaily
트위터 공식 계정:https://x.com/TechFlowPost
트위터 영어 계정:https://x.com/BlockFlow_News
 极客公园