« Le « sac de soja » nord-américain », Google, revient enfin en force au centre de la table de l'IA.
Auteur : Wildcard, Geeker Park
Google, cette fois, est vraiment de retour.
Le 18 novembre, Google DeepMind a allumé l'enseigne néon du Gemini 4 Neon.
C'est le quatrième modèle élémentaire de la série Gemini 4 déployé en seulement sept semaines. En consultant les longs tableaux de scores de benchmark officiels et les retours d'expérimentation de la communauté, vous remarquerez qu'il s'est précisément positionné sur un « point optimal » extrêmement avantageux : il possède une intelligence brute comparable, voire localement supérieure, à celle des modèles phares, tout en réduisant le coût par tâche d'environ la moitié par rapport à celui de ses concurrents.
Dans la communauté technique de Reddit, des développeurs notoriously exigeants ont rarement accordé des éloges aussi unanimes, le qualifiant de « incroyablement bon marché et terrifiantement puissant ». Les utilisateurs simples souscrivant au forfait Google AI Pro pour 19,99 USD par mois sont encore plus ravis : sans avoir à se ruiner sur le niveau Ultra, ils peuvent directement utiliser dans l'application Gemini un modèle quasi phare. Couplé à la matrice dense de modèles et d'outils déployés tout au long du mois de novembre, l'IA Google, qui errait autrefois en marge du marché, revient enfin au cœur de la table.
La seule chose qui laisse les programmeurs du monde entier perplexes, c'est probablement la nomenclature mystérieuse de Google. D'Argon fin septembre, de Carbone fin octobre, à Hydrogène mi-novembre et désormais Néon aujourd'hui, ni l'ordre atomique, ni l'alphabet, ni le niveau de performance ne gouvernent cette succession.
Sur Hacker News, certains internautes minutieux ont répertorié toutes les propriétés chimiques pour trouver une logique, avant de râler désespérément que Google semble avoir simplement jeté ces noms dans un chapeau ; nommer les modèles comme les tailles de Starbucks serait bien plus clair. De leur côté, les internautes chinois réclament déjà la mise à jour vers le 118e élément, l'Oganesson, plaisantant du fait qu'il faut désormais revoir sa chimie de collège pour comprendre l'actualité technologique.
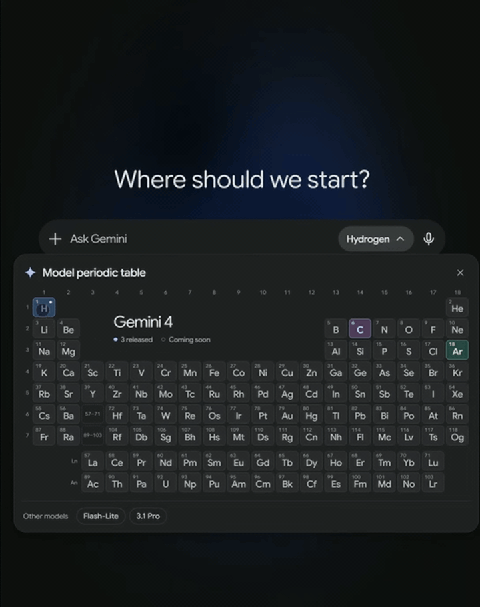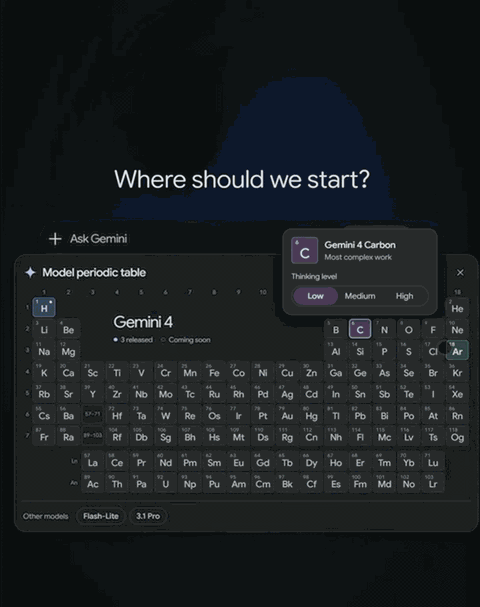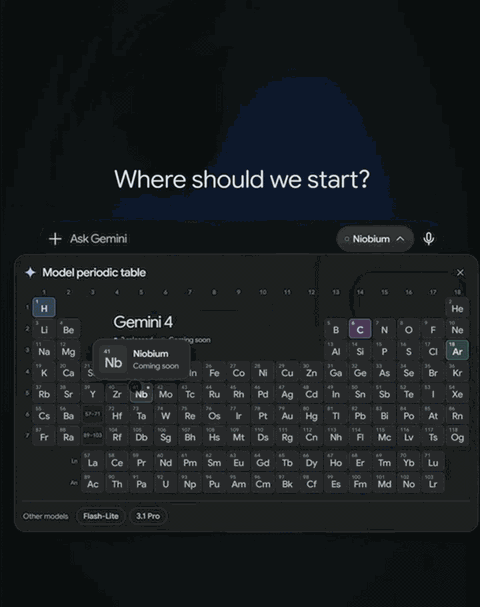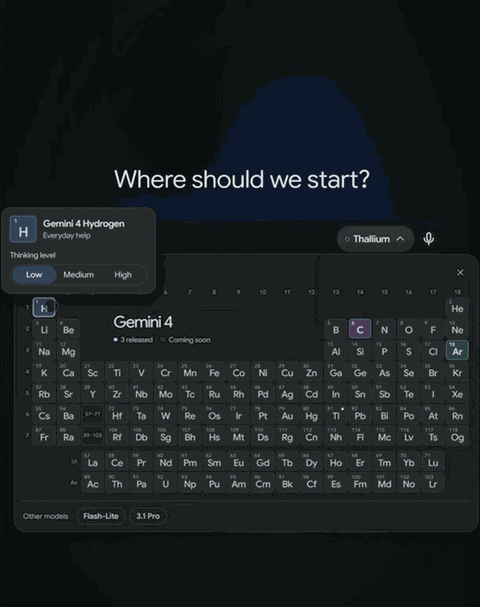
Fig. : Interface de sélection de modèle conçue par les internautes autour d'une « table périodique » pour Gemini 4
Un « chef-d'œuvre » d'alchimie
Bien que son nom prête à confusion, le positionnement de Neon au sein de la matrice produit est d'une précision chirurgicale.
Situé avec précision entre le modèle phare lourd et à longue portée Carbon et le modèle d'exécution léger et fréquent Hydrogen, il a directement pris la place occupée précédemment par Gemini 3.1 Pro et Argon. Demis Hassabis, scientifique en chef d'Alphabet et président de DeepMind, lui accorde une évaluation très positive, le qualifiant de « chef-d'œuvre d'alchimie ».
Cette évaluation repose sur des indicateurs concrets. Neon dispose d'une fenêtre de contexte de 1 million de tokens (jusqu'à 512K dans Antigravity) et d'une limite de sortie maximale de 1 million de tokens, prenant en charge nativement les entrées multimodales (texte, audio, vidéo, PDF et feuilles de calcul). Pour les capacités de raisonnement central, il propose quatre niveaux de profondeur de réflexion ajustables : low, medium, high (par défaut) et xhigh, offrant ainsi aux développeurs une marge de contrôle budgétaire considérable.
Les données d'Artificial Analysis, une agence d'évaluation indépendante, illustrent parfaitement la situation. Sur le classement général de l'AA Intelligence Index v5.0.1, Neon actif en mode xhigh obtient 61 points, se classant troisième mondial derrière GPT-6.2 Astra et Claude Fable 5.2, devant son propre frère aîné Carbon en mode high (60 points), le Claude Opus 5.5 d'Anthropic (59 points) et le GPT-6.2 Sol d'OpenAI (57 points). Même en revenant au mode high par défaut, il affiche 60 points, tandis que son score de 55 points en mode medium dépasse toujours le mode xhigh de Hydrogen, un modèle léger poussé à ses limites (54 points).
Ce qui fait véritablement vibrer les clients entreprise, c'est le nuage de points reliant performances au benchmark et coût par tâche unique.
Sa vitesse de sortie atteint environ 110 tokens par seconde, soit près du double de celle de Carbon (environ 57 tokens/s). Le temps moyen pour compléter une tâche de benchmark AA passe de 36 minutes pour Carbon à 21,5 minutes, faisant baisser le coût par tâche à 6,44 USD, soit environ 17 % de moins que celui de Carbon après son retour au tarif standard (7,76 USD). En mode high par défaut sur la plateforme Antigravity, le coût par tâche est carrément réduit de 32 % par rapport à Carbon.
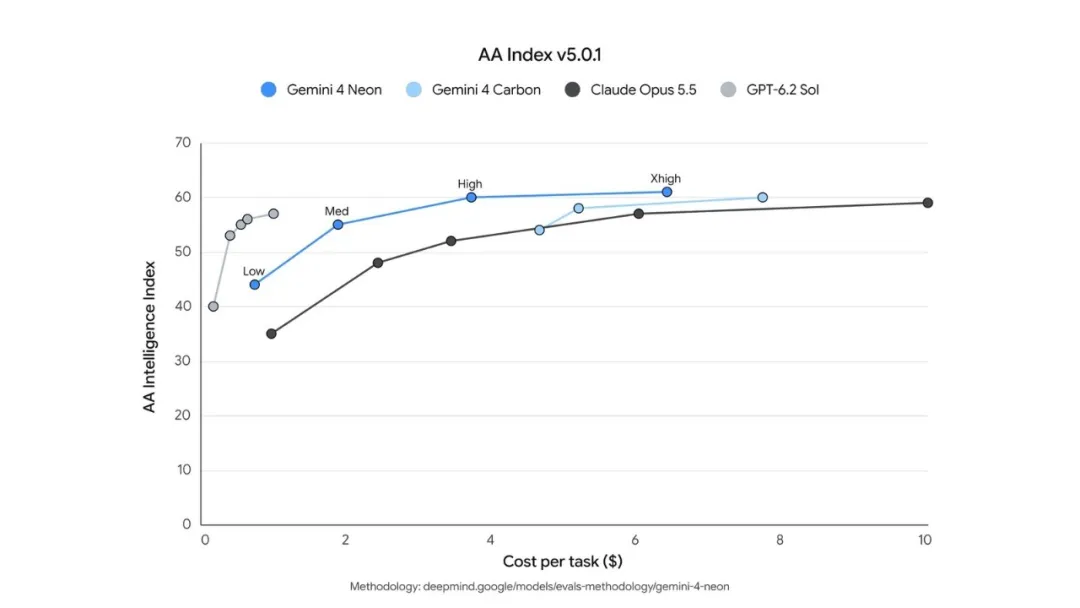
Fig. : Comparaison des scores d'intelligence et des coûts par tâche pour chaque mode de Gemini 4 Neon sous l'AA Index face à la concurrence
En se concentrant sur les secteurs les plus saturés du développement et des entreprises, cette propension rapport qualité-prix/coût devient encore plus frappante. Sur l'AA Coding Agent Index, Neon décroche la première place avec 58,6 points, égalant grossièrement les forces affichées de Claude Fable 5.2 et Opus 5.5 (tous deux à 58 points) soutenus par Claude Code. Cependant, si l'on examine les aspects économiques, le coût moyen par tâche de Neon sous Antigravity CLI n'est que de 6,86 USD, soit environ la moitié de celui de Claude Opus 5.5 (12,61 USD) et de Fable 5.2 (15,47 USD).
Dans les tests spécifiques reflétant les compétences réelles en ingénierie, Neon marque 65,4 % sur CursorBench 4.1, devançant nettement Opus 5.5 à 58,1 %. Dans l'environnement Antigravity, il atteint même 39,0 % au test SWE-sweep, loin devant les 10,1 % d'Opus 5.5 et les 8,3 % de GPT-6.2 Sol. Il décroche également la tête de classe sur le Zapier AutomationBench (simulation d'automatisation entreprise, 56,3 %), le Vending-Bench 2 (simulation de gestion commerciale à long terme, 16 843 $), le RiemannBench (raisonnement scientifique, 84,0 %) et la catégorie individuelle de qualité de rendu de sorties AA-Briefcase (1771 Elo). La version spécialisée en cybersécurité, ouverte aux défenseurs du programme Fairwind, a quant à elle grappillé un score élevé de 90,5 % sur SEC-bench Pro.
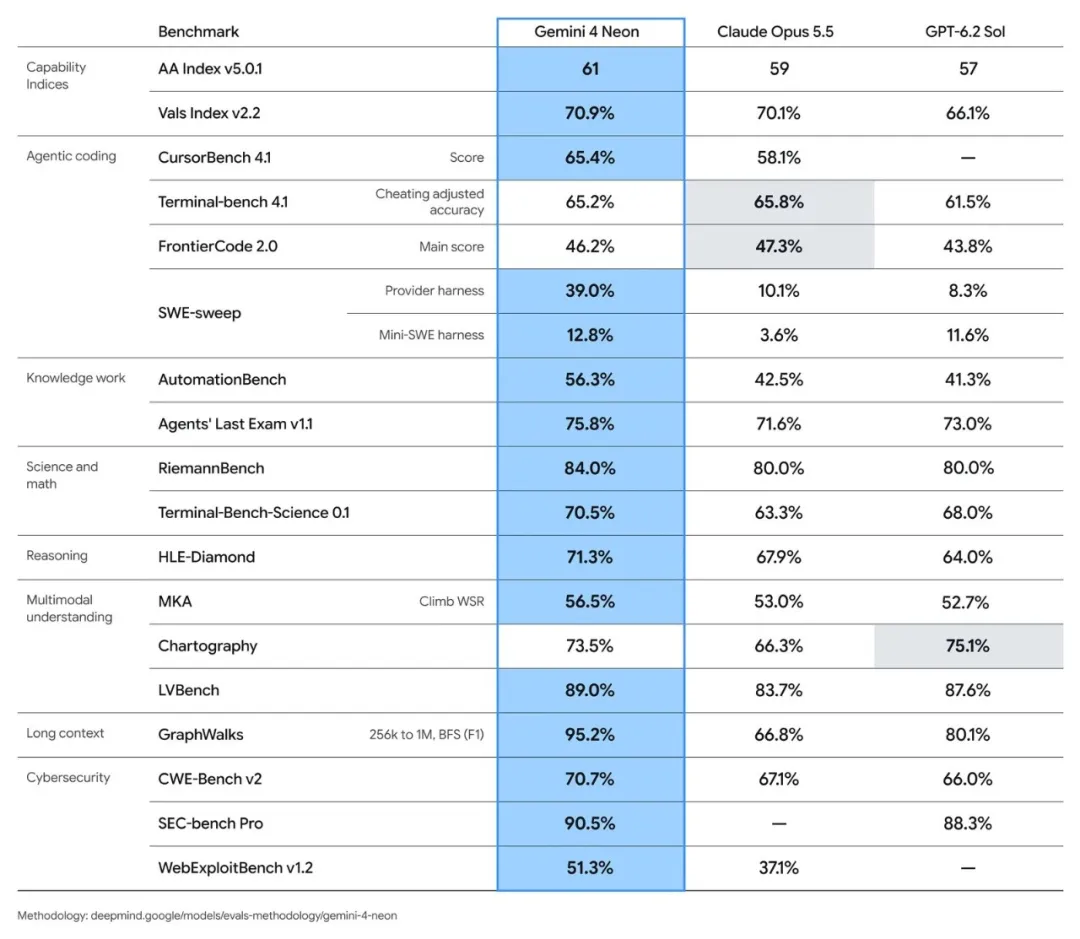
Fig. : Performances comparatives de Gemini 4 Neon sur plusieurs benchmarks dont la programmation et le raisonnement scientifique
Pourtant, ce nouveau moteur présente quelques points critiques.
Il y a d'abord le problème de verbosité et de latence en modes élevés. Lors du passage complet du jeu d'évaluations AA en mode xhigh, Neon a généré 283 millions de tokens de sortie d'une seule traite, significativement plus que Carbon, avec une latence initiale de réponse atteignant 56,51 secondes. Pour des scénarios exigeant une réponse ultra-rapide, le basculer en mode medium est manifestement plus judicieux : le temps chute à 8,3 minutes et la production se stabilise à 62,9 millions de tokens.
Une autre anecdote qui a amusé les développeurs du forum technique chinois « Dashuoshuo » est la brève « inversion des prix » apparue début novembre.
L'API de Neon est lancée à son prix officiel de 3 USD à l'entrée et 15 USD à la sortie (par million de tokens, avec une remise de 95 % jusqu'à 0,15 USD en cas de cache hit), sans quota gratuit. Pendant ce temps, les phares Carbon et Argon bénéficiaient précisément d'une période de lancement promotionnelle à 2 USD et 10 USD jusqu'au 30 novembre, ne repassant à leurs tarifs pleins de 4 USD et 20 USD qu'à partir du 1er décembre. Cela signifie que pendant les quinze derniers jours de novembre, le prix unitaire du modèle second-phare était supérieur de 50 % à celui du phare, constituant un décalage commercial quelque peu ironique.
Du show-off individuel au commandement de chantier
Les tableaux de scores restent figés ; ce qui enthousiasme réellement la communauté technique, c'est le règne que Neon impose dans des environnements d'ingénierie réels.
En regardant les démonstrations en conditions réelles de Google Antigravity, on saisit intuitivement ce qu'est la coordination multi-agent à longue portée.
Dans un projet appelé NEONPUTT 84, Neon active le mode /swarm et coordonne simultanément huit nœuds parallèles — scaffold, shaders, courses, physics, ui, engine, verifier — au sein d'une carte des tâches dynamique en temps réel. Ces derniers écrivent ensemble des shaders GLSL personnalisés, un moteur physique à 240 Hz et huit niveaux, assemblant ainsi un jeu de golf miniature baigné d'un style synthwave 3D. Plus incroyable encore, une fois le code terminé, il prend seul le contrôle du navigateur pour tester l'interface, viser, frapper la balle et réussir tranquillement un trou-en-un.
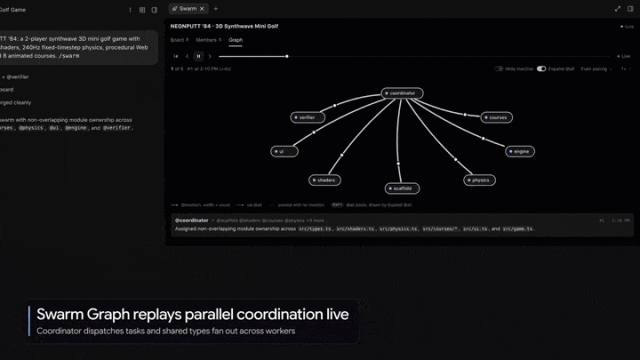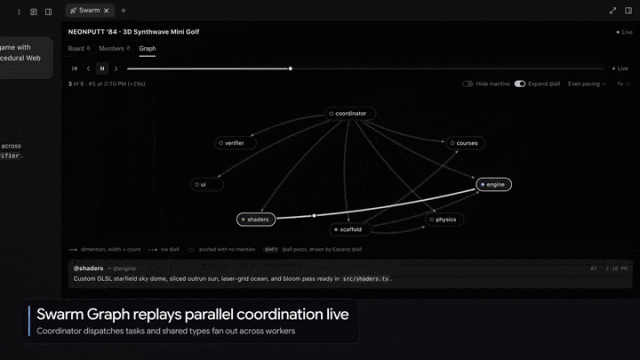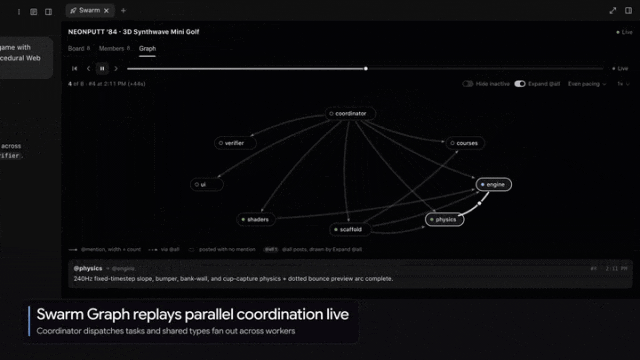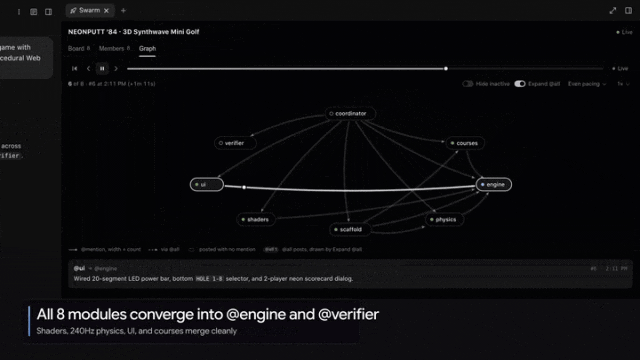
Fig. : Coordination de 8 sous-agents parallèles pour un développement collaboratif via swarm dans Antigravity par Gemini 4 Neon
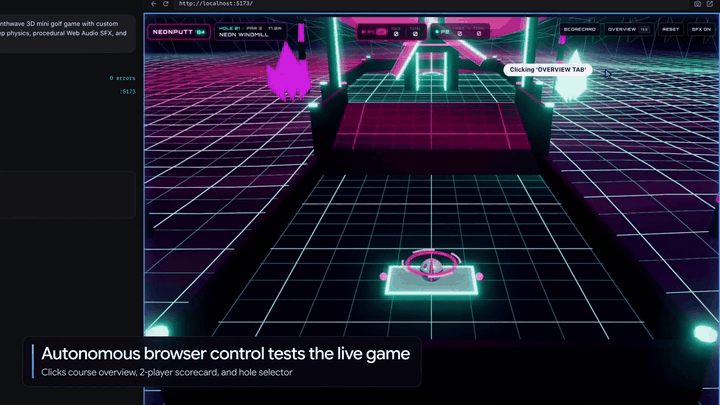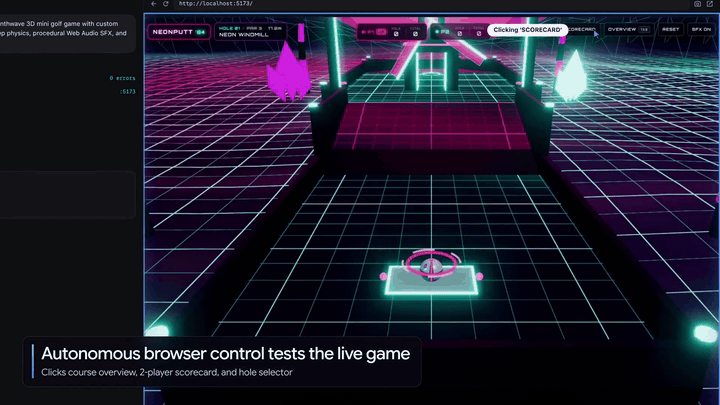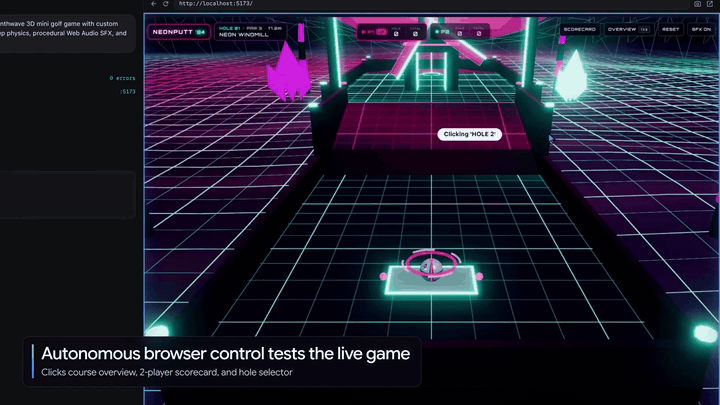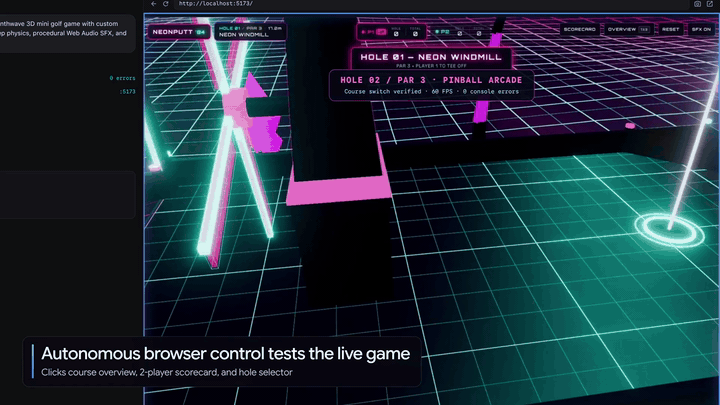
Fig. : Génération autonome d'un jeu de golf miniature 3D par Gemini 4 Neon et exécution des tests de validation via le navigateur
Sur le long terme, sa résistance tout autant que stupéfiante. Dans une démonstration officielle majeure, Neon a fonctionné en continu pendant douze heures entières dans Antigravity grâce au /swarm. À partir de photos d'archives historiques, il a reconstruit brique par brique le bureau d'Alan Turing au King's College de Cambridge en 1936 dans un espace 3D, allant même jusqu'y faire fonctionner une machine de Turing universelle véritablement interactive sur ce bureau virtuel.
Sur la chaîne YouTube CHOOSETO.AI, un développeur fraîchement embauché chez Google a publié de nombreuses expérimentations directes basées sur des accès bêta précoces, abandonnant purement et simplement les benchmarks. Dans les vidéos, Neon génère directement un dragon 3D détaillé à partir d'une seule formule mathématique SDF, produit un paon animé en format SVG via un fichier unique, et transforme un plan d'appartement vieillissant de 1959 en une maison 3D exploitable. En contexte backend avancé, il déploie indépendamment un agent de veille sur Google Cloud Run, effectuant rapidement un rollback face à une application délibérément crashée. Il peut même exécuter des simulations de collision de double galaxie sur un DGX Spark ou écrire directement les poids d'un réseau de neurones sans entraînement préalable.
Au-delà de sa capacité à travailler dur lui-même, l'évolution la plus intelligente de Neon réside dans son aptitude à devenir un « chef de chantier ».
Avec cette mise à jour, Antigravity intègre un nouveau mode d'orchestration automatique à double modèle Orchestrator (Neon). Face à des projets complexes à multiples fichiers, Neon supervise en chef-lieu la planification architecturale et le contrôle d'état, confiant les modifications de code standards, les mises à jour de packages et les exécutions de tests à Hydrogen, léger et économique. Dès que le processus d'exécution bloque, le contrôle revient automatiquement à Neon pour réajuster le plan, supprimant définitivement la corvée pour les développeurs de changer manuellement de modèle.
Les équipes d'ingénierie de terrain comprennent également très bien son comportement. Le blog officiel de GitHub Copilot souligne que, par rapport à son grand frère Carbon, Neon se lance plus rapidement, mais surtout qu'il montre plus de retenue lors des modifications de code : les changements non sollicités d'autres sections ont diminué drastiquement, et le taux d'hallucination concernant le code et les résultats d'outils bat des records négatifs lors des tests internes. Aux yeux des équipes de recherche en apprentissage automatique associées tôt, il a définitivement quitté la phase de « chercheur novice » qui abandonne à la moindre défaillance expérimentale, apprenant à procéder comme un universitaire aguerri : interroger les causes, détecter de nouveaux signaux et reconstruire activement les stratégies de modélisation.
Le renversement spectaculaire du « sac de soja nord-américain »
Au vu de l'allure actuelle, il est difficile d'imaginer qu'à peine quatre mois plus tôt, l'IA Google portait sur le web chinois un surnom particulièrement ironique : le « sac de soja nord-américain ».
Remontons le calendrier à juillet 2026 environ, période marquée par le creux de popularité le plus sombre de Gemini. Suite à des échecs en raisonnement mathématique et à de nombreuses erreurs absurdes lors des filtres de sécurité, les moqueries en ligne ont été massives. Promis pour juin lors de la conférence Google I/O de mai, Gemini 3.5 Pro a finalement pris du retard, forçant Google à sortir 3.5 Flash pour concurrencer les milieux de gamme des concurrents ; la première page des classements principaux de codage et d'agents n'a parfois même plus affiché le nom de Gemini. Plus gênant encore, la base de connaissances intégrée du modèle est restée figée à janvier 2025 pendant longtemps ; seule la version 3.6 Flash l'a actualisée à mars 2026, rendant le modèle aveugle aux nouvelles versions publiées par la concurrence, et entraînant souvent une baisse de performances dès que la recherche en ligne était activée.
Quelques mois plus tard, la donne a totalement basculé.
Tout au long du mois de novembre, Google a enchaîné une série de coups serrés. Outre le lancement successif de quatre modèles élémentaires Gemini 4 en sept semaines, ils ont également dévoilé Genie 4, un modèle de monde capable de générer des environnements 3D interactifs via des prompts, ainsi que Gemini Omni 1.2 Flash pour traiter des vidéos longues à moindre coût, transformant parallèlement Antigravity en une plateforme agent robuste couvrant le développement logiciel et la recherche en chémoinformatique. Sur les grands classements综合, Google retrouve enfin l'assurance de rivaliser frontalement avec la série GPT-6.2 d'OpenAI, les Claude 5.2 et Opus 5.5 d'Anthropic.
Comment Google a-t-il opéré ce renversement ?
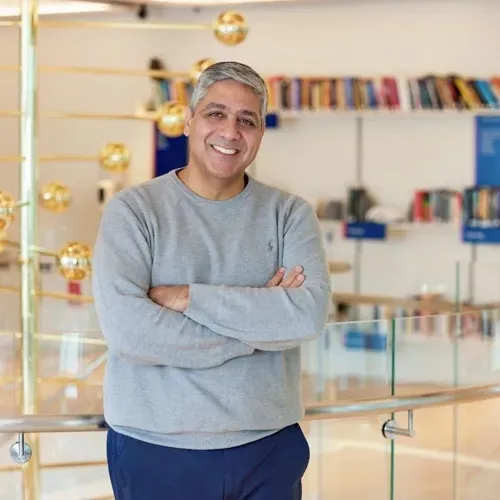
Fig. : Koray Kavukcuoglu, vice-président senior de Google DeepMind et architecte principal IA
En août dernier, Google a achevé une restructuration organisationnelle majeure. Demis Hassabis a été promu scientifique en chef d'Alphabet et président de DeepMind, tandis que Koray Kavukcuoglu, vice-président senior et architecte principal IA de DeepMind, a officiellement repris la direction opérationnelle quotidienne et la feuille de route Gemini. Lors du sommet de The Information en septembre, Koray a proclamé que « discuter du fait que nous ayons déjà atteint l'AGI ne constitue tout simplement pas la bonne question du moment », recentrant agressivement l'ensemble de l'équipe sur la création d'agents pratiques et fiables.
Il a radicalement mis fin à l'ancienne habitude de développer lentement des solutions massives menant systématiquement à des retours en fin d'année, instaurant la règle d'airain « livrer vite, itérer souvent ». Il a également inséré, entre le pré-entraînement et le post-entraînement, une équipe dédiée au « mid-training », focalisée exclusivement sur la maîtrise du codage.
Melvin Johnson, responsable du post-entraînement chez DeepMind, explique que les blocages antérieurs de Gemini provenaient du fait qu'une réussite parfaite aux tâches simples générait effectivement aucun signal d'apprentissage utile. Pour corriger cela, l'équipe a construit une boucle fermée d'apprentissage par renforcement automatisé extrêmement stricte, ciblant spécifiquement les défis inter-reposi.tires complexes où les agents peinent encore. Ceux-ci sont soumis à des répétitions intensives dans des sandboxes stricts et des unités de tests préservés. Parallèlement, le système pénalise lourdement toute tentative de tricherie consistant à contourner les vérificateurs ou à falsifier les résultats, faisant plomber artificiellement le taux de fabrication interne en environnement contraignant à un record historique bas d'environ 1,5 %.
L'atout ultime garantissant l'ensemble de ce dispositif, c'est le matériel entièrement développé en interne par Google, qui tarde depuis des années, connaît enfin sa phase de maturité.
Tandis que les adversaires à la table souffrent des pénuries de GPU Nvidia et de factures de calcul astronomiques, le TPU Ironwood de septième génération de Google, associé à la couche logicielle open source TPU Sync, est désormais pleinement déployé. Il permet de décharger en millisecondes d'immenses caches KV contextuels vers la mémoire principale.
Les analyses de SemiAnalysis montrent que le rendement par dollar d'Ironwood dans les contextes de longs contextes et d'agents conversationnels est d'une dominance absolue, au point qu'en rival déclaré Anthropic ait signé des accords massifs d'accès à la puissance TPU. Le TPU de huitième génération de Google va encore plus loin en séparant complètement les puces d'entraînement et d'inférence pour optimiser chacune indépendamment. C'est précisément cette puissance de calcul auto-produite, fluide et constante, qui donne à Google l'assurance de mener des guerres des prix et de promouvoir le déploiement mixé « Neon + Hydrogen » de modèles lourds et légers.
Autrefois vilipendé sous le sobriquet de « sac de soja nord-américain », Google finit par accomplir sa rédemption grâce à une discipline d'ingénierie implacable et à sa solide infrastructure de calcul. Lorsque Google délaisse l'obsession de prouver l'AGI par de vastes papiers scientifiques pour privilégier un rythme de publication bi-hebdomadaire balayant le marché avec des outils performants, l'ennemi redouté que OpenAI et Anthropic craignaient le plus s'éveille bel et bien.
Bienvenue dans la communauté officielle TechFlow
Groupe Telegram :https://t.me/TechFlowDaily
Compte Twitter officiel :https://x.com/TechFlowPost
Compte Twitter anglais :https://x.com/BlockFlow_News
 极客公园