DeepSeek несовершенен, в процессе обучения существует «проклятие глубины»
Высокопроизводительные большие модели во время обучения обычно требуют тысяч GPU, а завершение одного цикла обучения занимает месяцы или даже больше. Такие огромные затраты ресурсов означают, что каждый слой модели должен обучаться эффективно, чтобы обеспечить максимальное использование вычислительных мощностей.
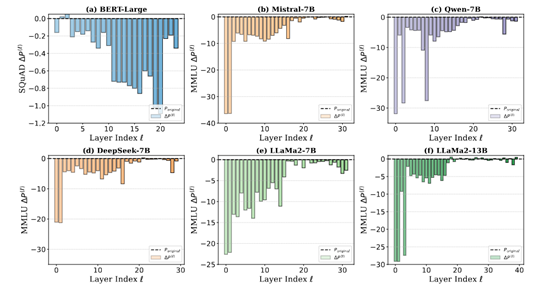
Однако исследователи из Даляньского политехнического университета, Университета Вестлейк, Оксфордского университета и других учреждений, изучая DeepSeek, Qwen, Llama и Mistral, обнаружили, что глубокие слои этих моделей работают неэффективно во время обучения и даже могут быть полностью обрезаны без влияния на производительность модели.
Например, исследователи провели послойную обрезку модели DeepSeek-7B, чтобы оценить вклад каждого слоя в общую производительность модели. Результаты показали, что удаление глубоких слоев модели практически не влияет на производительность, тогда как удаление начальных слоев приводит к значительному снижению производительности. Это указывает на то, что глубокие слои модели DeepSeek не смогли эффективно изучить полезные признаки во время обучения, в то время как начальные слои взяли на себя большую часть задачи извлечения признаков.
Это явление называется “Проклятие глубины” (Curse of Depth), и исследователи также предложили эффективное решение решения — LayerNorm Scaling (масштабирование слойной нормализации).
Введение в “Проклятие глубины”
Корень явления “Проклятие глубины” заключается в особенностях Pre-LN. Pre-LN — это техника нормализации, широко используемая в моделях архитектуры Transformer, которая выполняет нормализацию на входе каждого слоя, а не на выходе. Хотя такой способ нормализации может стабилизировать процесс обучения модели, он также создает серьезную проблему: с увеличением глубины модели дисперсия выхода Pre-LN растет экспоненциально.
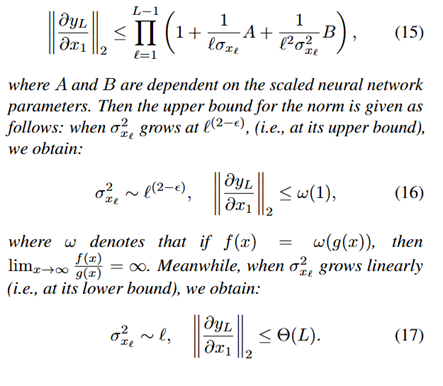
Этот взрывной рост дисперсии приводит к тому, что производные глубоких блоков Transformer приближаются к единичной матрице, из-за чего эти слои практически не вносят никакой полезной информации в процесс обучения. Другими словами, глубокие слои во время обучения превращаются в единичное отображение и не могут изучать полезные признаки.
Существование “Проклятия глубины” создает серьезные проблемы для обучения и оптимизации больших языковых моделей. Во-первых, недостаточное обучение глубоких слоев приводит к пустой трате ресурсов. При обучении больших языковых моделей обычно требуются огромные вычислительные ресурсы и время. Поскольку глубокие слои не смогли эффективно изучить полезные признаки, вычислительные ресурсы во многом тратятся впустую.
Неэффективность глубоких слоев ограничивает дальнейшее улучшение производительности модели. Несмотря на то, что начальные слои могут выполнять большую часть задач по извлечению признаков, неэффективность глубоких слоев не позволяет модели в полной мере использовать преимущества своей глубины.
Кроме того, “Проклятие глубины” создает проблемы для масштабируемости модели. С увеличением размера модели неэффективность глубоких слоев становится все более выраженной, что делает обучение и оптимизацию модели более сложными. Например, при обучении сверхбольших моделей недостаточное обучение глубоких слоев может привести к замедлению скорости сходимости модели или даже к отсутствию сходимости.
Решение — LayerNorm Scaling
Основная идея LayerNorm Scaling заключается в точном контроле дисперсии выхода Pre-LN. В многоуровневой модели Transformer выход нормализации слоя каждого уровня умножается на определенный коэффициент масштабирования. Этот коэффициент масштабирования тесно связан с глубиной текущего слоя и представляет собой обратную величину квадратного корня из глубины слоя.
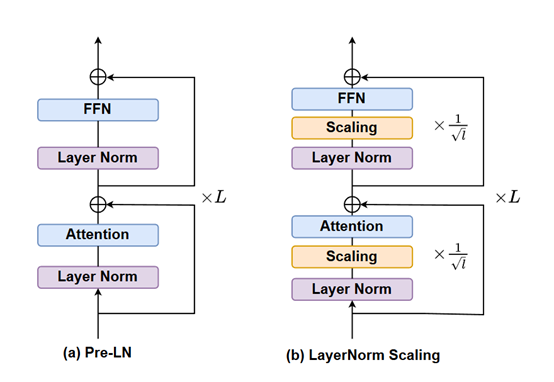
Чтобы привести простой и понятный пример, большая модель похожа на высотное здание, каждый слой — это этаж в нем, а LayerNorm Scaling — это точная настройка “выходной энергии” каждого этажа.
Для нижних этажей (начальных слоев) коэффициент масштабирования относительно велик, что означает, что их выход корректируется меньше, и они могут сохранять относительно сильную “энергию”; для верхних этажей (глубоких слоев) коэффициент масштабирования меньше, что эффективно снижает “интенсивность энергии” выхода глубоких слоев и предотвращает чрезмерное накопление дисперсии.
Благодаря этому способу дисперсия выхода всей модели得到有效控制,и ситуация со взрывом дисперсии в глубоких слоях больше не возникает. (Весь процесс вычислений довольно сложен, заинтересованные читатели могут напрямую ознакомиться со статьей)
С точки зрения обучения модели, в традиционном обучении моделей Pre-LN из-за постоянного увеличения дисперсии глубоких слоев градиенты сильно искажаются в процессе обратного распространения. Информация о градиентах глубоких слоев становится нестабильной, что похоже на передачу эстафетной палочки, когда палочка постоянно падает во время передачи на последних этапах, что приводит к затруднению передачи информации.
Это затрудняет обучение глубоких слоев эффективным признакам во время обучения, и общий эффект обучения модели значительно снижается. В то время как LayerNorm Scaling стабилизирует поток градиентов за счет контроля дисперсии.
В процессе обратного распространения градиенты могут более плавно передаваться от выходного слоя модели к входному слою, каждый слой может получать точные и стабильные градиентные сигналы, что позволяет более эффективно обновлять параметры и обучаться.
Результаты экспериментов
Чтобы проверить эффективность LayerNorm Scaling, исследователи провели обширные эксперименты на моделях разного размера. Эксперименты охватили модели от 130 миллионов параметров до 1 миллиарда параметров.
Результаты экспериментов показали, что LayerNorm Scaling значительно улучшил производительность модели на этапе предварительного обучения, снизил перплексию и уменьшил количество токенов, необходимых для обучения, по сравнению с традиционным Pre-LN.
Например, на модели LLaMA-130M LayerNorm Scaling снизил перплексию с 26.73 до 25.76, а на модели LLaMA-1B с 1 миллиардом параметров перплексия снизилась с 17.02 до 15.71. Эти результаты показывают, что LayerNorm Scaling не только эффективно контролирует рост дисперсии глубоких слоев, но и значительно повышает эффективность обучения и производительность модели.
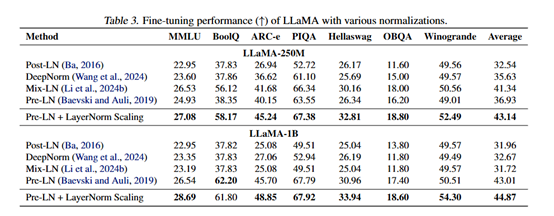
Исследователи оценили производительность LayerNorm Scaling на этапе дообучения с учителем. Результаты экспериментов показали, что LayerNorm Scaling превзошел другие техники нормализации в нескольких downstream задачах.
Например, на модели LLaMA-250M производительность LayerNorm Scaling в задаче ARC-e улучшилась на 3.56%, а средняя производительность по всем задачам улучшилась на 1.80%. Это показывает, что LayerNorm Scaling не только отлично проявляет себя на этапе предварительного обучения, но и может значительно улучшить производительность модели на этапе дообучения.
Кроме того, исследователи заменили метод нормализации модели DeepSeek-7B с традиционного Pre-LN на LayerNorm Scaling. В течение всего процесса обучения способности к обучению глубоких блоков значительно улучшились, они смогли активно участвовать в процессе обучения модели и внести вклад в улучшение производительности модели. Снижение перплексии стало более очевидным, а скорость снижения более стабильной.