


Когда трафик ИИ превысит человеческий, как доказать, что вы человек?
Автор: Вайдик Мандлой
Перевод: Луффи, Foresight News
ChatGPT, запущенный в конце 2022 года, к настоящему времени породил обширную экосистему ИИ-агентов. Объём сетевого трафика, генерируемого такими программами, уже превысил совокупный трафик всех человеческих пользователей мира. Поведение ИИ в сети принципиально отличается от человеческого: ИИ не просматривает рекламу, не кликает по ссылкам и не совершает онлайн-покупки — он лишь извлекает необходимые для выполнения задачи данные из Сети и удаляется сразу после завершения задачи.
Изначальная архитектура и коммерческая логика Интернета были полностью построены вокруг поведения и привычек людей. Однако сегодня подавляющее большинство веб-запросов исходит не от реальных людей, что создаёт серьёзные проблемы для множества сайтов. Уже более 2,5 млн веб-ресурсов начали блокировать ИИ-роботов; платформы, такие как Perplexity, оказались вовлечены в судебные процессы по этому поводу. Облачный провайдер Cloudflare даже создал «лабиринт-ловушку», используя бессмысленные тексты, сгенерированные ИИ, чтобы формировать бесконечные циклические страницы и тем самым «заточить» различных веб-сканеров.
Тем не менее некоторые продвинутые ИИ-агенты уже способны обходить подобные защитные механизмы. В условиях нарастающей «гонки вооружений» между людьми и машинами отрасль начинает активно разрабатывать более надёжные системы верификации подлинной человеческой личности. Такая система должна точно определять, является ли оператор за экраном человеком: при работе человека возникают естественные паузы, опечатки, а движение курсора сопровождается характерной микродрожью, обусловленной особенностями нервной системы. В этой статье анализируются причины этой трансформации, две основные технологические стратегии и выбор, стоящий перед обществом: принять централизованную биометрическую слежку или использовать криптографические протоколы нулевого разглашения для анонимной верификации человека.
ИИ подрывает бизнес-модель Интернета
Массовая блокировка ИИ-программ веб-сайтами вызвана тем, что ИИ одновременно атакует две ключевые опоры интернет-экономики. Традиционная модель монетизации Интернета строится на внимании пользователей: когда пользователь посещает страницу и просматривает рекламу, издатель контента получает доход. Если же покупки выполняет ИИ, он может за один раз проанализировать пять тысяч сайтов, тогда как обычный человек обычно просматривает лишь четыре–пять страниц.
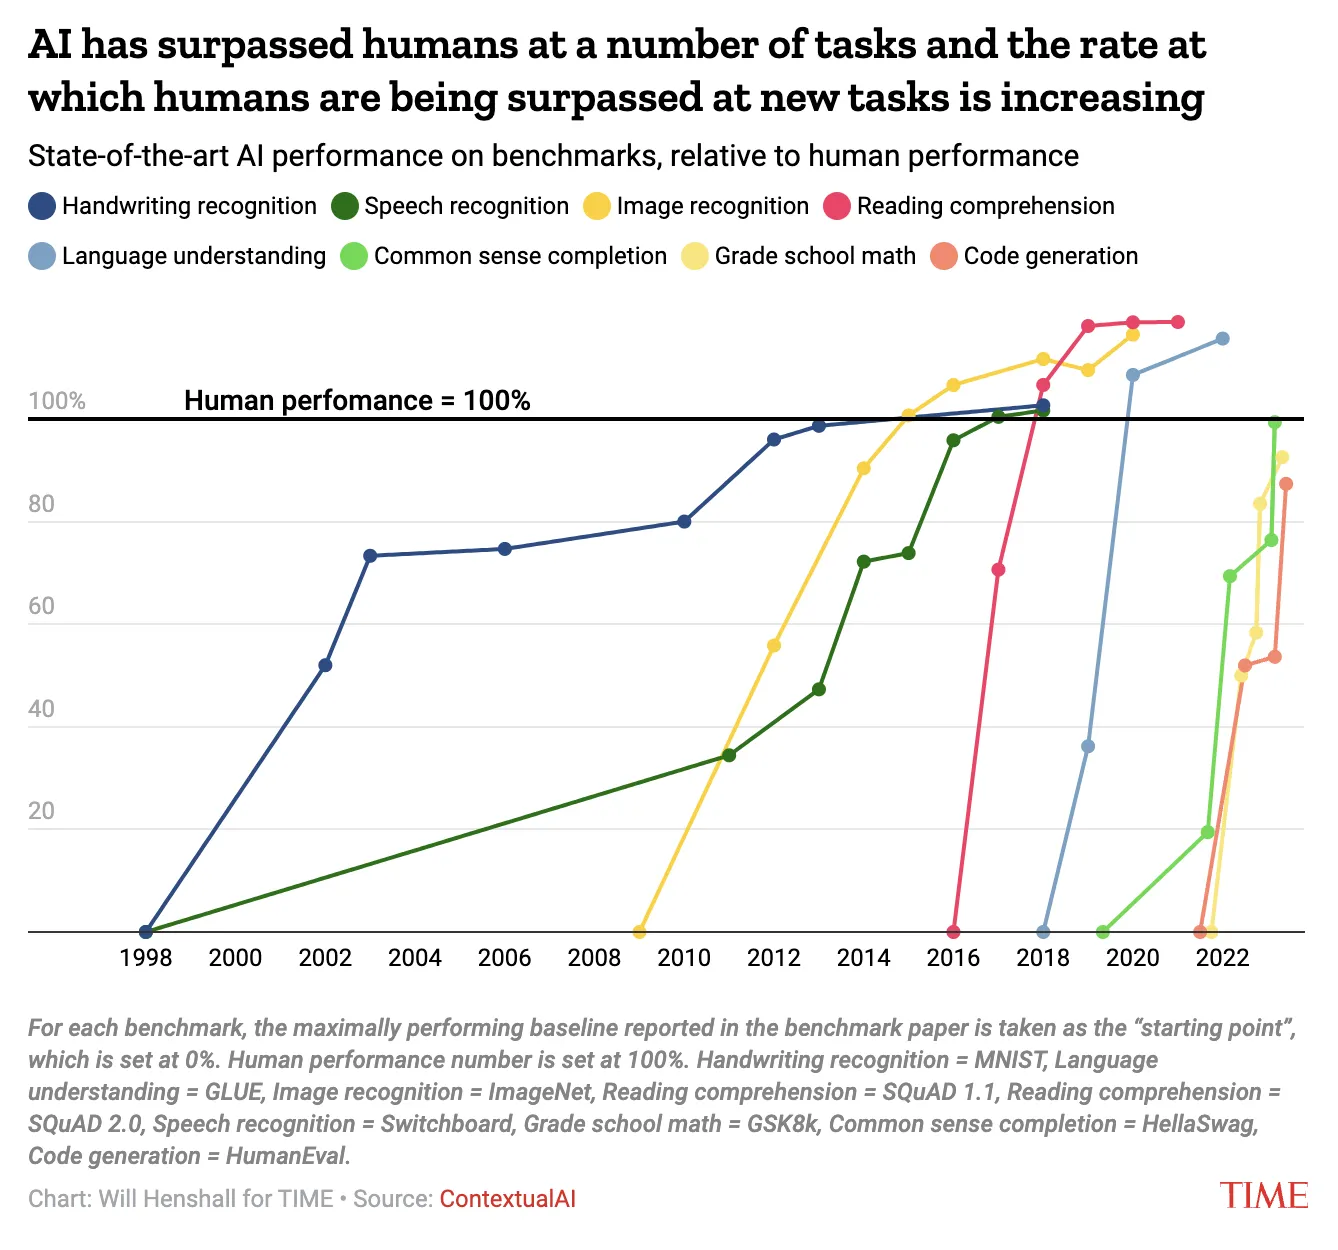
Скорость чтения ИИ значительно превосходит человеческую: за считанные минуты он может сравнить цены по всему Интернету и даже оформить заказ, не просматривая ни одной рекламы. Это означает, что сайт несёт расходы на эксплуатацию серверов, но не получает никаких доходов.
Одновременно ИИ-поисковые сервисы продолжают отбирать у сайтов трафик. После того как Google добавил в верхнюю часть выдачи блок «умных сводок» ИИ, лишь 8 % пользователей кликают на исходные веб-страницы, а объём трафика, направляемого сайтам контента через Google, снизился на 33 %. За год после запуска функции число её активных пользователей превысило миллиард, а количество поисковых запросов растёт вдвое каждый квартал.
Наверняка многие помнят образовательную платформу Chegg. Ранее она доминировала в сфере помощи студентам благодаря высоким позициям в поисковой выдаче, но теперь официально закрыла раздел вопросов и ответов, прямо указав на ChatGPT как на главную причину своего банкротства. Контент-производители оказались в ситуации «клещей»: с одной стороны — бесконтрольное сканирование их сайтов ботами, с другой — ИИ-сводки перехватывают трафик ещё до того, как пользователь дойдёт до сайта.
Разрыв в объёмах данных просто шокирует: для каждого перехода на партнёрский сайт, генерируемого роботом OpenAI, предварительно сканируется 400 страниц; у Anthropic соотношение составляет 38 000 : 1. Эти компании бесплатно используют открытые данные всей Сети для обучения своих моделей ИИ, а затем своими готовыми продуктами отбирают у сайтов тот самый трафик, который ранее приносил им доход.
В других отраслях подобное хищническое сбор данных давно вызвал бы десятки исков, однако в сфере ИИ такие компании получают оценки в триллионы долларов.
Ваше тело — новый пароль
На протяжении последних 25 лет Интернет в основном полагался на CAPTCHA (системы проверки «человек-не-робот») для различения людей и машин. Пользователи должны были распознавать дорожные знаки или вводить искажённые символы. Эта система работала, поскольку в прошлом распознавание изображений машинами было намного хуже, чем у людей.
Сегодня ситуация кардинально изменилась. Интеллектуальные агенты OpenAI получают в системе Google reCAPTCHA оценку «человечность», превышающую показатели реальных людей: они точно кликают по интерфейсу и копируют-вставляют содержимое; сгенерированные ИИ фотографии могут обмануть системы верификации личности, а глубокие фейки видеосвязи уже использовались мошенниками для перевода денег в банке. Исходное предположение традиционных механизмов проверки — слабость машин по сравнению с людьми — утратило силу.
Отрасль вынуждена сосредоточиться на тех областях, которые пока недоступны для имитации ИИ: поведенческие биометрические характеристики человека при взаимодействии с электронными устройствами. Компании IBM, BioCatch и другие разрабатывают соответствующие системы, которые не только верифицируют личность при входе, но и непрерывно отслеживают поведение пользователя, собирая такие параметры, как скорость перемещения курсора, стиль прокрутки страниц, ритм набора текста, сила нажатия клавиш, привычки редактирования текста, угол удержания смартфона и т.д.; гироскоп смартфона постоянно регистрирует эти данные.
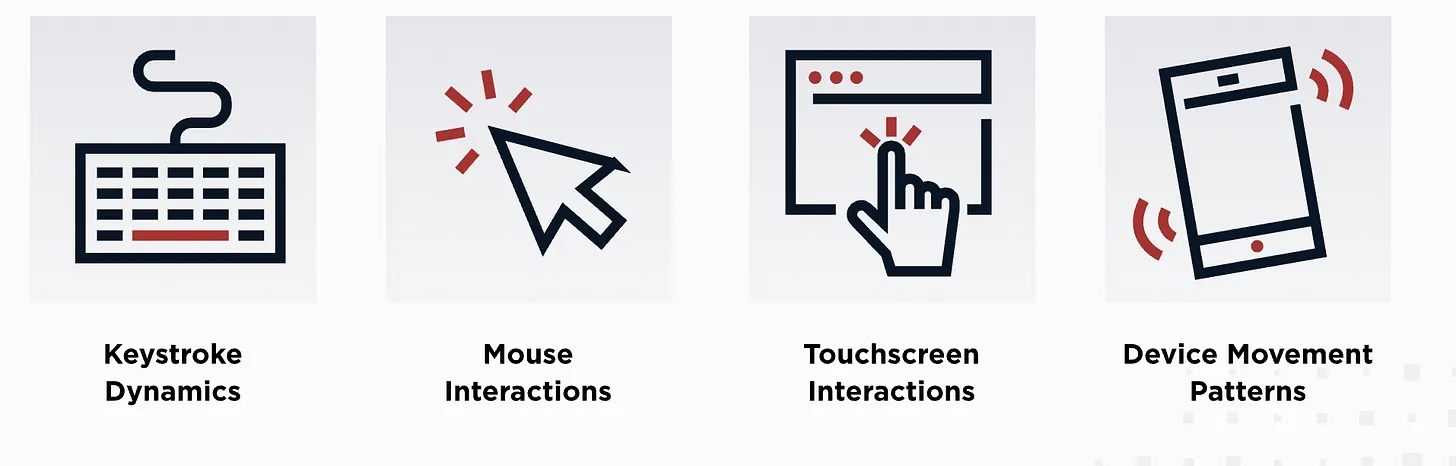
Система также способна распознавать ведущую руку пользователя и траекторию движения пальца по экрану. IBM формирует уникальный поведенческий профиль пользователя всего за восемь сеансов использования, после чего в режиме реального времени сравнивает каждое действие пользователя с эталонным профилем.
Технология BioCatch даже позволяет выявлять случаи мошенничества в Интернете. Когда жертва, следуя инструкциям мошенника по телефону, вслух называет свои учётные данные, система точно фиксирует нервный, прерывистый ритм набора текста. За один год эта система помогла 257 банкам выявить около двух миллионов счетов, используемых для отмывания денег. Сейчас Европейский союз начал пилотный проект по распознаванию походки. Всего за три года существования эпохи ИИ-агентов пограничные службы ЕС уже начали собирать данные о манере ходьбы граждан.
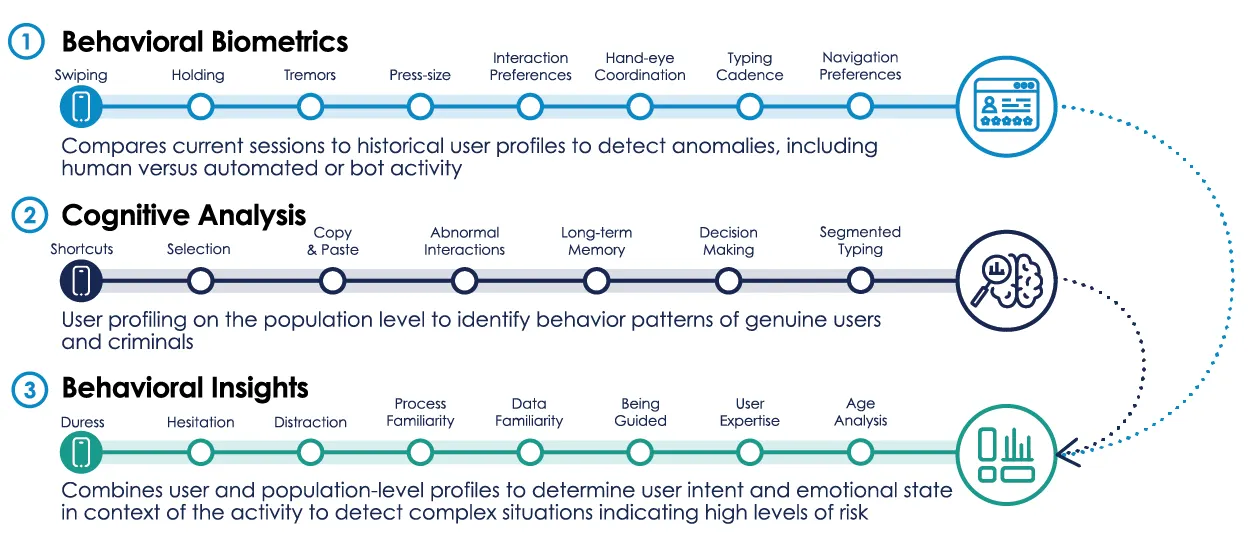
Исследования также используют эффект Струпа: когда слово «синий» написано зелёным цветом, человеческий мозг испытывает конфликт между смыслом слова и его визуальным восприятием, что замедляет реакцию; ИИ такой конфликт не затрагивает. Исследования показали, что это когнитивное замедление напрямую проявляется в ритме набора текста. Платформе даже не требуется специально задавать тестовые вопросы — достаточно анализа интервалов между нажатиями клавиш, чтобы определить, человек ли за терминалом: в привычках набора текста заложены уникальные особенности обработки информации человеческим мозгом.
Ранее цифровой трекинг фокусировался на регистрации действий пользователя: просмотр страниц, клики, покупки — всё это можно было скрыть с помощью блокировки cookie, использования VPN или отключения геолокации. Но поведенческая биометрия собирает врождённые физиологические особенности: способ движения курсора и ритм набора текста практически невозможно намеренно изменить.
Поведенческие характеристики каждого человека уникальны, как отпечатки пальцев. В отличие от паролей или криптографических ключей, такой «биометрический профиль» нельзя сменить или сбросить. При масштабном внедрении этой технологии все платформы будут вынуждены адаптироваться. Сегодня технологии синтеза голоса уже позволяют вести телефонные разговоры, неотличимые от живых, а технологии глубоких фейков видео быстро догоняют их. Если это действительно будущее, возникает ключевой вопрос: кто будет контролировать эти биометрические данные?
Кто будет контролировать систему верификации людей
Сейчас отрасль разделилась на два лагеря, исследующих различные подходы к верификации реальной человеческой личности.
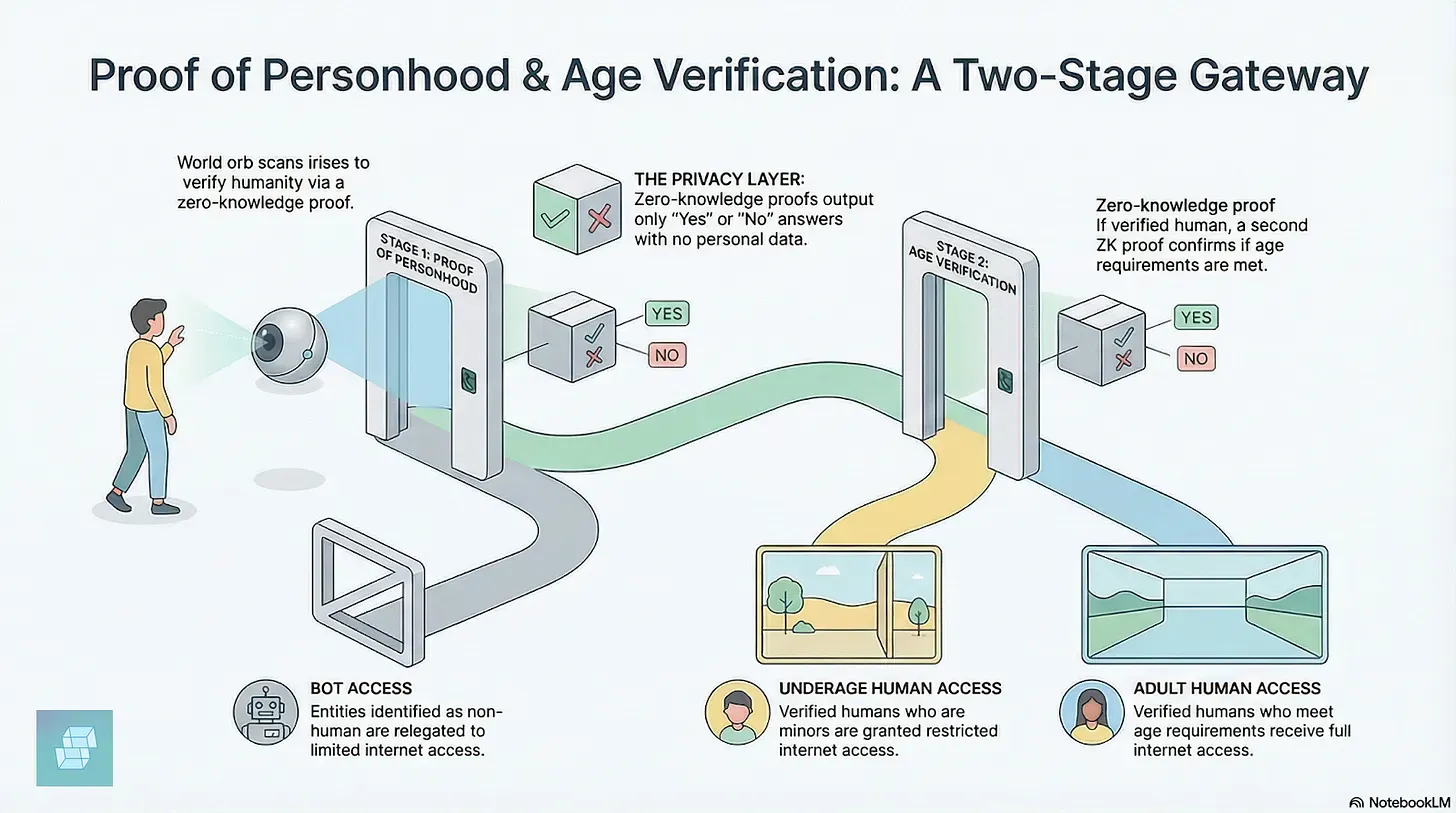
Первый — проект World (ранее Worldcoin) Сэма Олтмана. Пользователь должен подойти к сферическому устройству сканирования радужной оболочки глаза, которое собирает биометрические данные и генерирует зашифрованный сертификат, подтверждающий, что владелец — уникальный физический человек. На сегодняшний день регистрация радужной оболочки завершена у 18 млн человек в 160 странах мира. В апреле 2026 года World заключил соглашения о верификации пользователей с сервисом знакомств Tinder, платформой видеоконференций Zoom и сервисом электронных подписей DocuSign; также совместно с Coinbase был запущен инструмент AgentKit, позволяющий связать ИИ-агента пользователя с его реальной личностью — таким образом платформа может удостовериться, что за ИИ стоит реальный человек, не раскрывая при этом личные данные пользователя.
Однако технология сканирования радужной оболочки запрещена законом во многих странах. Граждане не осведомлены о потенциальных рисках, связанных с предоставлением биометрических данных, — именно поэтому власти этих стран выступают против данной технологии. Исследование MIT Technology Review выявило, что World без надлежащего согласия пользователей, помимо сканирования радужной оболочки, незаконно собирал также частоту сердечных сокращений, дыхательный ритм и другие жизненно важные показатели.
Второй подход основан на криптографии и использует протоколы нулевого разглашения (zero-knowledge proofs), позволяющие доказать, что вы — человек, не раскрывая при этом вашей личности, местоположения или внешности. Виталик Бутерин предложил эту идею ещё в 2023 году. Он считает, что без децентрализованной системы подтверждения человеческой личности Интернет в конечном счёте окажется под централизованным контролем над идентичностями. Как только право на верификацию личности окажется в руках корпораций или государства, механизмы слежки станут фундаментальной частью сетевой инфраструктуры.
Децентрализованные системы верификации человеческой личности уже пытались внедрить в масштабе, но все попытки закончились неудачей. Idena была одним из первых проектов, ориентированных на принцип «один человек — одна учётная запись». Всего за два года после запуска 40 % всех учётных записей и 48 % всех наград были сконцентрированы в руках 23 организаций. В Индии и России команды операторов аккаунтов нанимали обычных людей за зарплату менее доллара в час, чтобы те «арендовали» свои личные данные, получая прибыль до 55-кратной от вложений. Исследователи также обнаружили, что детские персональные данные использовались в качестве «подставных» аккаунтов.
Виталик заранее предвидел такие риски. Он отметил, что самая дешёвая атака на любую систему верификации человеческой личности — это не глубокие фейки или высокотехнологичный хакинг, а простая покупка доступа к личным данным бедных людей. Любая система верификации требует финансирования: оборудование для сканирования радужной оболочки, узлы проверки в блокчейне — всё это требует постоянных затрат.
Однако как только цифровые идентификаторы приобретут экономическую ценность, немедленно возникнет чёрный рынок аренды личностей. В мире с колоссальным неравенством богатых и бедных капитал всегда будет доминировать на таких рынках.
«Принудительное внедрение правила „один человек — один голос“ в системе с реальными экономическими стимулами неизбежно повторит ошибки социальных экспериментов XX века».
Объективно оба пути развития имеют явные недостатки. Централизованный подход обеспечивает масштабируемость и быстрое внедрение, но биометрические данные пользователей оказываются в руках компаний, склонных к чрезмерному сбору информации, а сами эти компании, в свою очередь, получают выгоду от массового распространения роботов. Криптографический путь теоретически обеспечивает конфиденциальность, но не способен преодолеть экономическое неравенство в реальном мире и, как следствие, становится лазейкой для серых схем.
Если бы мне пришлось сделать ставку, я бы выбрал криптографический путь. Ведь поведенческая биометрия и централизованное сканирование радужной оболочки навсегда фиксируют ваши телесные данные, права на которые принадлежат тем, кто развернул данную систему. Как только они получат доступ к вашим данным, вы не сможете их удалить или перенести — информация останется навсегда в руках той компании, которая её собрала.
Даже если известно, что протоколы нулевого разглашения могут быть обойдены, их разработка остаётся необходимой, поскольку они позволяют подтвердить, что вы — человек, не раскрывая при этом никакой дополнительной информации. Иначе, отказавшись от этого пути, мы обречём себя на то, что при каждом посещении любого сайта наши поведенческие данные будут сохраняться. Сегодня централизованные системы с элементами слежки уже внедряются гораздо быстрее, чем криптографические решения.
Присоединяйтесь к официальному сообществу TechFlow
Telegram:https://t.me/TechFlowDaily
X (Twitter):https://x.com/TechFlowPost
X (Twitter) EN:https://x.com/BlockFlow_News










